
前言
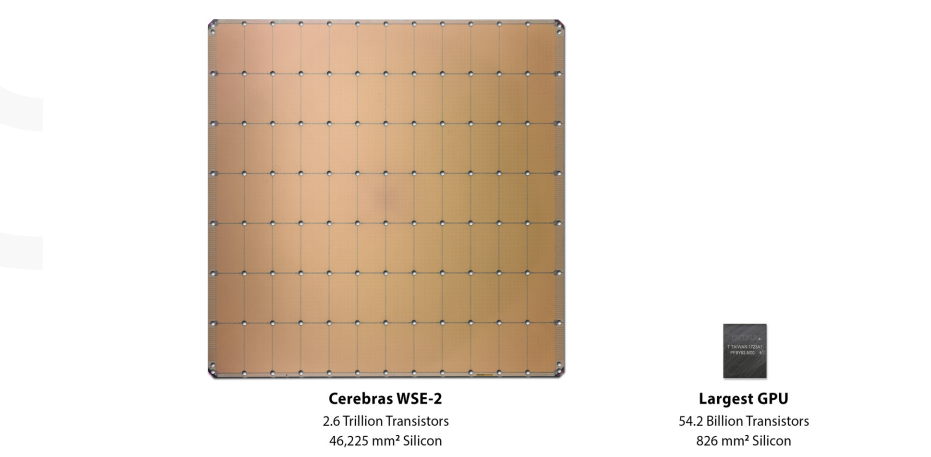
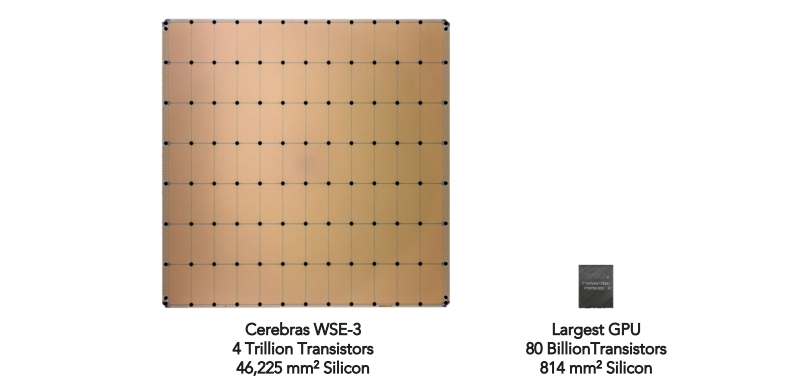
Cerebras使用整个晶圆制造一个巨大的芯片WSE - Wafer Scale Engine,可以从下图中直观的感受到WSE和其他芯片在晶体管数量上的差异:
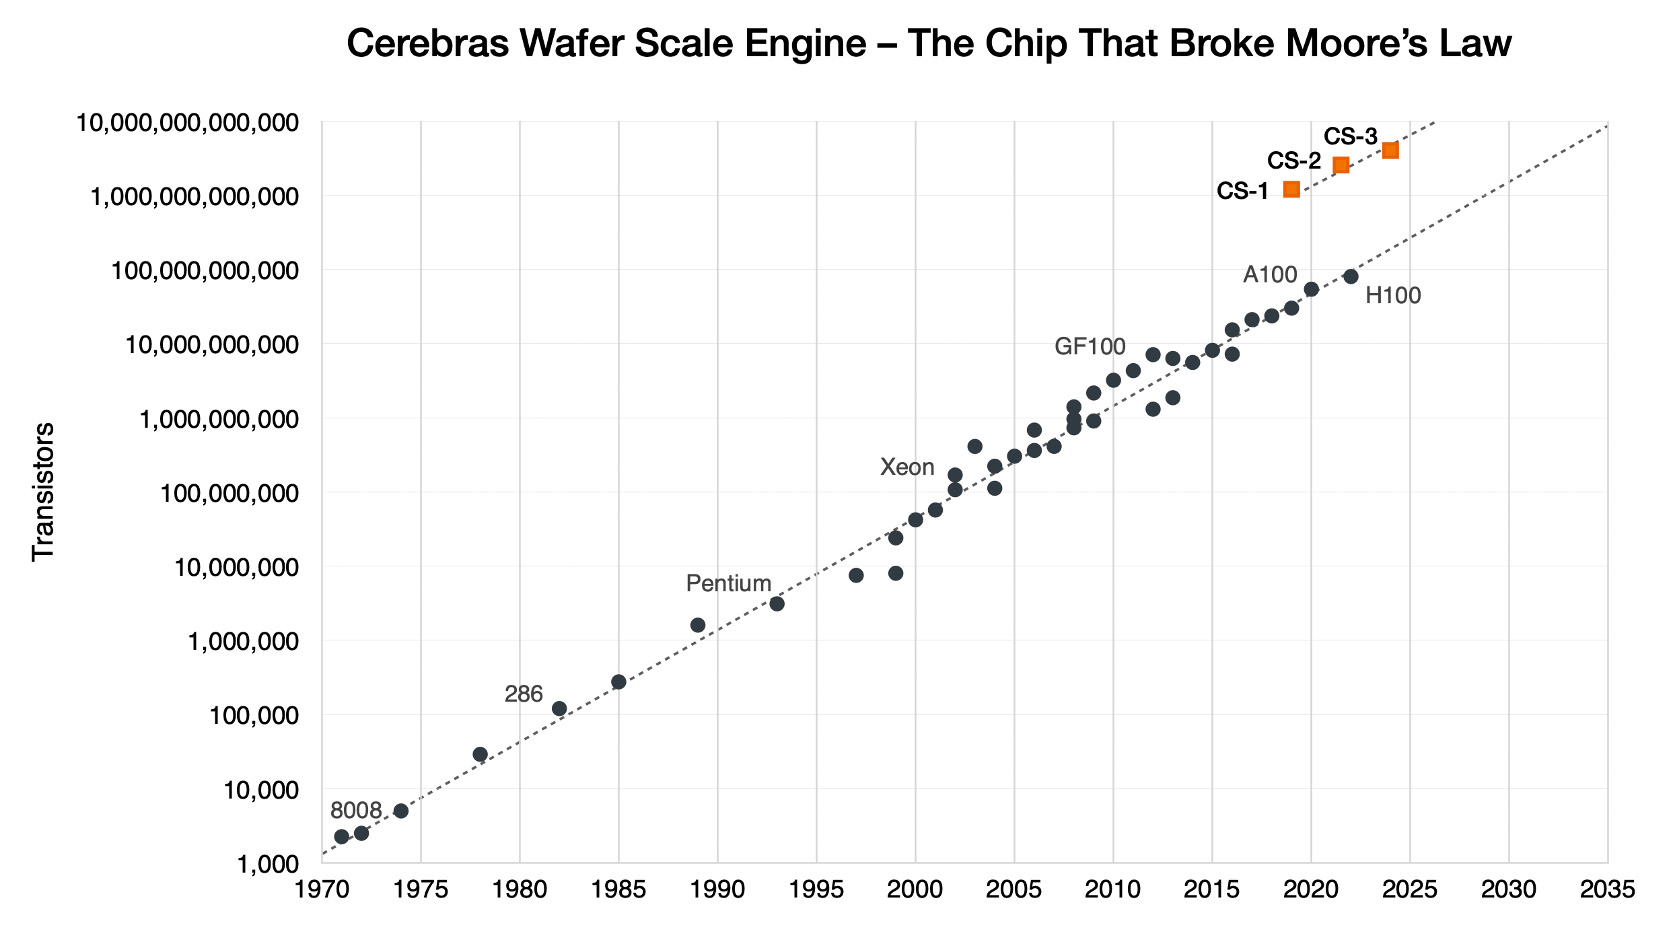
Cerebras的WSE通过将wafer 作为一个芯片,获得了巨大的片上访存带宽,但同时也导致系统供电,芯片良率等复杂问题,本文针对这些问题,从Cerebras第一代WSE1的系统结构,WSE2的计算架构和系统设计,WSE3系统设计到第四代系统CS-4来讲解分析。具体章节安排如下:
- 第一章简单介绍采用Wafer Scale的一些背景
- 第二章介绍WSE1的系统设计和编译流程
- 第三章通过WSE2来介绍芯片内部计算架构和CS2
- 第四章介绍WSE3芯片及系统CS3
- 第四章介绍CS4
概述
一般而言,每一代芯片的性能提升会被归类于架构上的优化,但实际上,工艺进步,时钟频率,芯片面积等都会对芯片性能产生影响,过去五十年来对芯片性能提升的相对贡献如图所示:
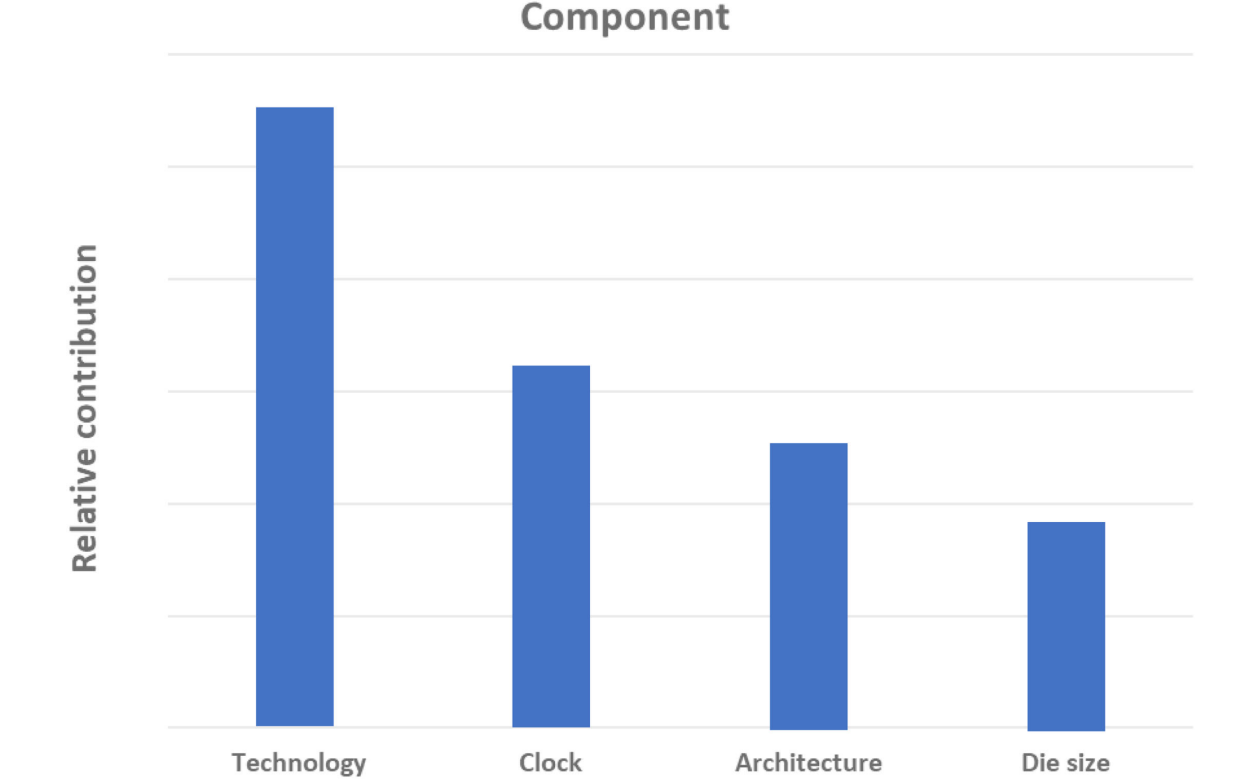 可以看到工艺进步对性能影响其实是远远超过其他因素。芯片面积增加,为所需功能的晶体管数量提供了更多的硅面积。在当前技术下,存在一个最大尺寸限制。下图显示了一些比较有影响力的芯片面积增加的趋势曲线。
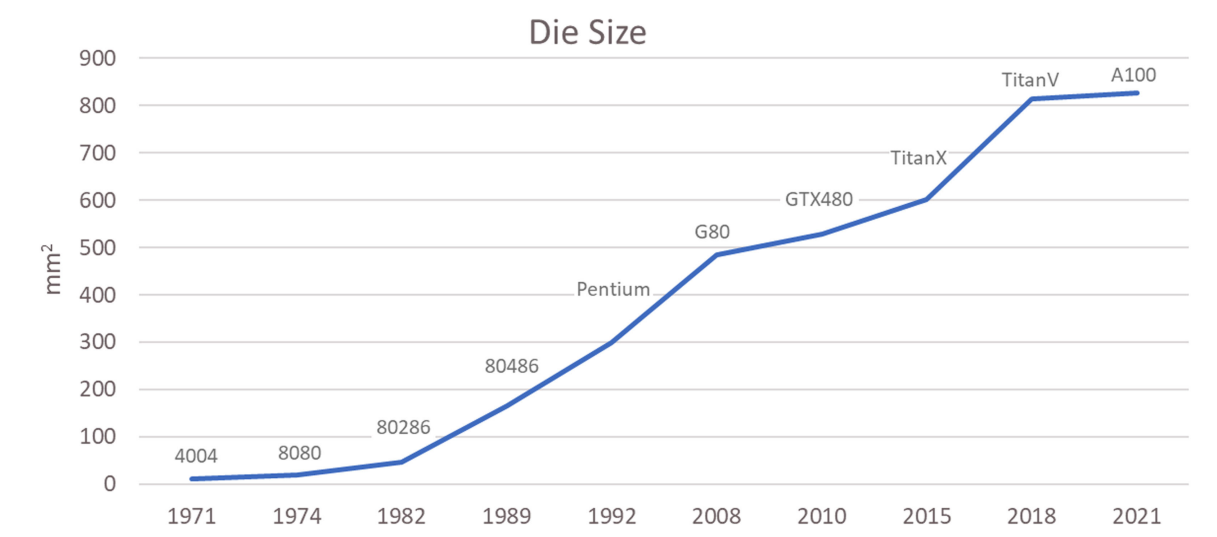 芯片尺寸增长放缓的原因包括:
- 随着工艺进步,增加光罩尺寸(即晶圆的最大面积)变得更加困难,因为减少激光波长的同时维护激光聚焦在更大的区域越来越困难。这是芯片尺寸增长放缓的主要原因。
- 随着芯片尺寸的增加,每个芯片的良率会降低。虽然有几种不同的缺陷分布模型——例如,墨菲模型、泊松模型、二项式模型、摩尔模型和 Seeds 模型 - 所有模型的共同点是,随着芯片尺寸的增加,良率呈指数级下降。虽然将芯片尺寸扩展到整个晶圆可以最大限度地提高计算和带宽,但是良率模型基本上是零良率,因为无缺陷晶圆是极其罕见的事件。晶圆级设计是一个非常具有挑战的任务。
业界在此之前有过多次尝试:
- 1980 年,Trilogy Systems 尝试使用晶圆级集成(WSI)构建与 IBM 兼容的大型机,生产 2.5 英寸 (in) 的单芯片。Trilogy Systems遇到了几个障碍,最终导致了这个早期晶圆级集成的努力失败。
- 2015 年,Cerebras Systems 开始设计晶圆级芯片,WSE于2019年首次推出,成功克服了光罩尺寸限制。
WSE-1
在2019年,Cerebras推出了其第一代晶圆级芯片Wafer Scale Engine,采用台积电16nm工艺,包含1.2T晶体管,面积46225平方毫米。与此同时,当时最大的GPU则是NVIDIA的V100,包含21.1B晶体管,面积815平方毫米,具体对比如下所示:
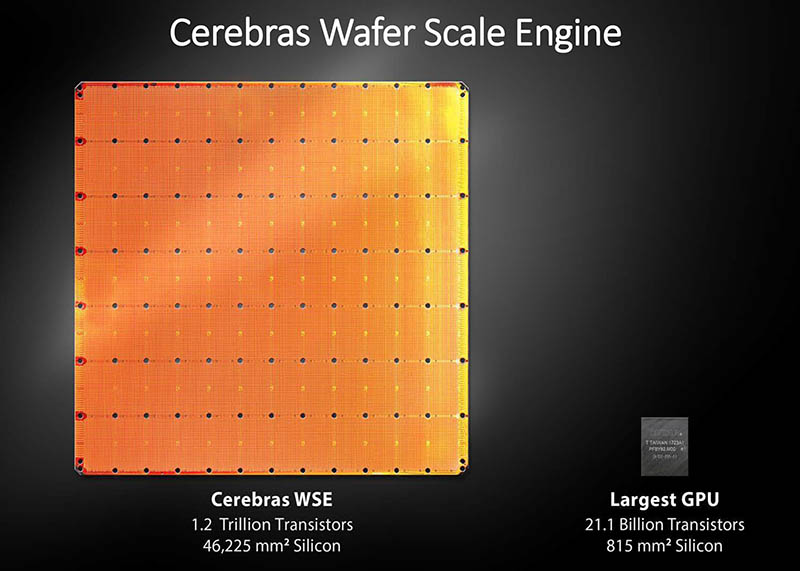 WSE-1一共有400,000 个AI 核心,芯片有 18GB 片上内存、9PB/s 内存带宽和超过 100Pb/s 的互连带宽。
Cerebras CS-1 Wafer-Scale AI System
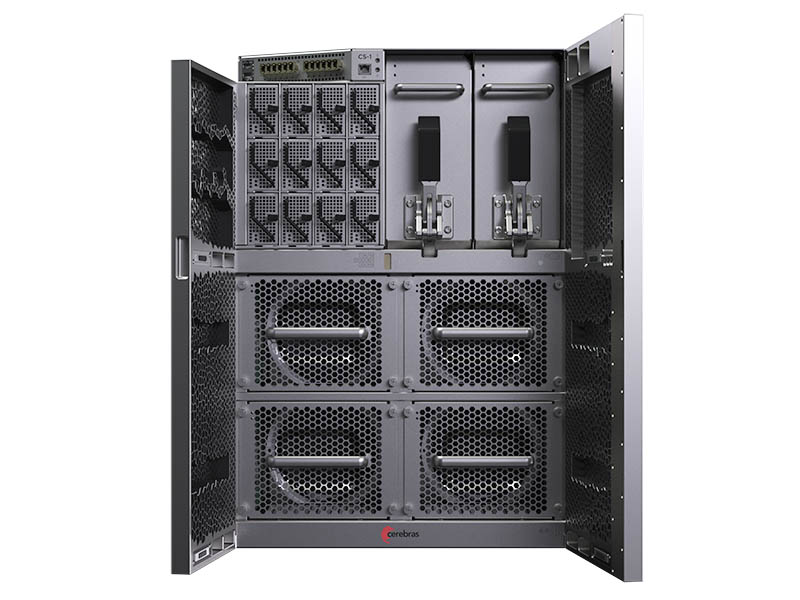
CS-1是由WSE-1组成的AI系统,前视图如下图所示,左上角是 I/O 模块,下方是 12 个电源。右边是泵模块,下面是风扇模块。有趣的是,CS-1前部的那些大门都是由一块铝制成的。
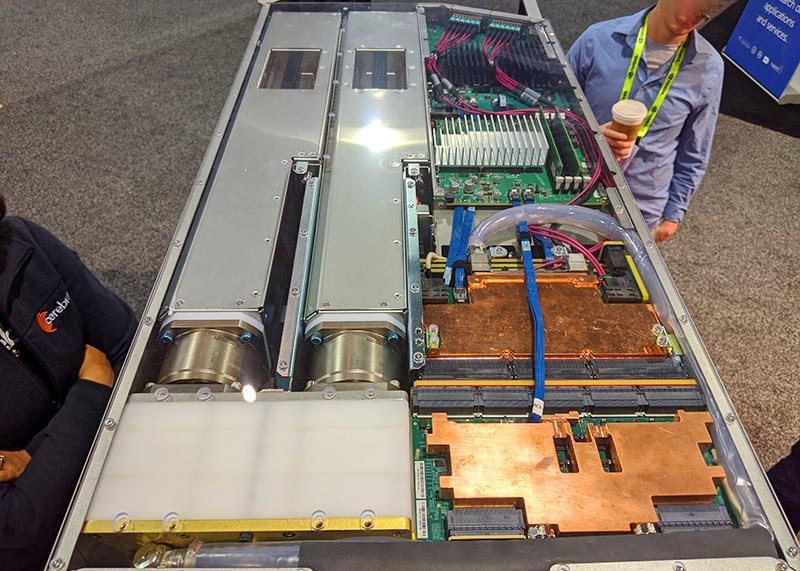
 在俯视图中,可以看到 12 个 100GbE 链路朝向 15U 机箱的前部。您还可以在左侧看到两个泵模块,它们有助于芯片保持冷却。
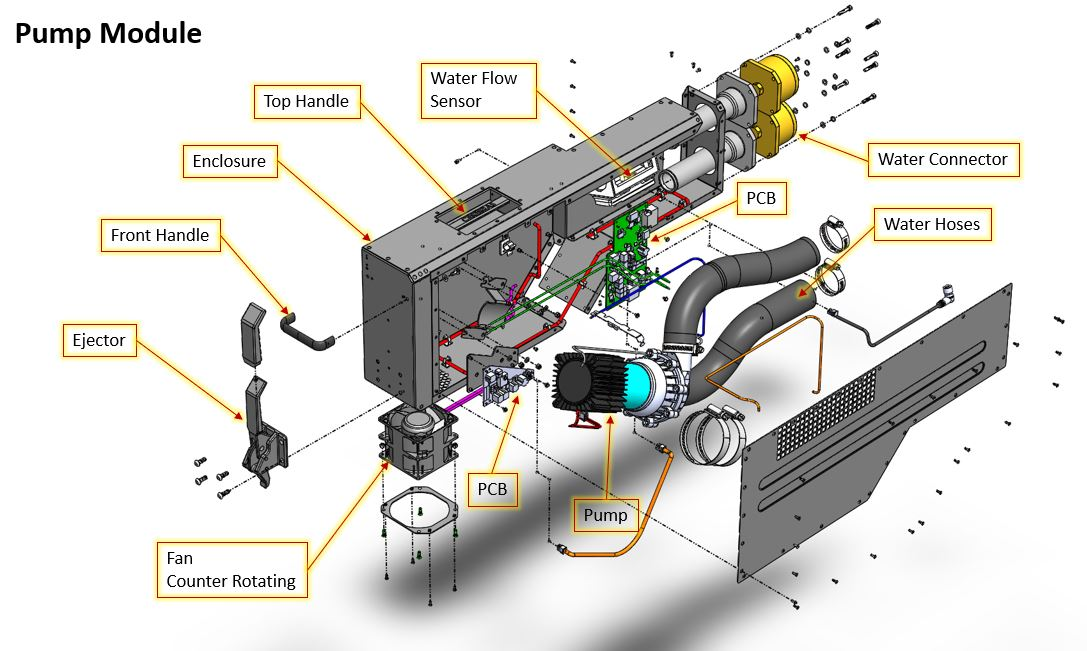
 以下是泵模块的机械结构:
每个 Cerebras CS-1 的设计功率高达 20kW。在 15U 机箱中,每 U 仅为 1.3kW/,或者大约是我们从 2U 4 节点服务器或 GPU 计算服务器中看到的功率。该系统利用 12 个 100GbE 连接提供高达 1.2Tbps 的外部带宽。
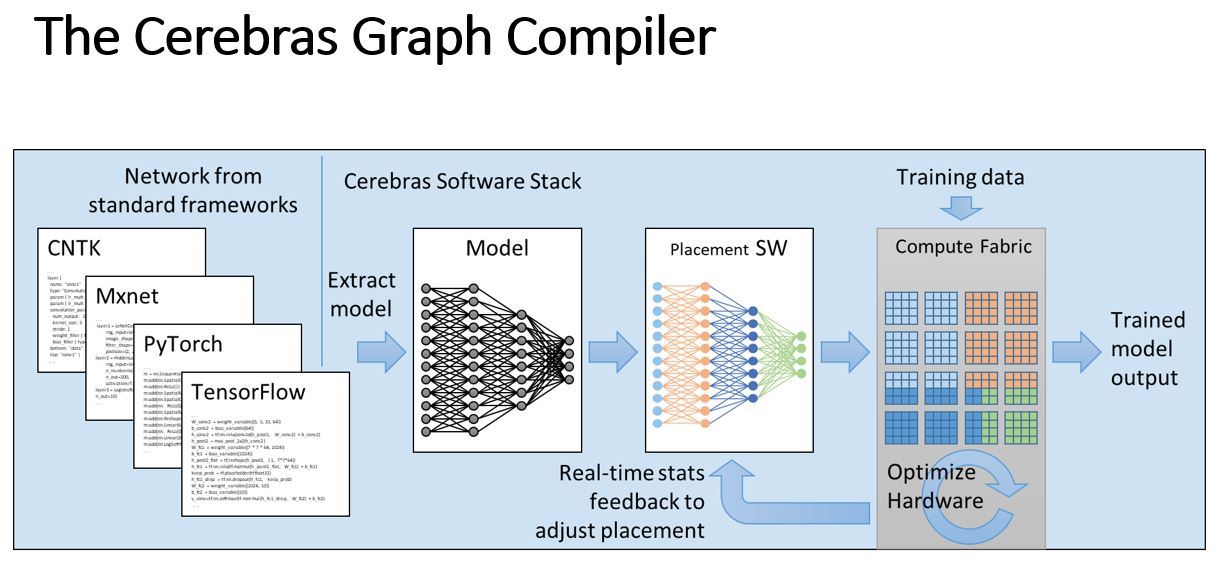
Cerebras 的软件堆栈支持从 Tensorflow 和 PyTorch 等高级框架到将模型编译到晶圆级芯片上并运行。
WSE-2
第二代 WSE-2 于 2021 年发布,面积 46,000 mm2,包含 2.6 万亿晶体管。一个晶圆级片上网络可连接 850,000 个内核,专为 ML 而设计。相比传统处理器,Cerebras 核心使用细粒度数据流来加速非结构化稀疏性,这使得它特别适合神经网络,因为ML通常具有自然稀疏性或可以被稀疏化。存储器是完全分布式静态随机存取存储器 (SRAM) 而不是动态存储器RAM (DRAM)。为了解决新兴的超大规模 ML 模型,Cerebras 架构使用片外结构扩展到CS-2系统。集群架构利用 CS-2扩展能力 ,以提供简单的数据并行扩展到更大的模型和更大的集群。
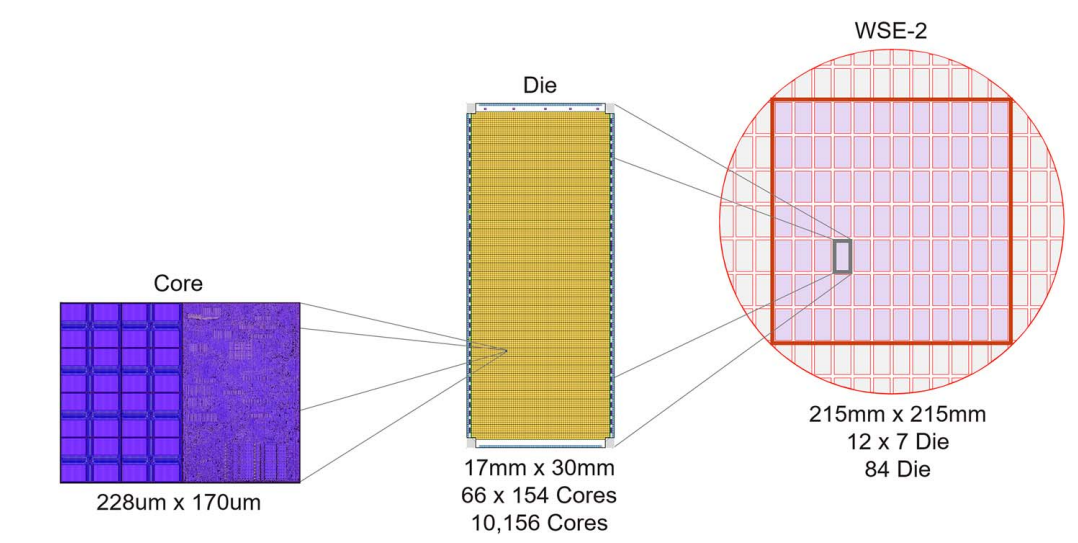
每个计算核的面积是38760平方微米,WSE-2首先设计一个有 10,000 个核的传统芯片,面积是510平方毫米。之后不进行切割,而是在直径300 毫米圆形晶圆内切割出最大的正方形。最终芯片总共有 84 个芯粒,有 850,000 个核。
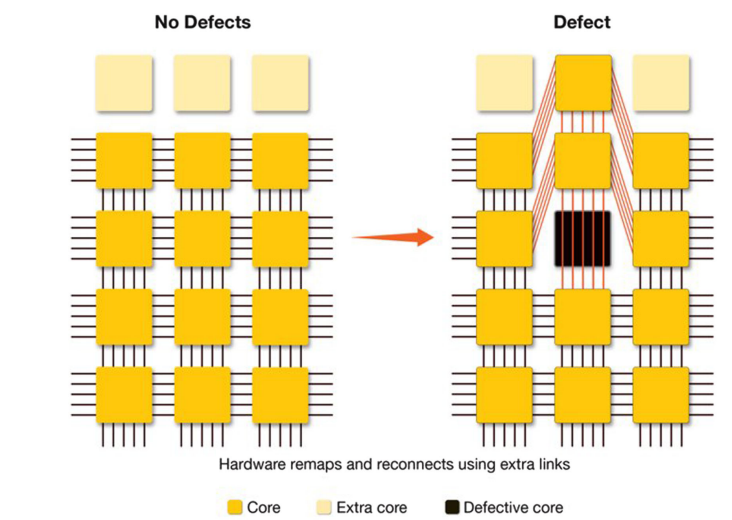
 不同于之前的 Trilogy 使用的冗余门设计,CereBras的冗余单元是PE;WSE-2中约1%的PE作为冗余备份,以便“修复”有缺陷的 PE。
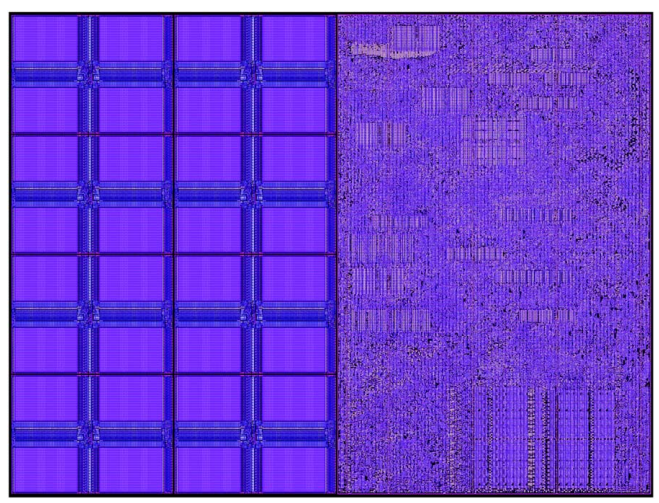
Cerebras 核是一个小核心设计,专为细粒度神经网络中的动态稀疏性。核心物理设计如图2所示。在TSMC 7nm工艺下面积约38,000 um2,一半的面积 48 kB 的SRAM。另一半是逻辑。整个内核以 1.1GHz 时钟频率运行,峰值功耗为 30mW。
 每个小核都有48 kB的本地SRAM,分成8个单端口bank,每个bank都是32位宽,每个周期可以支持 256 位访问;小核每个周期两个 64 位读和一个64 位写, 一共 192 位访问。所有的内存都是核内单独寻址,没有传统意义上的共享内存。所有核之间的共享是通过互联网络完成。除了本地SRAM,还有一个256B 软件管理的缓存,用于经常访问的数据结构。
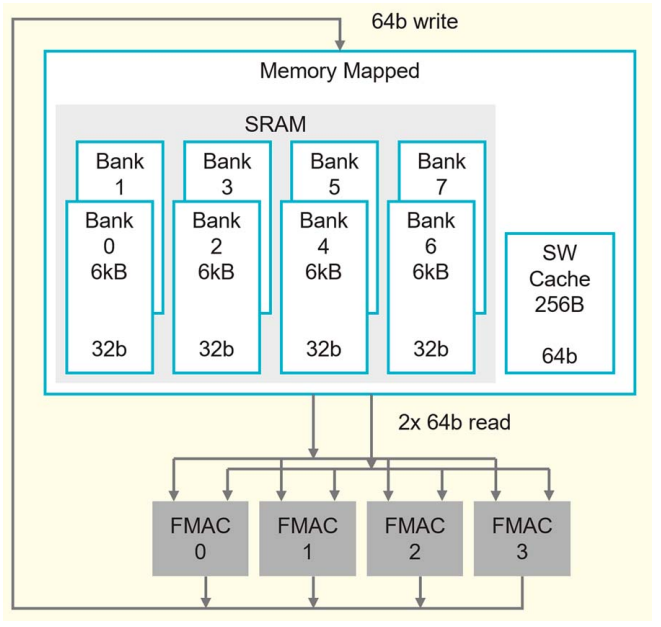 张量操作在 64 位数据路径上执行,由四个 16 位融合乘法累加组成(FMAC),支持FP16 和BF16,可选支持FP32。为了优化性能和灵活性,指令集架构将张量作为一等的操作数,类似通用寄存器或内存。下图显示了一个示例在 3D 和 2D 张量上操作的 FMAC 指令操作数。
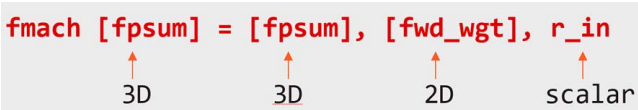 小核使用数据结构寄存器 (DSR) 作为指令的操作数,有 44 个DSR,每个 DSR 都包含一个描述符,其中包含指向张量和其他关键信息的指针,如张量的长度、形状和大小。利用DSR,硬件架构可以原生支持最多4D 张量。
小核同时支持八个张量操作,称为微线程,硬件上可以逐个周期切换。调度器持续监控正在处理的张量的输入和输出的可用性,选择一个符合条件且资源可用的微线程。每个微线程也分配了优先级,因此,如果多个微线程有资格运行,调度器将选择优先级更高的微线程。每个微线程都可以完全访问所有资源,包括核中的寄存器和内存,没有任何静态分区。
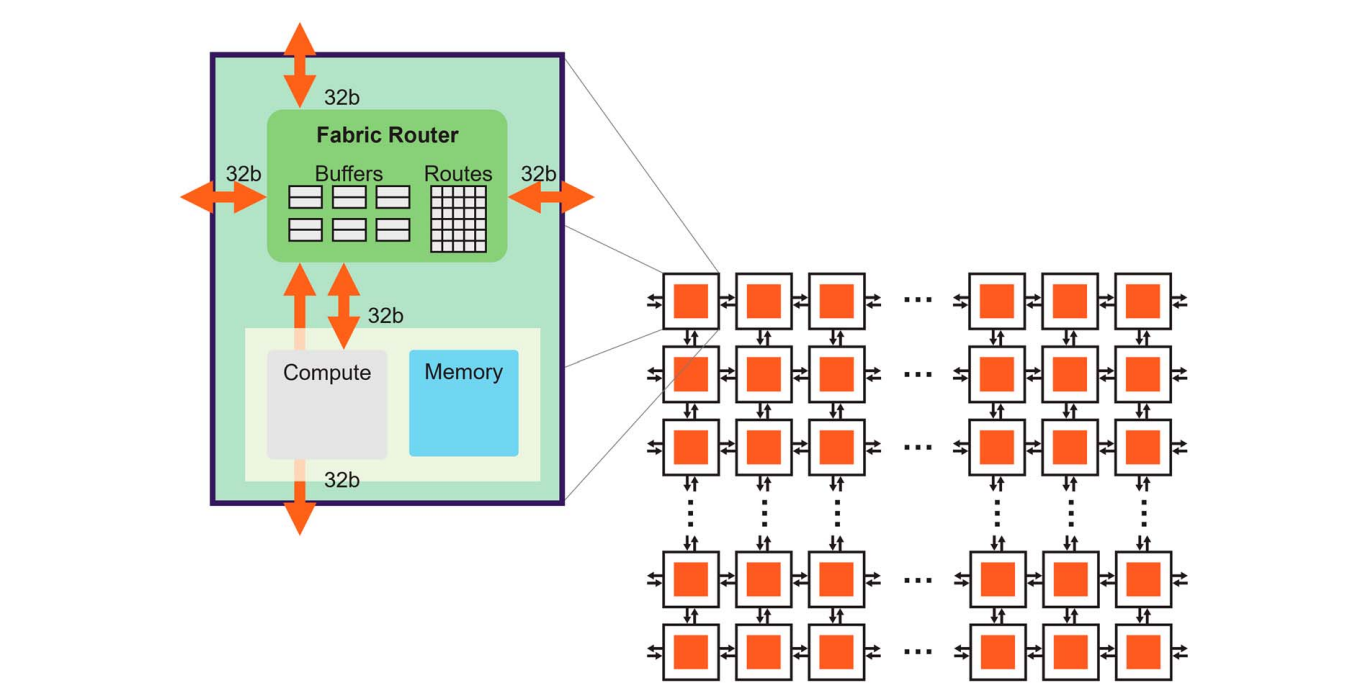
互联使用 2-D 网络拓扑,如下图所示。其中每个核有一个Fabric Router。Fabric Router采用的五端口设计,每个都是32 位双向接口;使用低缓冲的无损流量控制,实现核间的单时钟周期延迟。基本数据包是单个 16 位数据元素(FP16 或 BF16)。除了这些 16 位数据外,还有 16 位数据的控制信息,构成 32 位细粒度包。为了进一步优化结构设计,它使用完全静态的布线,效率高且低开销。每个内核有 24 个本地静态可以配置的路由,称为Color。所有Color之间是非阻塞的,通过时间多路复用到相同的物理链路上。在整个网络范围内,这些本地独立Color被组合在一起支持整个核心阵列大量路由。此外,还使用每种Color对于各种不同的数据和控制通信,因此固定的 24 种Color使更多不同消息或任务总数。最后,神经网络通信本身具有高度的扇出,因此每个交换矩阵路由器中设计有本机广播和组播功能
不同于传统的封装之后安装到PCB,向晶圆提供小于 1 V且接近 20,000 A 的峰值电流,同时保持良好的稳压是艰巨的挑战。Cerebras采用分布在晶圆表面的 300 多个单独的电压调节模块 (VRM),每个WSE-2使用多个 VRM 确保电源分配冗余,并可单独控制每个电源域。
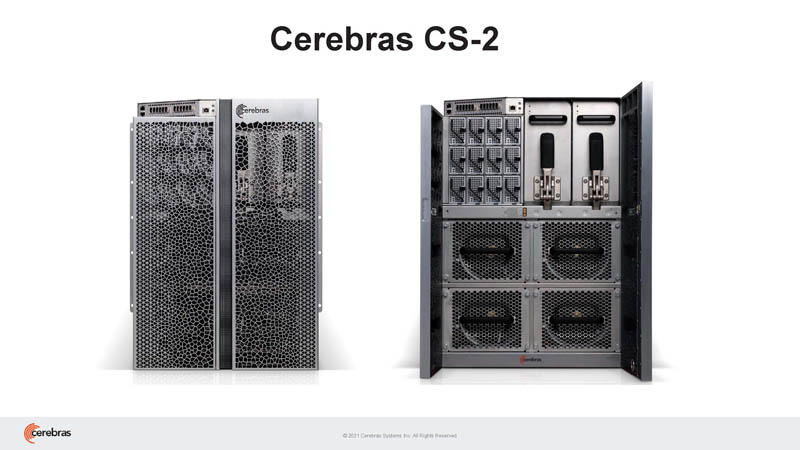 Cerebras 拥有一项新的 MemoryX 技术,有助于解决 CS-2 中超出 WSE-2 的内存容量问题。Cerebras CS-2 集群支持 1.5TB 和 12TB MemoryX 单元。MemoryX 技术专为支持大型神经网络执行而构建:
- 支持4TB-2.4PB容量
- 支持2000 亿 - 120 万亿个权重,带优化器状态
- 支持DRAM 和闪存混合存储
用于权重更新/优化器的内部计算,处理智能流水线以掩盖延迟,可扩展到极端模型大小,独立于计算的容量扩展
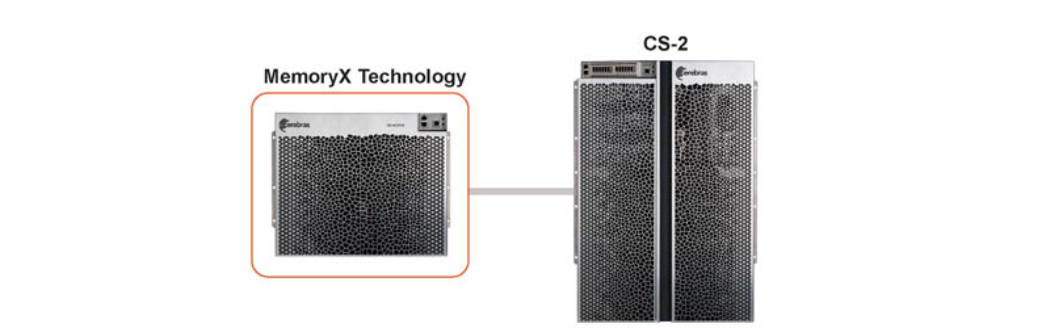
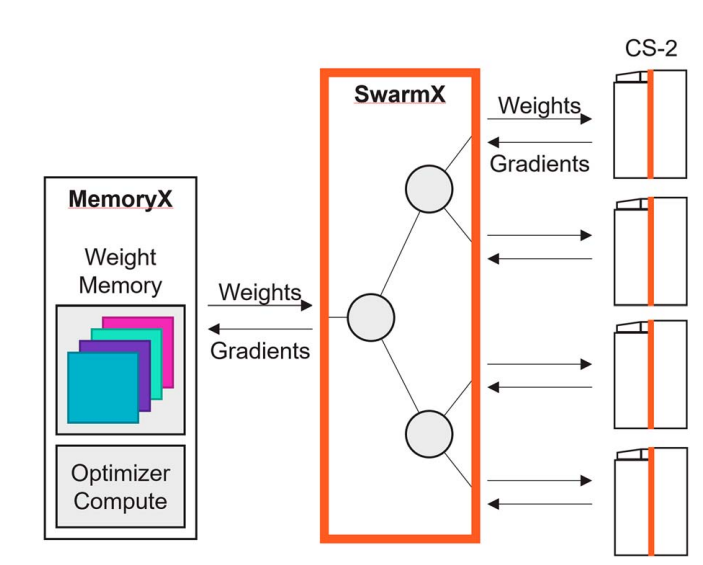
模型权重存储在称为 MemoryX的外部设备,权重流式传输到CS-2 系统,一次一层。权重存储在 MemoryX内部的DRAM 和SSD中,并以1.2 Tb/s的带宽流式传输到 CS-2 中;CS-2 依赖数据流机制进行计算,所以权重永远不会存储在 CS-2 系统上。
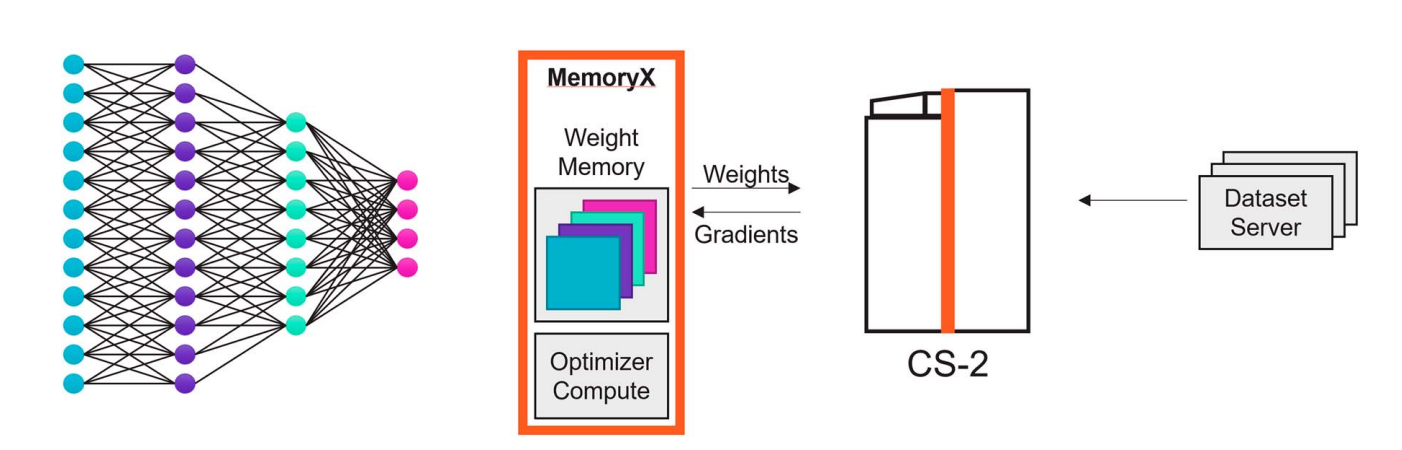 使用数据流调度,每个单独的权重将触发对片上存储的激活的AXPY 操作。一旦每个权重计算完成,就会被丢弃,而不会存储在芯片上,并移动到下一个权重。为了降低从MemoryX流式传输每个权重的成本,每个权重在 CS-2 上复用多次。在向后传递时,梯度以相反的方向流出并返回 MemoryX 单元,并更新权重。
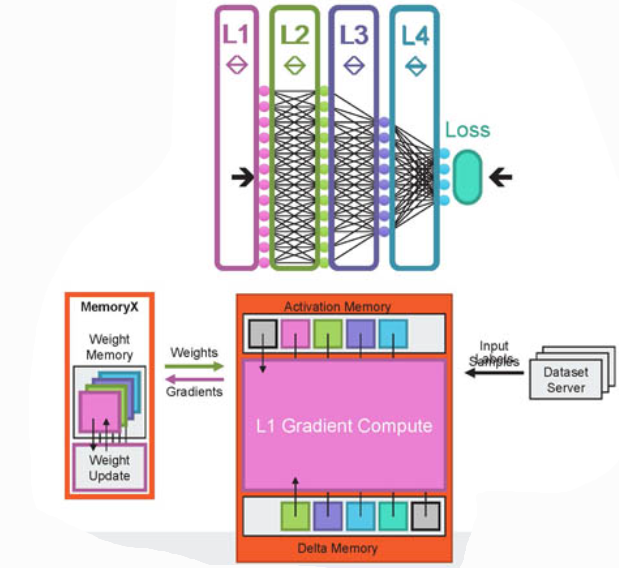 流式传输如此之多,计算资源如此之多,延迟可能是一个挑战,尤其是在更新期间。Cerebras 在这里给出了答案。
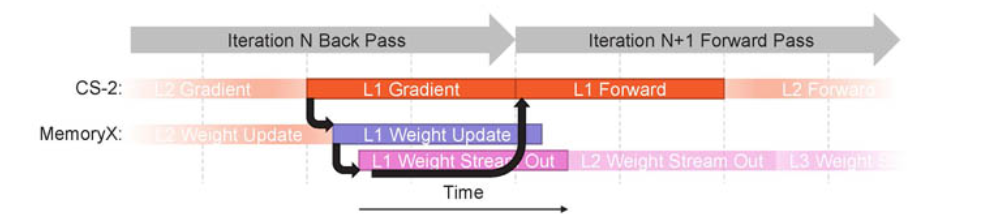 解决延迟问题
- 通过消除对延迟敏感的通信实现高效的性能扩展
- 粗粒度流水线
- 前向/增量/梯度是完全流水线的
- 迭代中的所有流都没有层间依赖关系
- 细粒度流水线
- 权重更新和前向传递的重叠涵盖了迭代间依赖关系
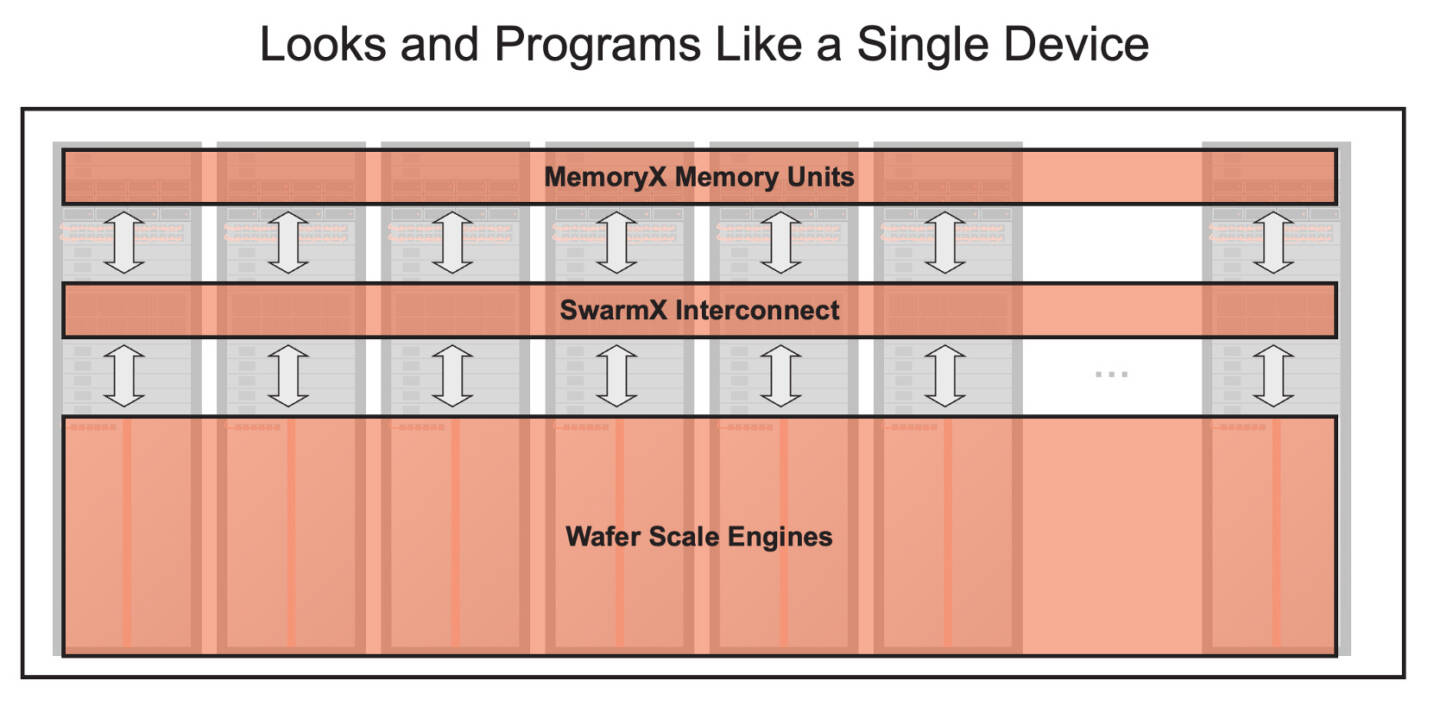
SwarmX Interconnect 是可横向扩展到多个系统的高速结构。在这里快速说明一下,看起来 SwarmX 上的光学器件几乎不可插拔并且有 12 个端口。这张图片几乎看起来像是将 MTP 光学器件直接插入交换机的面板。
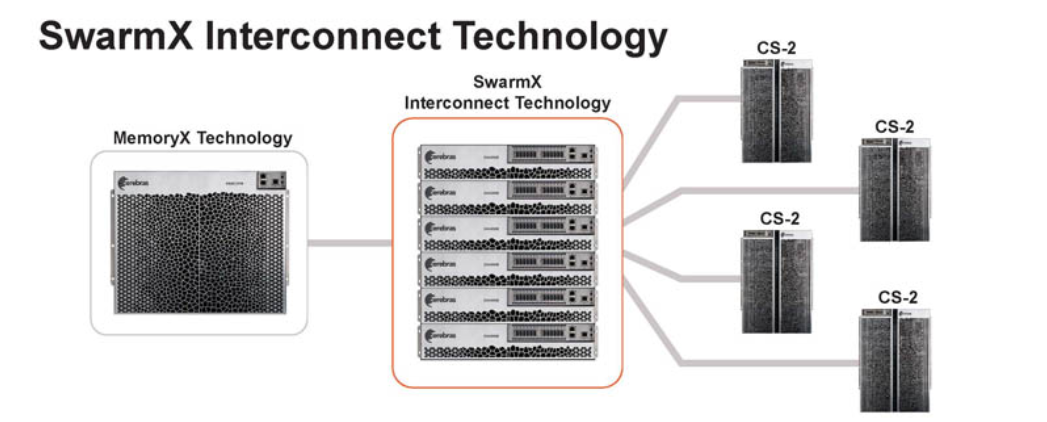 通过专门设计的称为 SwarmX的互连来实现数据并行横向扩展,如下图所示。SwarmX 位于存储权重的MemoryX 单元和用于计算的 CS-2 系统之间;SwarmX 将权重广播到所有 CS-2 系统,并对所有 CS-2 的梯度进行reduction。在内部,SwarmX 使用树形拓扑来支持模块化和低成本扩展。
WSE-3
WSE-3 比最大的GPU 大 57 倍,包含 4 万亿个晶体管、900,000 个 AI 优化计算核; 44 GB片上SRAM,可以提供21PB/s带宽。
Cerebras CS-3 Wafer Scale System
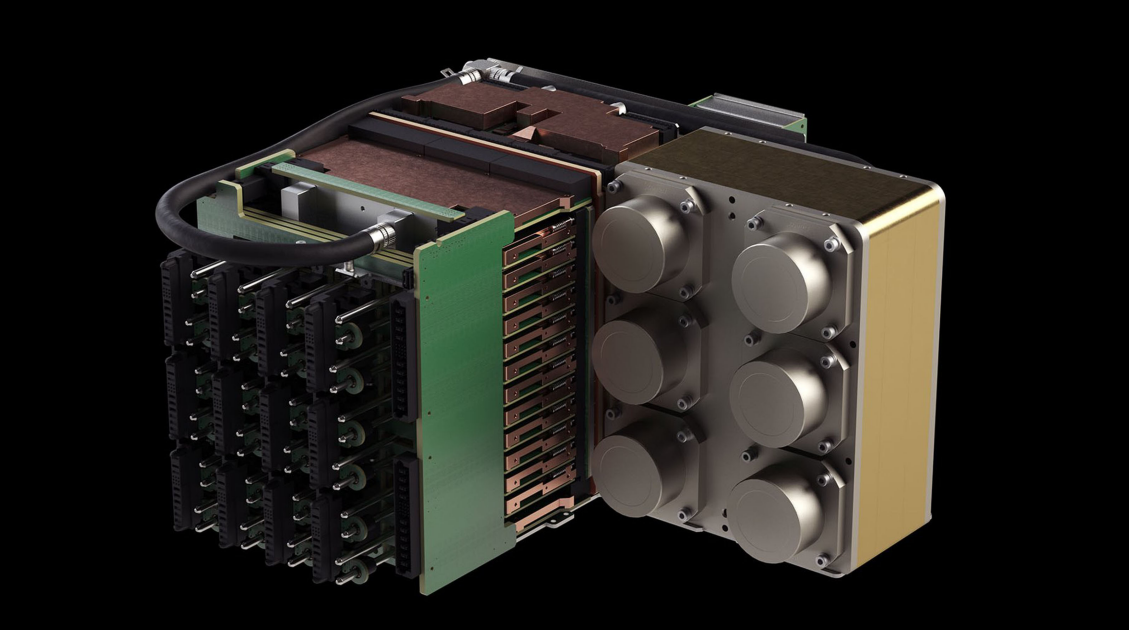
Cerebras CS-3 是第三代晶圆扩展系统。顶部有 MTP/MPO 光纤连接,以及用于冷却的电源、风扇和冗余泵。
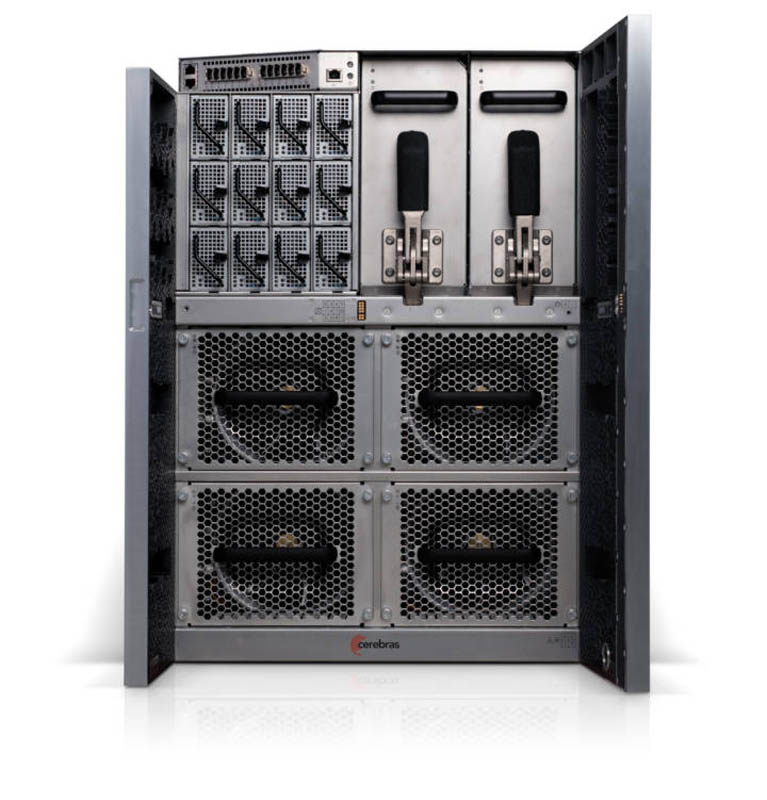 Cerebras 需要为巨型芯片提供电力、数据和冷却,同时还需要管理相对较大的区域的热膨胀等事情。这是该公司的又一大工程胜利。在内部,芯片是液冷的,热量可以通过风扇或设施水带走。
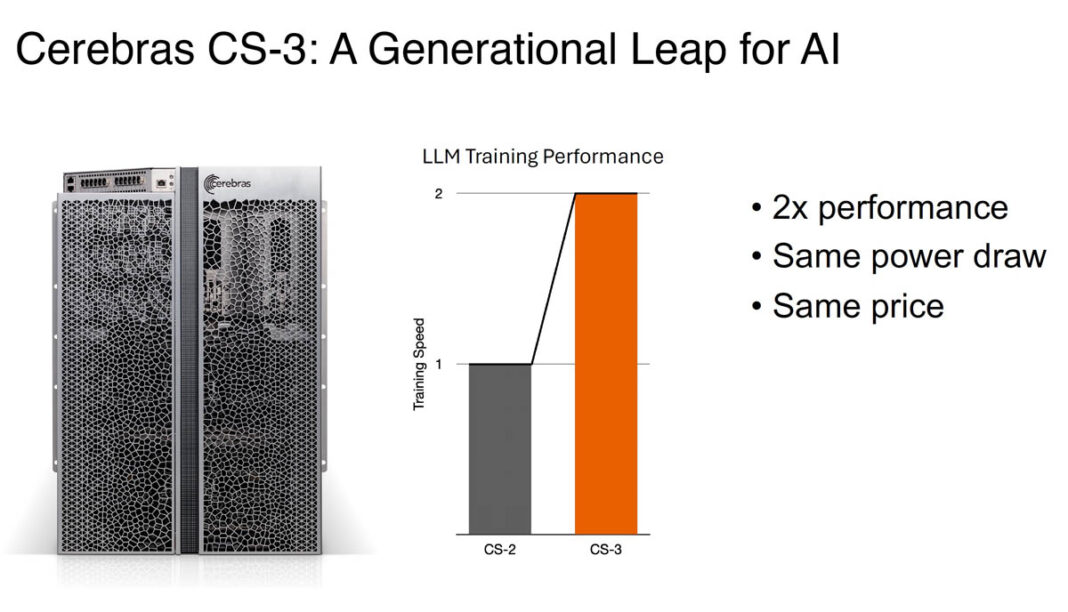
该系统及其新芯片在相同的功率和价格下实现了大约 2 倍的性能飞跃。Cerebras 从每个工艺步骤中都获得了巨大的优势,从第一代的 16nm 到今天的 5nm。
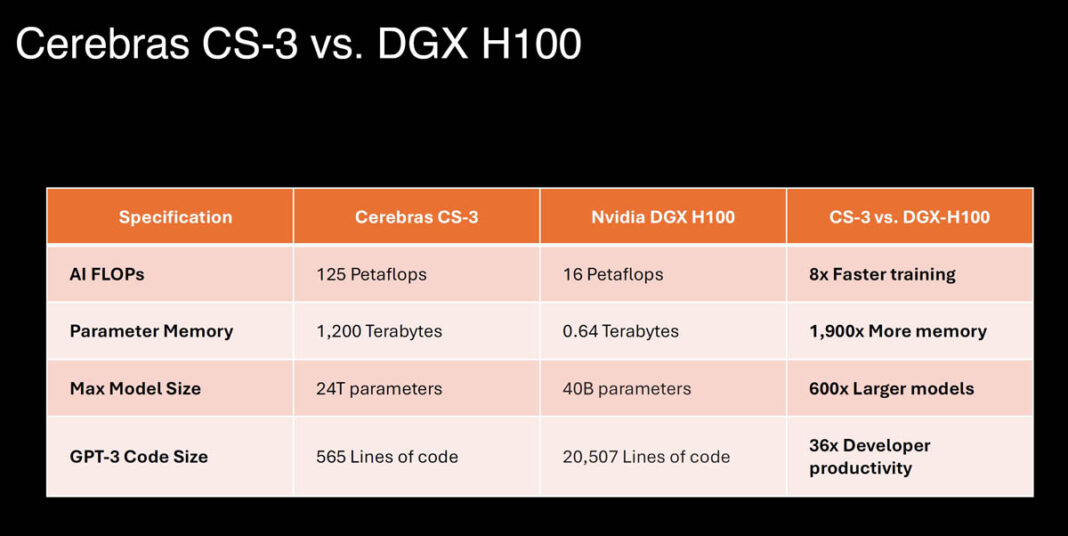
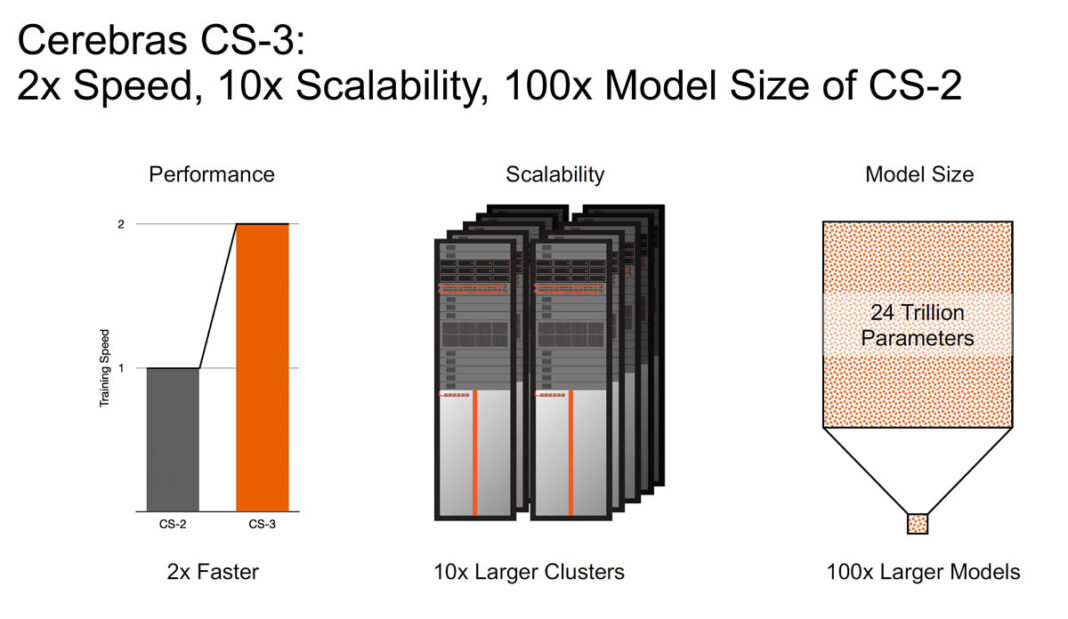 与具有八个 NVIDIA H100 GPU 和内部 NVSwitch 和 PCIe 交换机的 NVIDIA DGX H100 系统相比,它只是一个更大的构建块。
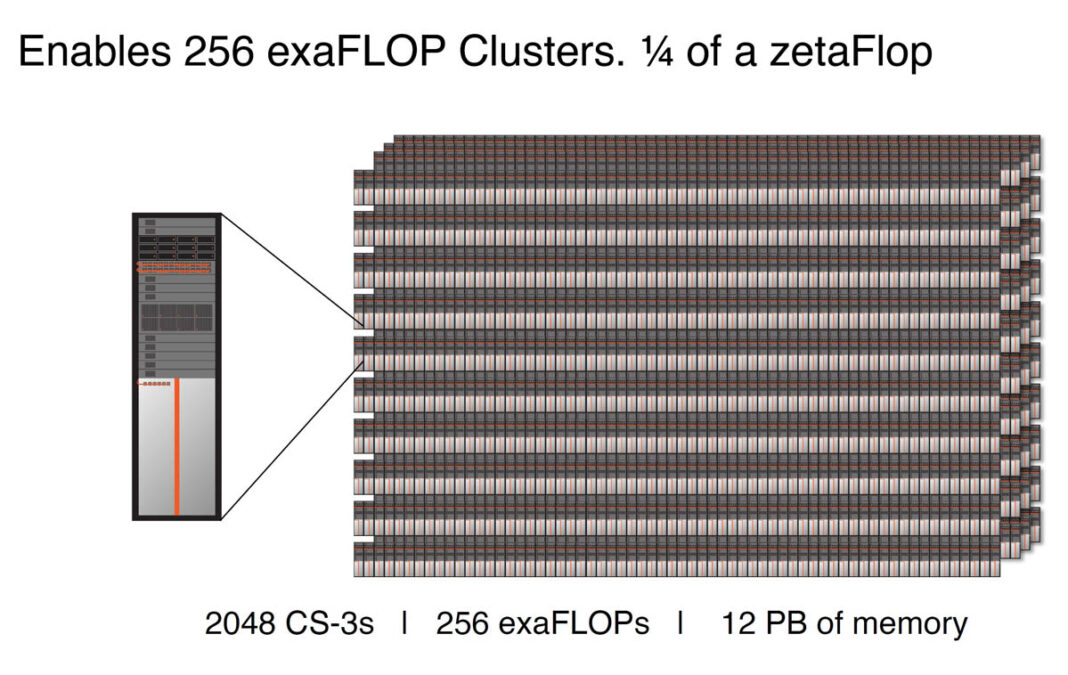
这一代的一大特点是更大的集群,多达 2048 个 CS-3,用于多达 256 exaFLOP 的 AI 计算。
 这个 12PB 的内存数字是一个高端超大规模 SKU,专为快速训练 GPT-5 大小的模型而设计。Cerebras 还可以缩小到类似单个 CS-2 的东西,并支持服务器和网络。借助 CS-3,我们大幅增加了 MemoryX 选项,包括面向企业客户的 24TB 和 36TB SKU,以及面向超大规模客户的 120TB 和 1,200 TB 选项。
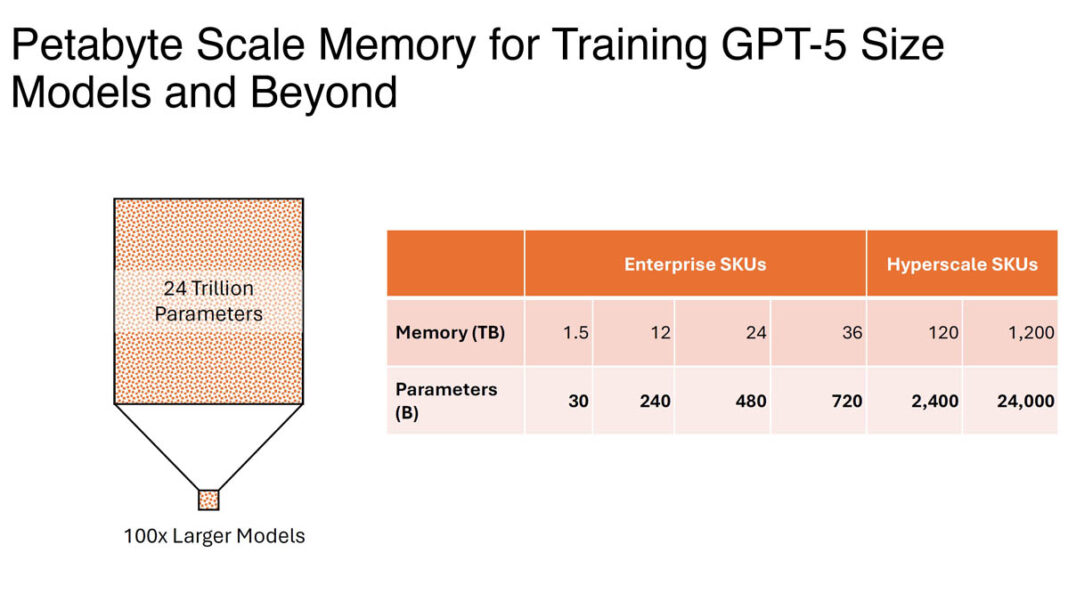 部分内存不仅是片上内存(44GB),还包括支持服务器中的内存。
参考文献
- S. Lie, “Inside the Cerebras Wafer-Scale Cluster: Cerebras Systems,” 2023 IEEE Hot Chips 35 Symposium (HCS), Palo Alto, CA, USA, 2023, pp. 1-41, doi: 10.1109/HCS59251.2023.10254700.
- G. Lauterbach, “The Path to Successful Wafer-Scale Integration: The Cerebras Story,” in IEEE Micro, vol. 41, no. 6, pp. 52-57, 1 Nov.-Dec. 2021, doi: 10.1109/MM.2021.3112025.
- S. Lie, “Cerebras Architecture Deep Dive: First Look Inside the Hardware/Software Co-Design for Deep Learning,” in IEEE Micro, vol. 43, no. 3, pp. 18-30, May-June 2023, doi: 10.1109/MM.2023.3256384.
- Wang, J., 2024. Cerebras CS-3: the world’s fastest and most scalable AI accelerator. Cerebras. URL https://www.cerebras.net/blog/cerebras-cs3/
- “Wafer-Scale Deep Learning,” 2019 IEEE Hot Chips 31 Symposium (HCS), Cupertino, CA, USA, 2019, pp. 1-31, doi: 10.1109/HOTCHIPS.2019.8875628.
- “Software Co-design for the First Wafer-Scale Processor (and Beyond),” 2020 IEEE Hot Chips 32 Symposium (HCS), Palo Alto, CA, USA, 2020, pp. 1-26, doi: 10.1109/HCS49909.2020.9220504.