
前言
最近几年系统性的学习并梳理了计算机体系结构的相关知识,稍有感悟。遂决定将之整理成文,一来沉淀所学,避免遗忘;二来将散落在各处的技术细节串联起来,形成相对完整的知识脉络;三则试图通过回顾历史,进而窥见未来的走向。
本系列文章命名为鉴往知远,主要关注计算与互联两个方向。本文是该系列中关于 SPARC 的一篇,主题为 Sun / Oracle 与 Fujitsu 两条脉络上 SPARC 处理器近三十年的演进。
如果说 POWER 是 IBM 在高端服务器市场上”以强致胜”的代表,那么 SPARC 走的就是另一条路:它诞生于学术界开放的 RISC 思潮,以寄存器窗口这一极具辨识度的设计闻名,在九十年代凭借超标量与多媒体扩展一度领跑,又在二十一世纪初断然转向吞吐量计算 (Throughput Computing),用”简单多核 + 超多线程 + 巨量内存带宽”重新定义了服务器处理器的形态。
0. 概述
0.1 SPARC 发展时间线
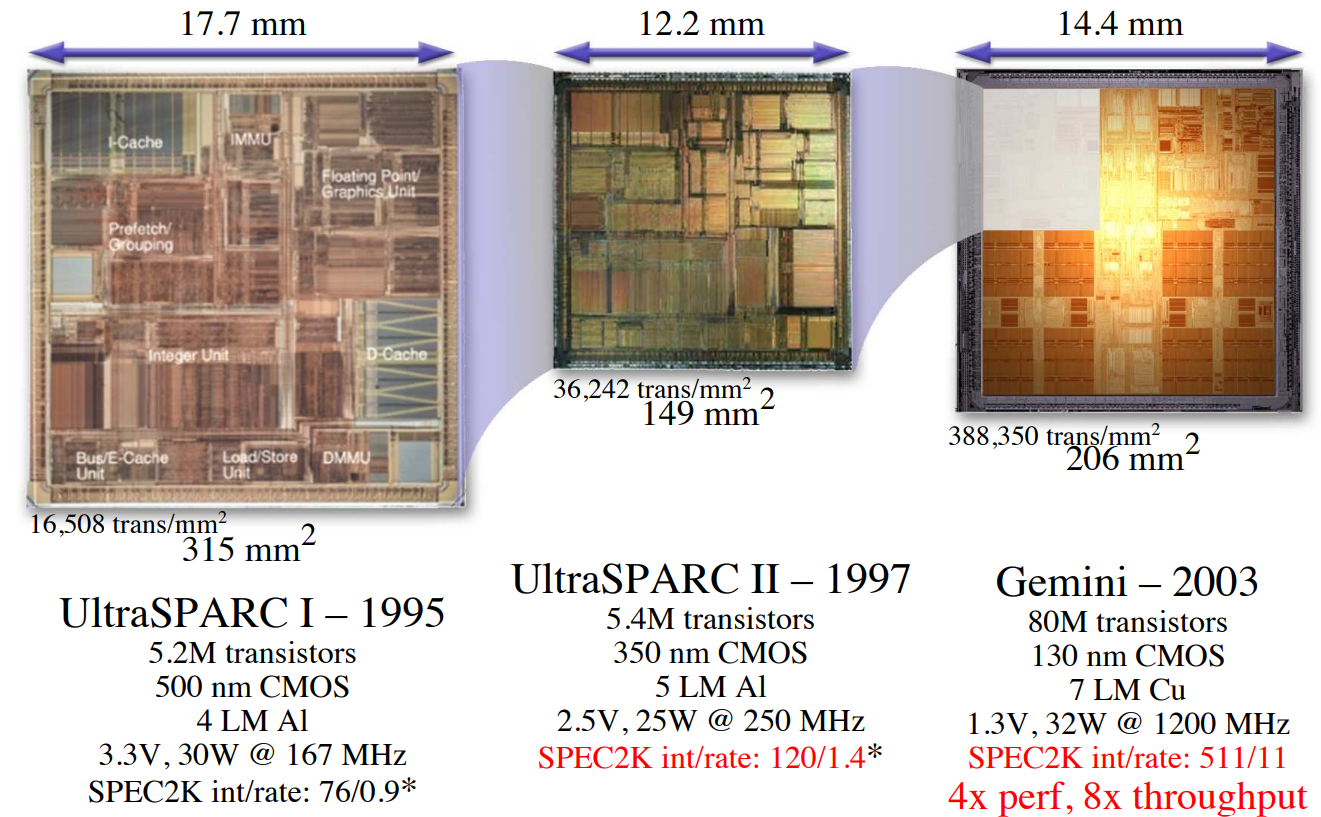
SPARC(Scalable Processor Architecture,可扩展式处理器架构)的源头,要追溯到 1980 年代初加州大学伯克利分校的 RISC 研究。这种起源于学校的开放思想背景,自然也影响了 Sun 自行研发的 RISC 指令集处理器。
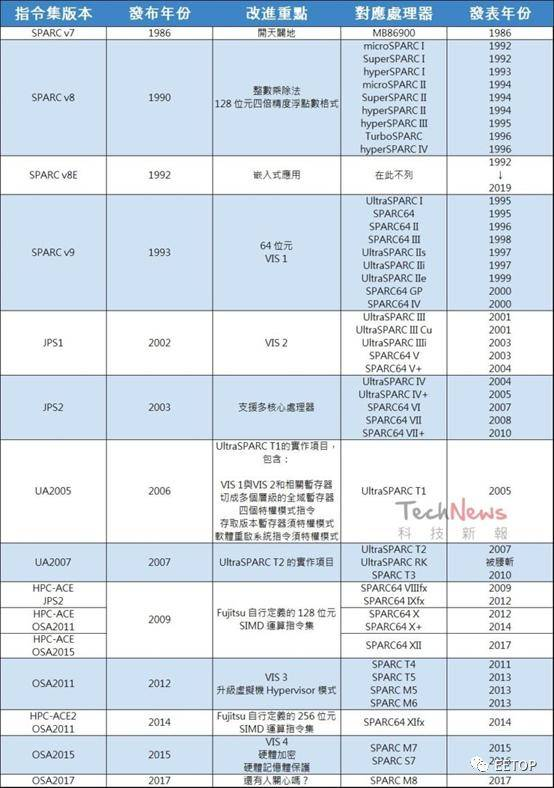
下表按时间顺序梳理了 SPARC 发展过程中的关键节点:
- 1984 年:Sun 开始进行 SPARC 指令集研究,开发顾问是大名鼎鼎的 David Patterson——两本必读计算机体系结构图书的作者、RISC 的创造者、RISC-V 的发起者。2018 年 3 月 22 日,David Patterson 因开发了 RISC 微处理器并让这一概念流行起来,获得 2017 年度 ACM 图灵奖。
- 1986 年:Sun 发表 32 位的 SPARC V7 指令集。世界首颗实做出来的 SPARC 兼容处理器并非出自 Sun,而是 Fujitsu 的 MB86900。
- 1987 年:Sun-4 系列工作站问世,处理器来源为日本 Fujitsu 与 Cypress(分别搭配来自 Weitek 和 TI 的浮点辅助运算器)。
- 1990 年:SPARC V8 补完了整数乘法与除法等”复杂”指令,后于 1994 年成为 IEEE Std 1754。
- 1992 年:SuperSPARC,Sun 首颗超标量 SPARC 实现,3 指令派发、全动态调度。
- 1994 年:SPARC International 发布 SPARC V9 规范,将架构扩展到 64 位。
- 1995 年:UltraSPARC I,首颗 SPARC V9 处理器,并引入 VIS(Visual Instruction Set)多媒体指令集。
- 2001 年:UltraSPARC III(Cheetah)与 UltraSPARC III Cu,后者借助 0.13μm 铜导线工艺冲破 1GHz。
- 2002 年:Sun 与 Fujitsu 联合提出 JPS(Joint Programming Specification)规范。
- 2004 年:UltraSPARC IV,UltraSPARC 家族进入双核心时代。
- 2005 年:UltraSPARC T1(Niagara)发布,确立 Throughput Computing 路线;同年 Sun 以 OpenSPARC 的形式开放 T1 的 RTL 源码。
- 2007 年:UltraSPARC T2(Niagara-2),单芯片 8 核 64 线程,并集成密码学加速与 10Gb 以太网。
- ![[Pasted image 20230719100300.png]]
- 2010 年:Oracle 完成对 Sun 的收购,UltraSPARC RK(Rock)被取消,SPARC Enterprise 品牌并入 SPARC T / M 系列。
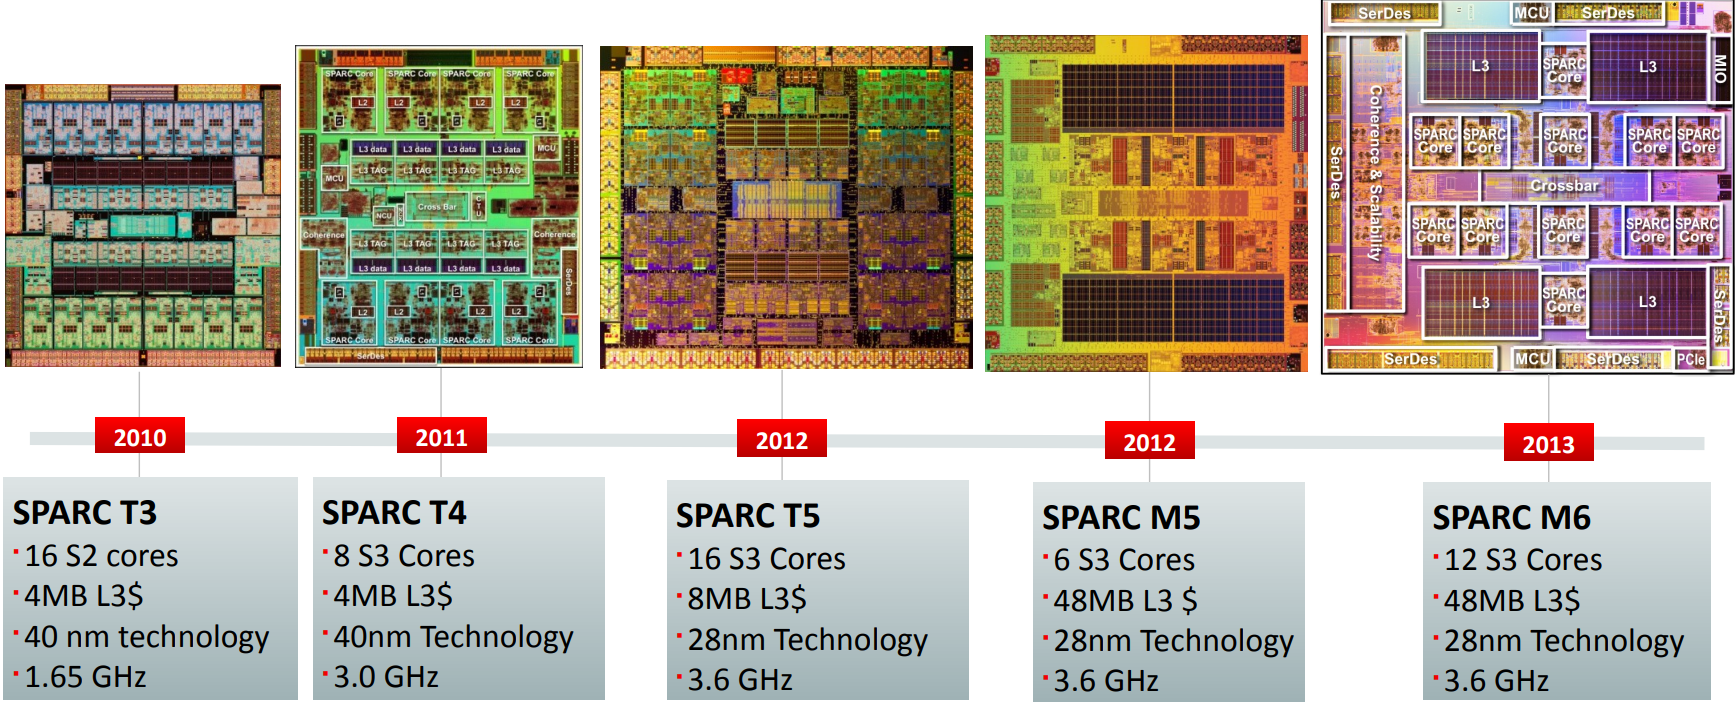
- 2011 年:SPARC T4,S3 核心转向双指令派发、非循序预测执行;Oracle 发布 OSA(Oracle SPARC Architecture)。
- 2014 年:Fujitsu SPARC64 XIfx,SPARC 世界第一颗超级电脑系统单芯片。
- ![[Pasted image 20230630141022.png]]
- 2015 / 2017 年:SPARC M7 与 SPARC M8,分别达到 32 核 256 线程、5GHz 时钟,成为 SPARC 在高端服务器的绝响。
- 2020 年:由 SPARC64 XIfx 演化而来的 A64FX(改用 ARM 架构)驱动”富岳”登上 Top500 首位。
0.2 本文组织形式
本文的组织形式如下:
- 0.1 节按时间顺序梳理 SPARC 三十余年的发展里程碑,可作为全文的快速索引。
- 0.3 节给出高频术语的中英对照表。Sun / Oracle 与 Fujitsu 两家文档对同一概念的译法常有出入。
- 第 1 章介绍 SPARC 指令集架构,包括寄存器窗口、指令格式、分支与延迟槽、陷阱与特权级、存储模型,以及 V7 / V8 / V9 / VIS / JPS / OSA / HPC-ACE 的版本演进。
- 第 2 章给出 SPARC 处理器的总体概览与跨代对比。
- 第 3 至第 7 章介绍 Sun “传统”高性能 UltraSPARC 家族:SuperSPARC、UltraSPARC I、II / IIi / IIe、III / IIIi(Gemini)、IV / IV+。
- 第 8 至第 9 章介绍转向吞吐量计算后的 UltraSPARC T1 / T2(Niagara / Niagara-2)及其多片一致性互连。
- 第 10 章介绍令人惋惜的未竟之作 SPARC Rock。
- 第 11 至第 12 章介绍 Oracle 时代的 SPARC T3 / T4 / T5 与 M5 / M6 / M7 / S7 / M8。
- 第 13 章介绍 Fujitsu 的 SPARC64 系列,及其在超级计算机上的分支。
- 最后是参考文献。
0.3 术语对照
本文沿用了大量原始技术文档中的英文术语。下表列出高频术语的中英对照,其中部分术语在 Sun / Oracle 与 Fujitsu 两家文档中译法不同:
| 英文 | 中文 | 说明 |
|---|---|---|
| Register Window | 寄存器窗口 | SPARC 的标志性设计,相邻窗口的 out / in 寄存器物理重叠 |
| Superscalar | 超标量 | 每周期派发多条指令 |
| Out-of-Order Execution | 非循序 / 乱序执行 | 本文两种译法并存,均指指令执行顺序不同于程序顺序 |
| Speculative Execution | 预测执行 / 投机执行 | |
| SMT(Simultaneous Multi-Thread) | 同时多线程 | Fujitsu SPARC64 系列采用 |
| CMT(Chip Multi-Threading) | 芯片多线程 | Sun 对 Niagara 多线程方案的称谓 |
| CMP(Chip Multi-Processor) | 芯片多处理器 | 单芯片多核 |
| Throughput Computing | 吞吐量计算 | Sun 在 T 系列上确立的路线 |
| Crossbar | 交叉开关 | 连接核心、L2 分体与 I/O 的片上互连 |
| Strand | 硬件线程 | Sun / Fujitsu 文档中对硬件线程的称呼 |
| Pick Queue | 拾取队列 | 待发射指令队列,S3 为 40 项 |
| Store Buffer (STB) | 存储缓冲 | 暂存待写回的 store |
| Load Miss Queue (LMQ) | 加载失效队列 | 跟踪未完成的 load miss |
| Gasket | 垫片单元 | 核心与交叉开关之间的接口单元 |
| TLB / ITLB / DTLB | 转换后行缓冲 | 地址转换快表,分为指令 / 数据 |
| MOESI | — | 缓存一致性协议的五种状态 |
| TSO(Total Store Order) | 全存储定序 | SPARC V9 的默认内存模型 |
| RAS | 可靠性、可用性、可服务性 | 高端服务器的三大指标 |
| MCM(Multi-Chip Module) | 多芯片模块 | SPARC64 早期采用的封装形式 |
1. SPARC 指令集架构
SPARC 深受早期 RISC「精简」思潮熏陶,希望所有运算动作都可单时钟周期搞定并高度流水线化,像整数除法之类的「复杂」指令就付之阙如,透过重复的简单运算取代之,这部分到了 1990 年的 SPARC v8 才补完。
Sun 在 1986 年发表 32 位的 SPARC v7 指令集,但 Sun 并不像其他厂商自己做芯片,而是开放出来并定义严谨版本,让其他厂商也能研制 SPARC 指令集的兼容处理器。这种”ISA 与实现分离、由独立机构维护标准”的做法,正是 SPARC 得名”可扩展”的另一层含义。
1995 年 SPARC v9 扩充到 64 位元与 SIMD 指令集 VIS(Visual Instruction Set),Sun 跟 Fujitsu 在 2002 年联合提出 JPS(Joint Programming Specification)规范并持续演进到 UA(UltraSPARC Architecture)、OSA(Oracle SPARC Architecture)和 Fujitsu 自行定义的高效能运算 HPC-ACE(High Performance Computing – Arithmetic Computational Extensions)。
1.1 寄存器
1.1.1 通用寄存器与寄存器窗口
寄存器窗口(Register Window) 是 SPARC 架构最具标志性的设计,其出发点是用硬件换掉函数调用时频繁的参数保存与恢复开销。
SPARC 具有 8 个全局寄存器(Global Registers) %g0–%g7,其中 %g0 硬连线为零——写入无效、读出恒为 0,编译器可借此合成 mov、cmp 等大量伪指令。
任意时刻软件可见 32 个整数寄存器:8 个全局寄存器,加上 24 个窗口寄存器,后者分为:
- 8 个
in寄存器%i0–%i7:存放传入参数与返回地址 - 8 个
local寄存器%l0–%l7:存放局部变量 - 8 个
out寄存器%o0–%o7:存放传出参数
相邻窗口彼此重叠:当前窗口的 out 寄存器在物理上就是下一个窗口的 in 寄存器。函数调用时执行 save 指令使窗口上滑,返回时执行 restore 使窗口下滑,参数传递与现场保存因此大部分无需访存。
实现可提供的窗口数目由 NWINDOWS 决定(V8 为 2–32,V9 为 3–32)。当窗口耗尽时,save 会触发窗口溢出陷阱(window overflow trap),由软件把最老的窗口内容写回到内存中的寄存器栈;restore 时则对称地触发窗口下溢陷阱(window underflow trap)。
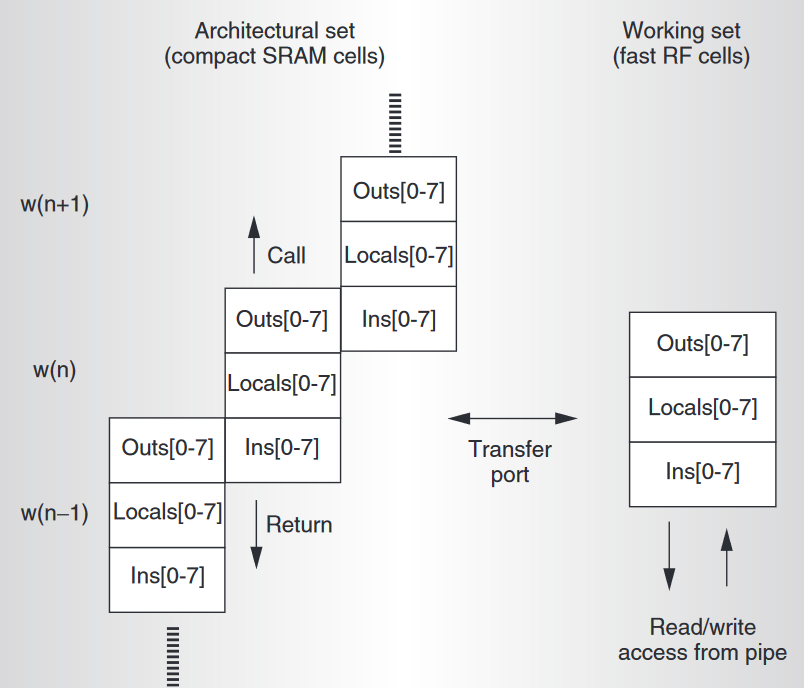
下图展示了 UltraSPARC T1 的寄存器文件实现:每个线程 8 个寄存器窗口,4 个线程共 640 个 64 位寄存器,构成一个 5.7 KB 的结构。
1.1.2 浮点与图形寄存器
SPARC V9 定义了 32 个 64 位的浮点/图形寄存器(Floating-Point/Graphics Registers),可视使用方式呈现为三种视图:
- 32 个单精度寄存器
%f0–%f31 - 32 个双精度寄存器
%d0–%d62(仅偶数编号) - 16 个四精度寄存器
%q0–%q60(仅 4 的倍数编号)
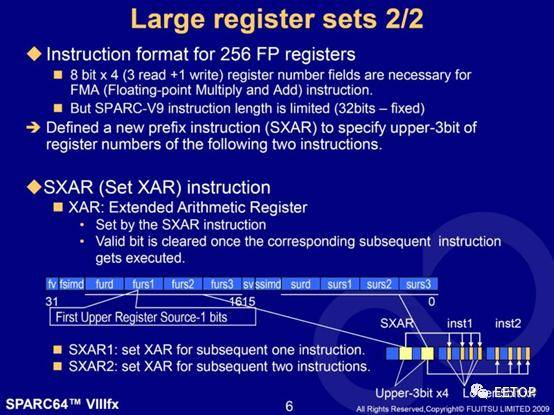
UltraSPARC I 的浮点/图形寄存器文件具备 5 读 3 写端口,供 VIS 的分块(partitioned)运算直接复用。Fujitsu 的 HPC-ACE 则进一步把浮点寄存器扩展到 256 个——由于 SPARC V9 的 32 位指令编码不足以寻址 256 个寄存器,必须引入补充寻址位的前置指令 SXAR,详见 1.6.5 节。
1.1.3 状态与控制寄存器
- V8 定义了 PSR(Processor State Register)、WIM(Window Invalid Mask)、TBR(Trap Base Register)与 Y 寄存器(保存乘法高位结果)。
- V9 引入 PSTATE(含
PRIV、IE、AM、CLE等域)、TSTATE、TBA(Trap Base Address)、TL(Trap Level)、PIL(Processor Interrupt Level)、CWP(Current Window Pointer)、CCR、WSTATE,以及若干辅助状态寄存器(ASR)。 - 条件码分为整数条件码
icc(32 位)与xcc(64 位),以及 4 组浮点条件码fcc0–fcc3。
1.2 指令格式与寻址
SPARC 的所有指令均为定长 32 位,编码为三种基本格式:
- Format 1(
op = 01):call,携带 30 位相对位移 - Format 2(
op = 00):sethi与分支指令,携带 22 位立即数或 22 位分支位移 - Format 3(
op = 10/11):其余全部指令,携带两个源寄存器、一个目的寄存器,以及 13 位带符号立即数
由于立即数字段只有 13 位,加载任意 32 位常量需要 sethi + or 两条指令配合,这是 SPARC 代码中最常见的指令对之一。
1.3 分支与延迟槽
SPARC 采用延迟分支(Delayed Branch):紧随分支指令之后的延迟槽指令总是被执行,与分支是否跳转无关。分支指令编码中的 annul 位(a) 用于在分支不跳转(或跳转)时取消延迟槽指令的执行,从而让编译器能够更充分地填充延迟槽。
条件分支的条件来自 1.1.3 节所述的条件码寄存器。UltraSPARC 系列在取指单元中实现了 Next Field RAM 结构,用以保存分支目标地址与动态分支预测位;而 Niagara 系列为追求面积效率,直接取消了分支预测器,采用 predict-not-taken 策略。
1.4 异常、陷阱与特权级
- V9 通过
PSTATE.PRIV区分特权态与非特权态,并以 TL(Trap Level) 支持嵌套陷阱。 - UltraSPARC IIi 的整数执行单元支持精确异常(Precise Exceptions)与 5 级嵌套陷阱。
- V8/V9 均定义了三类陷阱:精确陷阱、延迟陷阱(deferred trap,如浮点异常)与中断陷阱。
1.5 存储模型
SPARC V9 定义了三种存储模型,由 PSTATE 中的相关位选择:
- TSO(Total Store Order):默认模型。所有处理器观察到的 store 顺序一致,load 不会被重排到更早的 store 之前。UltraSPARC III 与后续处理器均声明符合 SPARC V9 TSO。
- PSO(Partial Store Order):放宽不同地址 store 之间的顺序约束。
- RMO(Relaxed Memory Order):进一步放宽 load 之间的顺序约束。
UltraSPARC T2 由核心的加载存储单元与 L2 缓存交叉开关共同维持 TSO 合规性,仅少数明确不需要 TSO 支持的指令例外。
在缓存一致性方面,UltraSPARC I 的外部缓存单元采用 5 态 MOESI 协议,并同时支持侦听式(snoopy)与目录式(directory-based)两种一致性协议。
1.6 版本演进
1.6.1 SPARC V7 / V8
SPARC V7(1986)是首个公开的 32 位版本,秉承极简主义,连整数乘法与除法都不提供。SPARC V8(1990)补上了 smul / umul / sdiv / udiv 与 mulscc 等指令,并完善了协处理器与 MMU 的定义;1994 年被批准为 IEEE Std 1754-1994。
1.6.2 SPARC V9
SPARC V9 将架构扩展到 64 位,主要变化包括:
- 通用寄存器与地址空间扩展到 64 位
- 窗口数目范围调整为 3–32,引入
PSTATE、TL等新状态寄存器 - 定义 TSO / PSO / RMO 三种存储模型
- 引入 VIS 指令集与 32 个 64 位浮点/图形寄存器
- 支持大端(big-endian)与小端(little-endian)两种数据字节序
1.6.3 VIS
VIS(Visual Instruction Set) 是 SPARC 的多媒体 SIMD 扩展,把 64 位寄存器分块为 8×8 位、4×16 位或 2×32 位进行操作,主要用于 2D/3D 图形、图像处理、实时压缩解压缩与视频特效。UltraSPARC IIi 的规格书记载:VIS 的块加载与存储(64 字节块)可在任意源/目的对齐下,维持 300 MByte/s 的主存读写带宽。
VIS 的版本演进为:VIS 1.0(UltraSPARC I/II)→ VIS 2.0(UltraSPARC III/IV)→ VIS 3.0(SPARC T4)→ VIS 4(SPARC M7)。
1.6.4 JPS / UA / OSA
Sun 与 Fujitsu 在 2002 年联合提出 JPS(Joint Programming Specification),把两家各自的实现差异收敛为统一规范,其后续演进依次为:
- UA(UltraSPARC Architecture):Sun 时代的定义
- OSA(Oracle SPARC Architecture):Oracle 收购 Sun 之后的定义
- HPC-ACE(High Performance Computing – Arithmetic Computational Extensions):Fujitsu 自行定义的高效能运算扩展
1.6.5 HPC-ACE
HPC-ACE 是 Fujitsu 为超级计算机量身定制的扩展,最关键的一点是把浮点寄存器扩展到 256 个,并引入浮点乘积和 FMA(A × B + C = D)指令。
但是SPARC V9 指令的 32 位编码不足以寻址所有浮点寄存器——256 个寄存器需要 8 位元,而 FMA 指令会用到 4 个寄存器,将会吃光 32 位编码,连运算码都没地方放了——因此必须在运算指令前,排入「补充」寄存器定址位元数的前置指令 SXAR。
2. SPARC 处理器概述
Sun 在 1986 年发表 32 位的 SPARC v7 指令集之后,其处理器实现大致经历了三个阶段:
- 开放授权、借力代工:Fujitsu 的 MB86900 是世界首颗 SPARC 实现,Sun-4 工作站的处理器来自 Fujitsu 与 Cypress。
- 传统超标量高性能:从 SuperSPARC 到 UltraSPARC IV+,追求单线程性能与高时钟频率,与 x86 正面竞争。
- 吞吐量计算:从 UltraSPARC T1 到 SPARC M8,转向”简单多核心、超多线程、大量存储器频宽”,专攻 Web、数据库与云计算负载。
下表按代际对比了各主要 SPARC 处理器的关键规格。
| 项目 | SuperSPARC | UltraSPARC I | UltraSPARC IIi | UltraSPARC III | UltraSPARC IV+ | UltraSPARC T1 | UltraSPARC T2 | SPARC T4 | SPARC M6 | SPARC M7 | SPARC64 VII | SPARC64 VIIIfx | SPARC64 X+ | SPARC64 XII |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 年份 | 1992 | 1995 | 1997 | 2001 | 2005 | 2005 | 2007 | 2011 | 2013 | 2015 | 2008 | 2009 | 2013 | 2017 |
| 工艺 | 0.8μm BiCMOS | 0.5μm 4LM CMOS | 0.35μm 5LM CMOS | 0.18μm 6LM Al | 90nm | 90nm | 65nm 11M Cu | 40nm | 28nm | 20nm 13ML | 65nm | 45nm | 28nm | 20nm |
| 晶体管 | — | 5.2M | 5.75M | — | — | — | ~500M | ~855M | 4.27B | — | 600M | 760M | 2,990M | — |
| 面积(mm²) | — | 315 | 150 | 330 | — | — | 342 | — | — | — | ~424 | ~513 | 600 | — |
| 频率 | 33–60MHz | 143–167MHz | 270–360MHz | 600MHz | 1.5–2.1GHz | 1.0–1.2GHz | 1.4GHz | 2.85–3GHz | 3.6GHz | 4.13GHz | 2.5GHz | 2GHz | 3.5GHz+ | 2.5–4.35GHz |
| 功耗 | — | 28W | 24W@300MHz | 70W@1.8V | — | — | 84W | — | — | — | 135W | 58W | — | — |
| 派发宽度 | 3 | 4 | 4 | 4 | 4 | 1×8 | 2×8 | 2 | 2 | 2 | 4 | 4 | 4 | — |
| 核心数 | 1 | 1 | 1 | 1 | 2 | 8 | 8 | 8 | 12 | 32 | 4 | 8 | 16 | 12 |
| 线程数 | 1 | 1 | 1 | 1 | 2 | 32 | 64 | 64 | 96 | 256 | 8 | 8 | 32 | 96 |
| L1 I$ | — | 16KB 2-way | 16KB 2-way | 32KB | — | 16KB 4-way | 16KB 8-way | 16KB 4-way | 16KB 4-way | 256KB(簇共享) | — | — | — | — |
| L1 D$ | — | 16KB 直接映射 | 16KB 直接映射 | 64KB 4-way | — | 8KB 4-way | 8KB 4-way | 16KB 4-way | 16KB 4-way | 256KB(核对共享) | — | — | — | — |
| L2 | — | 0.5–4MB(片外) | 0.25–2MB(片外) | 1–8MB(片外) | 2MB | 3MB 12-way | 4MB 8-bank | 128KB/核(私有) | 128KB/核 | 256KB I + 256KB D | 6MB(共享) | 5MB(共享) | 24MB(共享) | — |
| L3 | 无 | 无 | 无 | 无 | 无 | 无 | 无 | 4MB 8-bank | 48MB | 64MB | 无 | 无 | 无 | — |
| 内存 | — | 2.6GB/s | 400MB/s–1.2GB/s | 片上控制器 | — | 4×DDR2, >20GB/s | 4×FBDIMM, >60GB/s | 2×DDR3-1066 双通道 | 16 DDR3 通道/槽 | 16 DDR4 通道, 160GB/s | — | 64GB/s | 102GB/s | — |
| I/O | — | UPA 系统总线 | PCI/66 | JBus | — | — | PCIe x8, 2×10GbE | 2×PCIe x8 2.0, 2×10GbE | 2×PCIe 3.0 x8 | PCIe Gen3 >75GB/s | Jupiter Bus | 片上内存控制器 | 片上内存与 I/O 控制器 | — |
| 备注 | 首个超标量 SPARC | 首颗 SPARC V9, VIS 1.0 | 集成 PCI 控制器 | 片上内存控制器 | 传统 UltraSPARC 绝响 | Niagara, 8 核 32 线程 | Niagara-2, 8 核 64 线程 | S3 核心, 双发射乱序 | S3 核心, 48MB L3 | S4 核心, 查询卸载引擎 | 4 核 2 路 SMT | HPC-ACE, 水冷 | SWoC, HPC-ACE | 12 核 96 线程 |
可以看大,UltraSPARC I 到 IV+ 一路堆时钟与单线程性能,T1 之后则把晶体管预算全部砸进线程数与内存带宽。
3. SuperSPARC
1992 年的 SuperSPARC采用0.8μm 制程,时钟 33–60MHz,那时英特尔 Pentium 尚未上市。
3.1 微架构
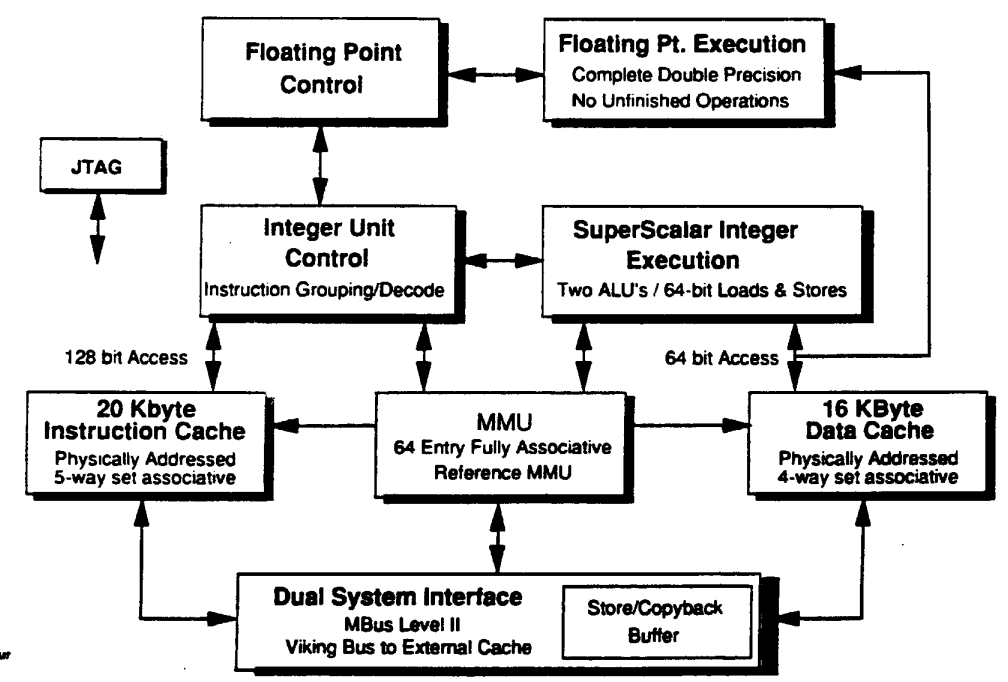
SuperSPARC(代号 Viking)是 Sun 首颗超标量 SPARC 实现。Sun 的应用分析表明每周期三条指令性价比最高,超标量引擎便围绕「三指令派发」来设计,指令的分组与调度完全由硬件动态完成,不需要编译器插手:
- 3 instruction/cycle issue & execute, fully dynamic scheduling
- 同时执行(Simultaneous execution)可能受以下因素限制:
- data dependencies(数据相关)
- control dependencies(控制相关)
- internal resources(内部资源)
- SuperSPARC 资源包括:
- Single 54-bit LD/ST
- Two 32-bit ALUs
- Single FP Issue
- Single Br/Jmp/Call/Return
- Two 32-bit integer results
3.2 流水线与取指
指令在流水线中以组为单位移动。取指单元每周期取 4 条指令,前方有 8 项指令预取队列与 4 项分支目标队列;整数单元为 4 级流水线,内部是两个级联的 32 位 ALU,同组的第二条整数指令可以直接使用前一条的结果,因此单周期能完成两条整数运算。load/store 为单周期、64 位宽,没有 load-use 惩罚。
分支方面,SuperSPARC 靠预取队列与分支目标队列消化绝大多数已跳转与未跳转分支,不造成流水线停顿,再配合 SPARC 的延迟槽,分支代价在当时属于最低的一档。
3.3 浮点单元
浮点单元与整数流水线紧密耦合:浮点控制器从整数流水线末级接过浮点指令,按类型分派给两条独立的浮点流水线——加法器(FADDER,负责加减与逻辑运算)与乘法器(MULTIPLIER),各自流水化,完整支持 IEEE 单双精度。
3.4 缓存与 MMU
- 片上 20KB 指令缓存:128 位宽访问,5 路组相联,物理寻址,64 字节行、32 字节子块,支持 burst fill 预取——是当时 RISC 处理器中最大的片上缓存
- 片上 16KB 数据缓存:64 位宽访问,4 路组相联,物理寻址,32 字节子块;无外部缓存时写回,挂外部缓存时写穿
- SPARC Reference MMU(SRMMU):64 项全相联 TLB,硬件自动重载,支持 36 位物理地址
3.5 MBus 与多处理器
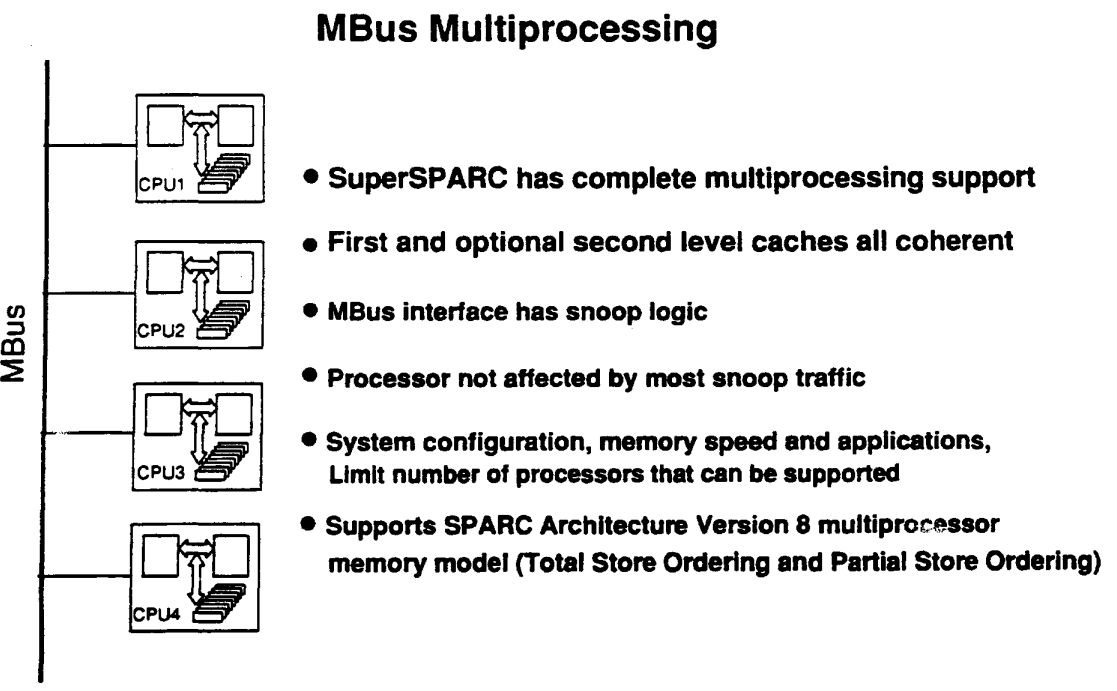
SuperSPARC 在片上集成了完整的 MBus Level II 接口:全同步的片间多处理器总线,64 位数据通路,带一致性协议、侦听逻辑与 store/copyback 缓冲。配套的 SuperSPARC MultiCache Controller(MCC) 负责外部缓存的标签与控制——MBus 模式 1MB,XBus 模式 512KB/1MB/2MB——并内建多处理器缓存一致性的支持。
SuperSPARC 主要用在 SPARCstation 10/20 与 SPARCserver 上;SPARCcenter 2000 最多装 20 颗,Cray CS6400 最多 64 颗,Thinking Machines 的 CM-5 超算则用掉了上百颗。
3.6 工艺与封装
3.6.1 Technology
- SuperSPARC CPU 与 Cache Controller 采用 TI 的 EPIC IIB 工艺制造
- 0.8 micron 最小特征尺寸
- BiCMOS——融合 Bipolar 与 CMOS 电路之长
- Bipolar:用于 I/O 与互连
- CMOS:用于密度与简洁性
- 三层金属(Triple Level Metal)
- 310 万个晶体管,die 15.98mm × 15.98mm,5V 供电,典型功耗 8W
- 带散热片的高密度陶瓷针栅阵列封装(CPGA)
- SuperSPARC CPU:293 pins,70 mil 引脚间距
- SuperSPARC CC:369 pins,70 mil 引脚间距
3.7 SuperSPARC II
1994 年的 SuperSPARC II采用0.8μm 制程,时钟 75–90MHz,那年已经出现 100MHz 的英特尔 Pentium。
微架构改动不大,浮点单元增加了第三条流水线——独立的浮点除法/平方根单元(FDS),整数寄存器堆也重新设计了一番,以便冲击更高的时钟。
4. UltraSPARC I
1995 年的 UltraSPARC I 采用0.47μm 制程,时钟 143–167MHz, 同时英特尔推出 x86 历史首次正面挑战服务器市场的 Pentium Pro,时钟直扑 200MHz,并具备原生四处理器架构与非循序预测指令执行。
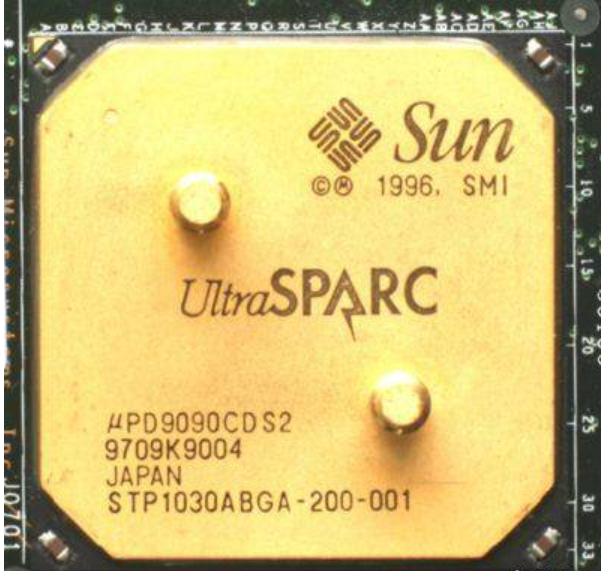
4.1 处理器概述
UltraSPARC I 是首颗实现 SPARC V9 的处理器,也是 VIS 指令集的首次落地。
- Architecture
- 64-bit SPARC-V9 with multimedia instruction extensions
- Pipeline
- 4-issue superscalar, 9 stage pipeline
- Clock Freq
- 167MHz
- Performance @ 167MHz, 2MB E$
- 240 SPECint92, 350 SPECfp92
- Power Supply
- 3.3v
- Power @ 3.3V, 167MHz
- 28W
- 20mW sleep mode
- Die Size
- 17.7 mm × 17.8 mm = 315 mm²
- Transistors
- 5.2 million(其中 3.4 million 为逻辑)
- Technology
- CMOS 4-layer metal, 0.5 μm drawn
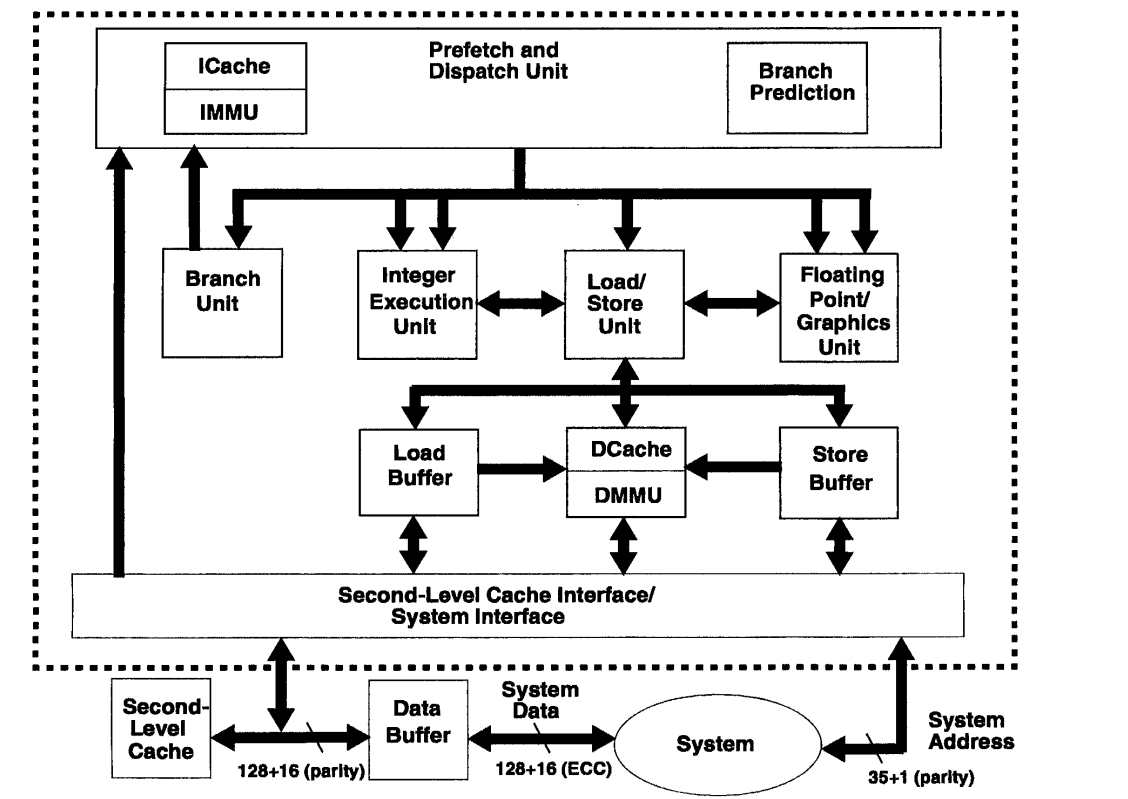
4.2 流水线
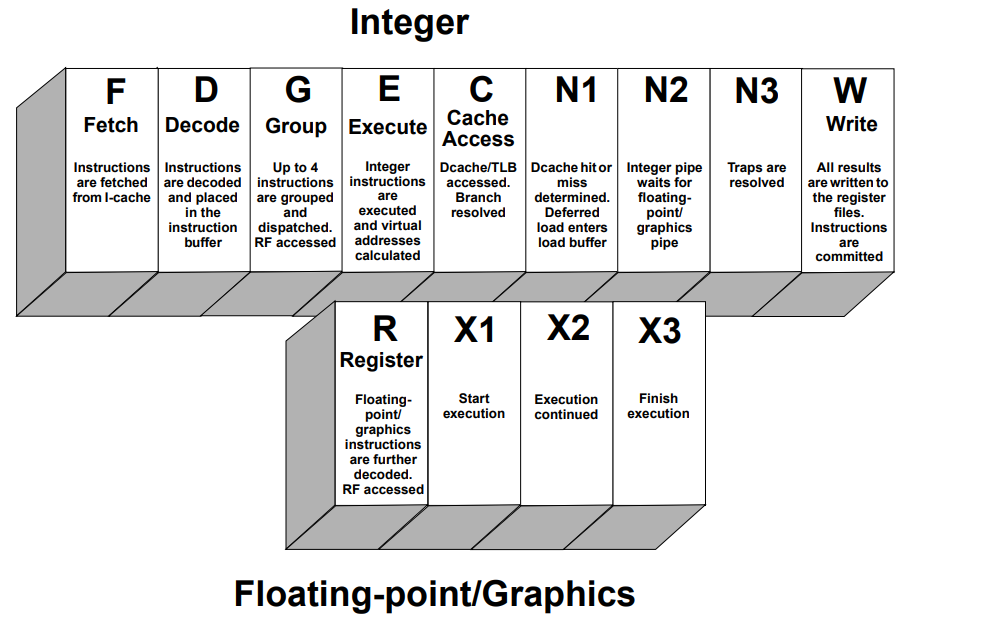
UltraSPARC I 为 9 级流水线,前两级的取指与译码之后,整数流水线刻意再加三级,与浮点流水线做成等长对称。这么设计是为了简化流水线同步与异常处理,顺带取消了独立的浮点队列。指令按程序序派发到多个功能部件,并行执行、可以乱序完成;为了进一步提高每周期执行的指令数,来自不同基本块(例如条件分支两侧)的指令允许排在同一个派发组里。
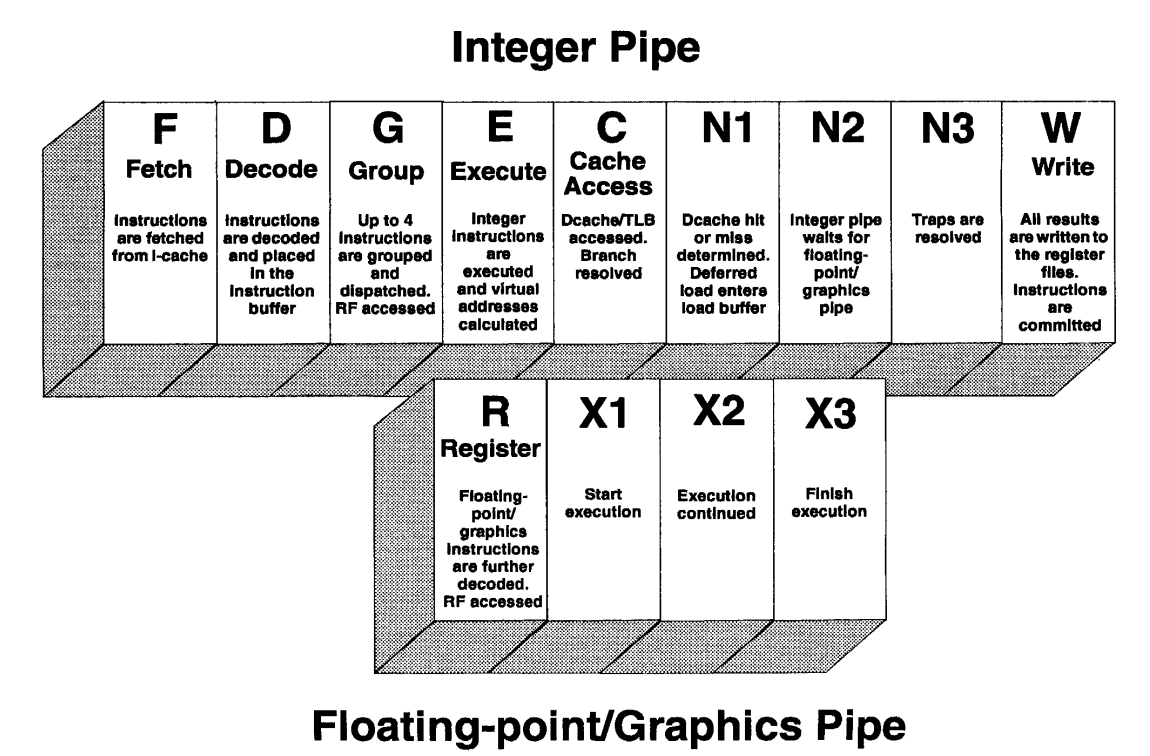 全芯片共 9 个执行单元,整数侧 2 个 ALU 加乘除法器,浮点 3 个子单元,图形单元 2 条独立流水线。
4.3 整数执行单元
- 两个 ALU 构成整数运算主体
- 带「early out」的多周期整数乘法器与多周期整数除法器
- 8 个寄存器窗口,外加 4 组全局寄存器(normal / alternate / MMU / interrupt)
- 陷阱寄存器在整数单元内,支持 5 级嵌套陷阱
- 精确异常模型靠浮点流水线与整数流水线同步、对长延迟操作做陷阱预测来维持
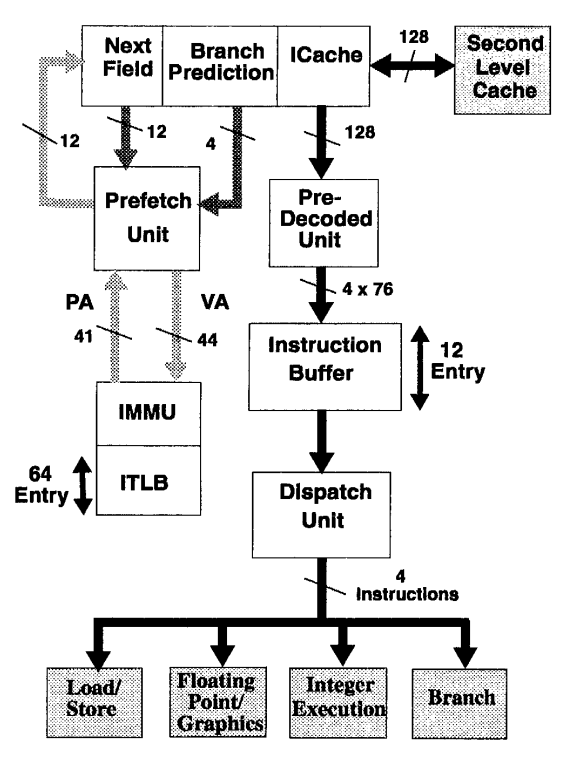
4.4 取指与派发单元
- 16kB ICache,伪 2 路组相联(pseudo-two-way),32B line size w/pre-decoded bits;set 由 next field 预测,寻址只需索引位
- Next Field RAM,内含 1k 个分支目标地址与 2k 个动态分支预测项
- 动态分支预测基于每条分支的 2 位历史,预测位随指令一起存进 ICache(每指令 2 个额外位)
- next field 指向下一行要取的 ICache 行,已跳转分支可以单周期跟上,指令带宽与顺序代码基本持平
- 4-entry Return Address Stack
- 分支预测准确率:SPECint92 88%,SPECfp92 94%
- 64-entry 全相联 ITLB,背后还有 1-entry µTLB;页面大小 8K / 64K / 512K / 4MB,44 位虚拟地址映射 41 位物理地址
- 12-entry Instruction Buffer,由 ICache 或二级缓存供给
- 单周期派发逻辑,每周期考察最前的 4 条指令
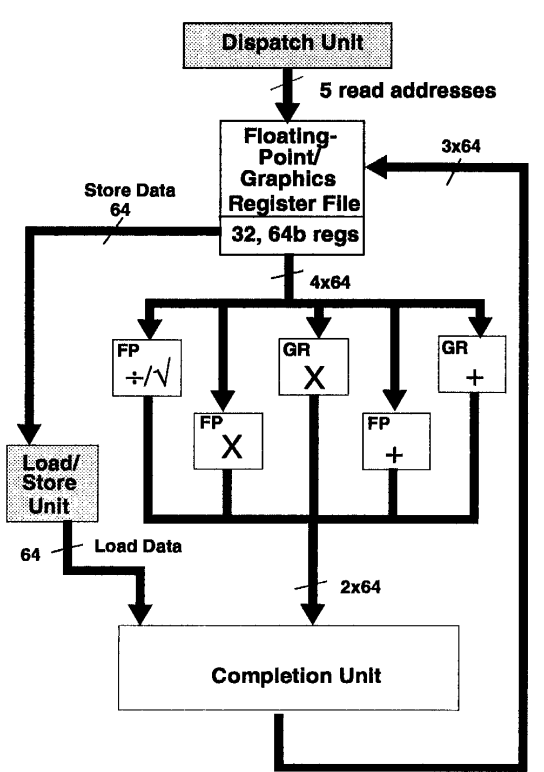
4.5 浮点/图形单元
- 浮点/图形寄存器文件具备 5 read ports / 3 write ports
- 32 个单精度 / 32 个双精度寄存器
- 5 个功能部件,除除法/平方根单元外全部流水化
- 高带宽:每周期 2 次 FGops
- 短延迟:
- FP compares:1 cycle
- FP add/subtract/convert:3 cycles
- FP multiplies:3 cycles
- FP divide/square root (sp/dp):12 / 22 cycles
- Partitioned add/subtract, align, merge, expand, logical:1 cycle
- Partitioned multiply, pixel compare, pack, pixel distance:3 cycles
4.6 加载存储单元
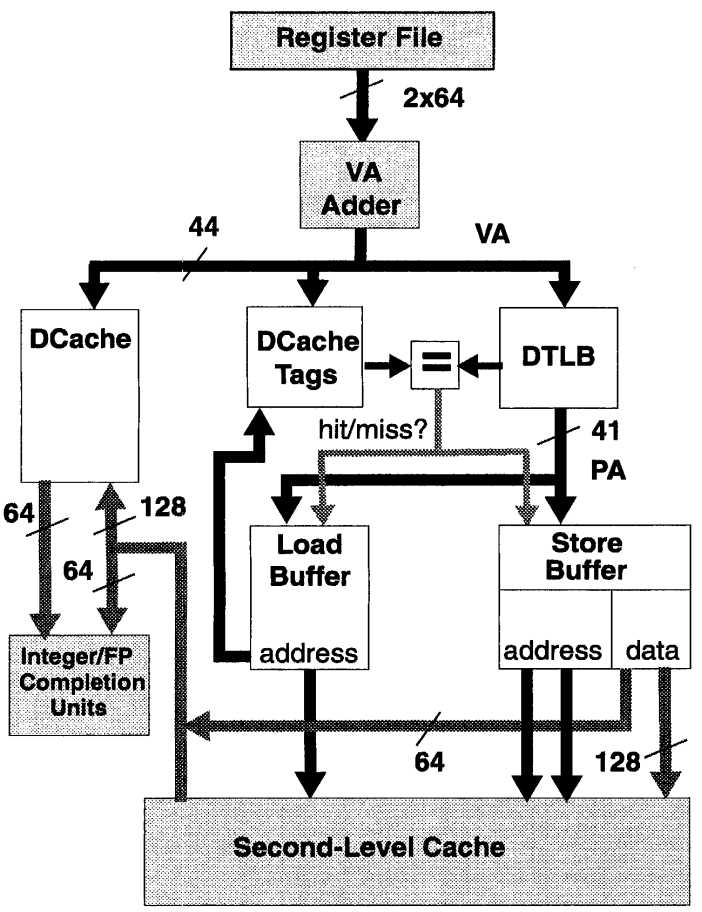
- 16 kB DCache(D$),direct-mapped,32B line size w/16B sub-blocks
- 64-entry 全相联 DTLB,支持多种页大小
- D$ 非阻塞(non-blocking),由 9-entry Load Buffer 支持
- D$ 标签双端口化,允许流水线的标签检查与 line fill / snoop 并行发生
- 从二级缓存(E$)持续每周期 1 次 load 的吞吐
- 通过解耦的数据 RAM 与标签 RAM,实现对 D$ 与 E$ 的单周期 store
- Store compression 大幅降低 E$ 总线占用
4.7 外部缓存与系统单元
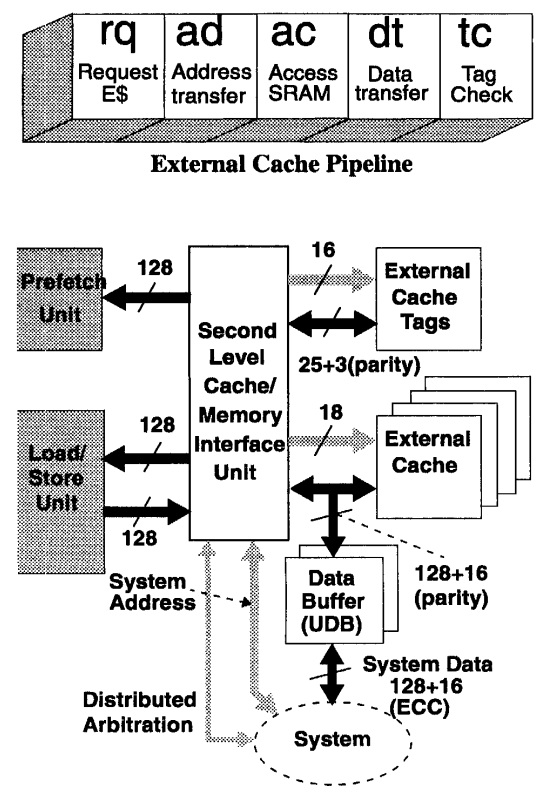
- E$ 容量 0.5 MB 至 4MB
- E$ 直接映射、物理索引与物理标签,64B line size
- 5 个缓存一致性状态:MOESI
- 使用带 1-entry 内部写缓冲的同步 SRAM
- 16B(+parity)E$ 接口,支持 2.6 GB/s 持续带宽
- UDB 在电气上把 CPU/E$ 与系统数据总线隔离
- 基于数据包的 16B 系统互连,地址总线与数据总线分离
- 带低延迟 parking mode 的分布式仲裁
- 系统总线频率为 CPU 时钟的 1/2 或 1/3
- 系统地址总线支持 4 个 CPU 模块与系统控制器
- 同时支持侦听式与目录式缓存一致性协议
5. UltraSPARC II / IIi / IIe
5.1 UltraSPARC II
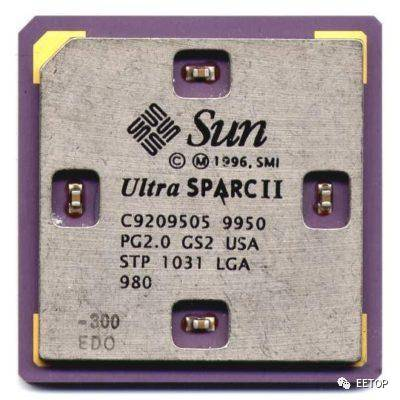
1997 年的 UltraSPARC II采用0.35μm 制程,时钟 250MHz;同时英特尔推出 300MHz 的 Pentium II,而 UltraSPARC II 的微架构基本沿用 UltraSPARC I——主要是工艺提升、时钟提升,以及兼容更新的外部缓存 SRAM 模式。
5.2 UltraSPARC IIi
1997 年的 UltraSPARC IIi采用0.35μm 制程,时钟 270–360MHz;整合 PCI 控制器的微幅改进版,从 256kB 激增到 2MB 的 L2 快取存储器是最大的亮点。
- TI Epic4 GS2,5-layer CMOS,2.6v core,3.3v I/O
- 12mm × 12.5mm die,5.75 million transistors
- 24 watts @ 300MHz,集成 I/O、内存、图形与中断接口
- Sun Visual Instruction Set - VIS(TM)
- 2-D、3-D 图形、图像处理、实时压缩/解压缩、视频特效
- 块加载与存储(64 字节块)可在任意源/目的对齐下,维持 300 MByte/s 的主存读写带宽
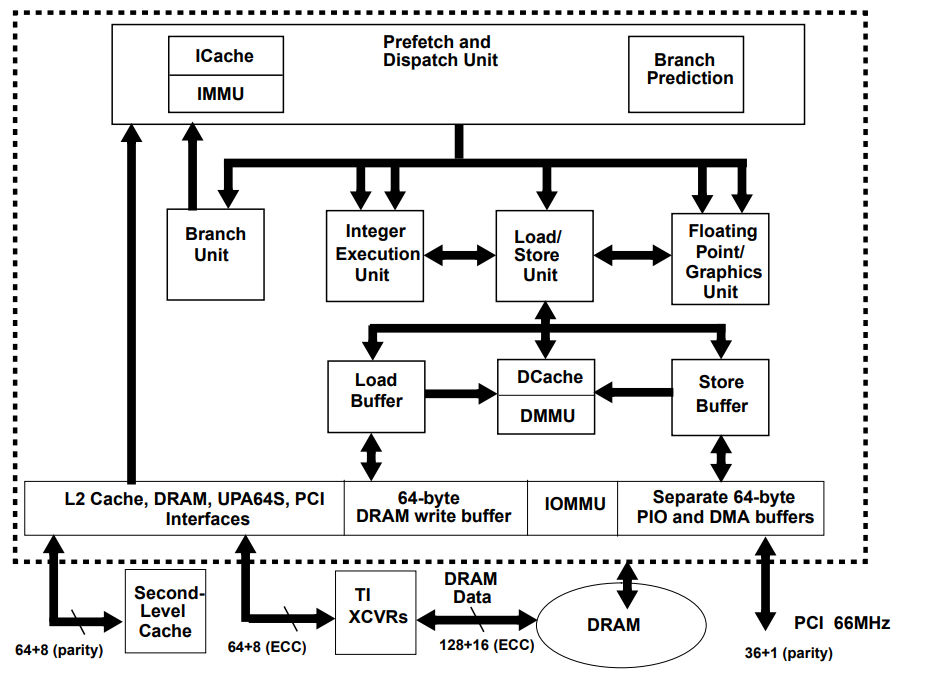
- 四路超标量指令派发
- 6 条流水线:2 条整数,2 条浮点/图形,1 条 load/store,1 条分支
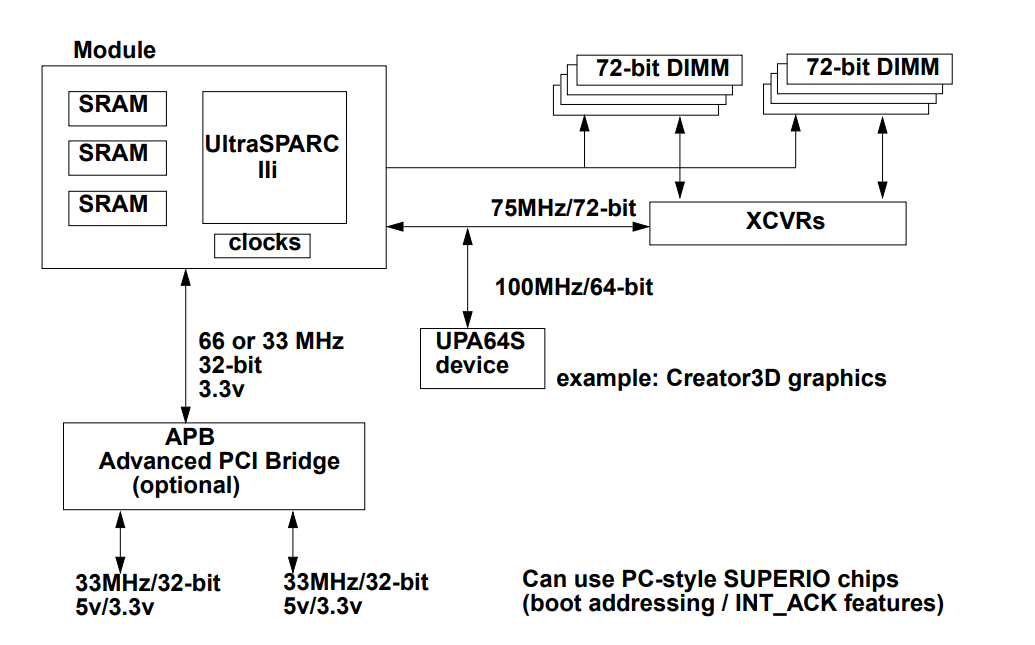
- 高带宽 / 低延迟接口
- 同步、片外 L2 缓存,0.25MB – 2MB
- 到 L2 缓存的 8 字节(+parity)数据总线(持续 1.2 GByte/s)
- 到 DRAM XCVR 的 8 字节(+ECC)数据总线(持续 400 MByte/s),或 UPA64S(持续 800 MByte/s)
- 4 字节 PCI/66 接口(持续 190 MByte/s)
- 指令预取
- 缓存内动态分支预测
- 每周期 1 个分支
- 2-way、16kB 指令缓存
- 非阻塞数据缓存
- 8-entry load buffer:仅在需要 load 数据时流水停顿
- 8-entry(每 entry 8 字节)store buffer,用于写穿至 L2 缓存
- D-cache 命中时单周期 load-use 惩罚
- 到 L2 缓存每 2 周期 1 次 load/store 的吞吐
- 到 L2 缓存的非阻塞软件预取
- 预取完成不受内存模型约束
- 编译器用它进一步隐藏 L2 miss 的延迟
- 同时支持小端与大端数据
- 作为 i-Series 的首款高度集成处理器,片上集成了 DRAM 内存控制器、UPA 控制器(最高 6.4 Gbps)与 32 位 66MHz PCI 接口;未完成的访存请求从 UltraSPARC I 的 1 个增加到 3 个 load 加 2 个 store
5.2.1 Instruction Pipelines
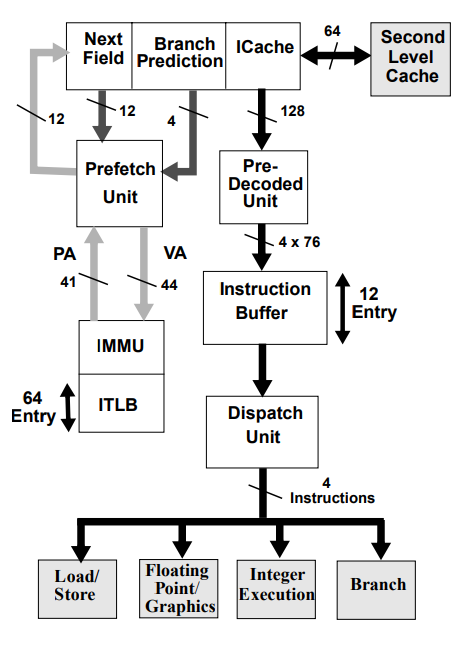
5.2.2 Prefetch 和Dispatch Unit
- 16kB ICache,2-way set associative,32B line size w/pre-decoded bits
- 2kB Next Field RAM,内含 1k 个分支目标地址与 2k 个动态分支预测项
- 用于取指预测的 4-entry Return Address Stack
- 分支预测(软件 / 硬件)
- 64-entry 全相联 ITLB,背后还有 1-entry µTLB
- 12-entry Instruction Buffer,由 ICache 或二级缓存供给
- 单周期派发逻辑,考察「最前」4 条指令
- 控制整数操作数的旁路(bypassing)
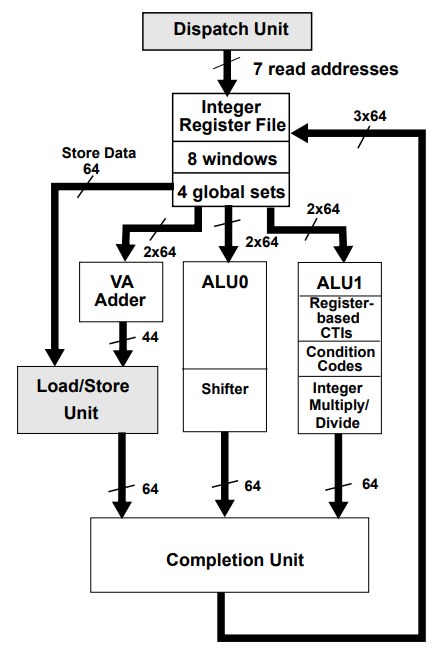
5.2.3 Integer Execution Unit
- 整数寄存器文件具备 7 读 / 3 写端口
- 8 个窗口,外加 4 组各 8 个全局寄存器
- 双整数流水线
- ALU0 执行移位指令
- ALU1 执行基于寄存器的 CTI、整数乘除,以及设置条件码的指令
- 整数乘法使用带「early out」的 2-bit Booth 编码
- 典型操作数的延迟为 5 周期
- 整数除法使用 1-bit 不恢复余数减法算法
- 完成单元(Completion Unit)在指令提交前缓冲 ALU / load 结果,提供集中式操作数旁路
- 精确异常,支持 5 级嵌套陷阱
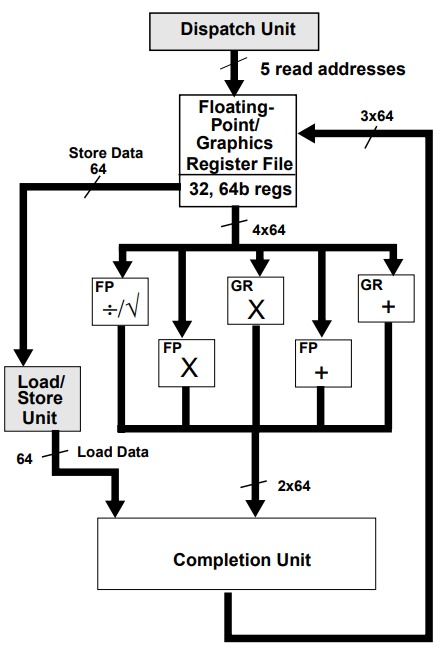
5.2.4 Floating-Point/Graphics Unit
- 浮点/图形寄存器文件具备 5 读 / 3 写端口
- 32 个单精度 / 32 个双精度寄存器
- 5 个功能部件,除除法/平方根单元外全部流水化
- 高带宽:每周期 2 次 FGops
- 完成单元在提交前缓冲结果,支持丰富的操作数旁路
- 短延迟
- Floating-point compares:1 cycle
- Floating-point add/subtract/convert:3 cycles
- Floating-point multiplies:3 cycles
- Floating-point divide/square root (sp):12 cycles
- Floating-point divide/square root (dp):22 cycles
- Partitioned add/subtract, align, merge, expand, logical:1 cycle
- Partitioned multiply, pixel compare, pack, pixel distance:3 cycles
5.2.5 Load/Store Unit
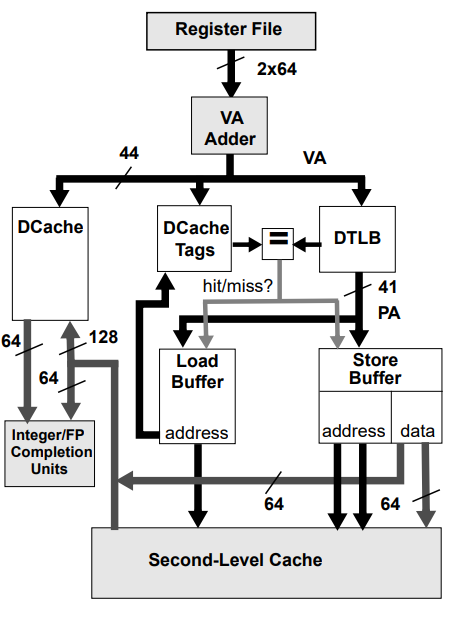
- 16 kB DCache(D$),direct-mapped,32B line size w/16B sub-blocks
- 64-entry 全相联 DTLB,支持多种页大小
- D$ 非阻塞,由 9-entry Load Buffer 支持
- D$ 标签双端口化,允许流水线的标签检查与 line fill / snoop 并行发生
- 从二级缓存(E$)持续每 2 周期 1 次 load 的吞吐
- 通过解耦的数据 RAM 与标签 RAM,实现对 D$ 与 E$ 的流水化 store
- Store compression 降低 E$ 总线占用
5.2.6 External Cache Control
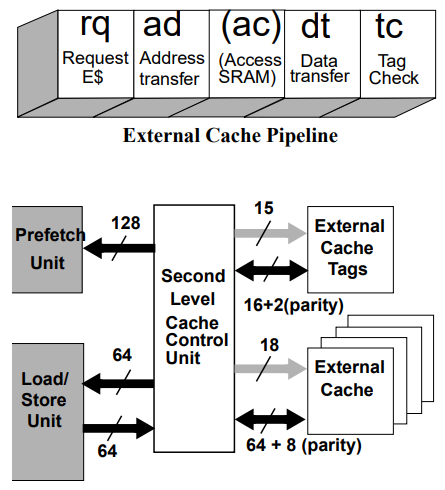
- E$ 容量 0.25 MB 至 2MB
- E$ 直接映射、物理索引与物理标签,64B line size
- 使用带延迟写的同步 SRAM
- 8B(+parity)E$ 接口,支持 1.2 GB/s 持续带宽
- 支持两种 SRAM 模式,兼容 UltraSPARC I 或 II 的 SRAM
- ad 与 dt 各占 2 个周期;在 22 模式 SRAM 下不存在 ac 阶段
- PCI 活动完全缓存一致
- 到 L1 数据缓存的 16 字节填充,所需的 8 字节优先
5.2.7 UltraSPARC-IIi System Example
5.3 UltraSPARC IIi(0.25μm)/ IIe / IIe+
1998 年的 UltraSPARC IIi采用0.25μm 制程,时钟 333–480MHz);当年 6 月时钟 400MHz 的首款英特尔 Xeon 问世,x86 世界总算有了服务器处理器专用的品牌。
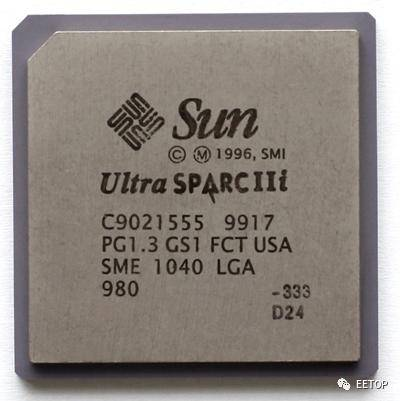
2000 年的 UltraSPARC IIe采用0.25μm 制程,时钟 400–500MHz;同时AMD 抢先在英特尔之前登顶 1GHz 大关。
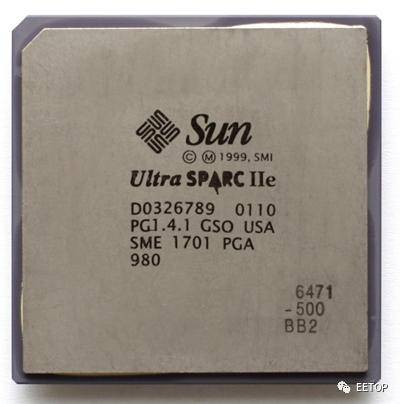
2002 年的 UltraSPARC IIe+ 采用0.18μm 制程,时钟 550–650MHz;与此同时,0.13μm 制程的英特尔 Pentium 4 / Xeon 已达 3GHz。
6. UltraSPARC III / IIIi
2001 年的 UltraSPARC III采用0.18μm 制程,时钟 600MHz;0.18μm 制程的英特尔 Pentium 4 / Xeon 时钟抵达 2GHz。同年发表的 UltraSPARC III Cu,终于靠着 0.13μm 制程和铜导线,冲破了 1GHz,真是可喜可贺。
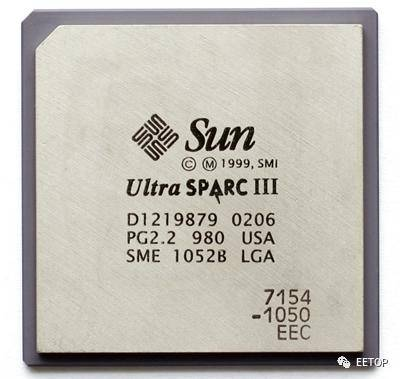
取代 Sun Enterprise 的 Sun Fire 服务器产品线,也一起和 UltraSPARC III 登场。
6.1 处理器概述
- 0.18 μm,TI C07a CMOS 工艺,六层铝互连
- 330 mm²
- 2900 万晶体管
- 600 MHz
- 70W @ 1.8V(CPU DB 记载 1.6V 下 TDP 53W)
- 35 SPECint95,60 SPECfp95
- 代码排程与系统软件兼容 UltraSPARC I、II
随后的 UltraSPARC III Cu(Cheetah+)改用 TI 0.13 μm、七层铜互连 CMOS 工艺,时钟提升至 1002–1200 MHz,die 面积缩小到 232 mm²。
6.2 流水线
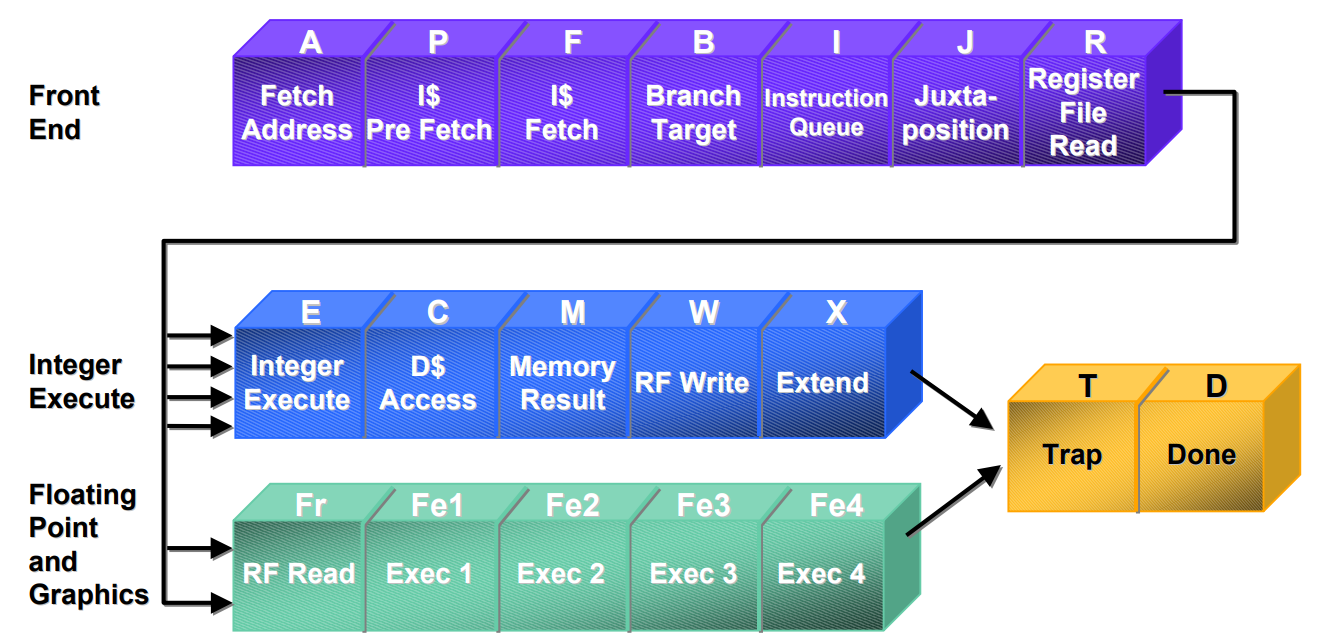
UltraSPARC III 换成了一条 14 级的流水线:
| 级 | 功能 |
|---|---|
| A | 地址生成 / 预译码 |
| P | I$ 访问第 1 拍 / 分支预测第 1 拍 |
| F | I$ 访问第 2 拍 / 预测第 2 拍 / 地址转换 |
| B | 分支目标计算 |
| I | 译码第 1 拍 |
| J | 译码第 2 拍 + 指令 steer |
| R | 读寄存器堆 / 相关检查 |
| E | 整数执行 / D$ 第 1 拍 |
| C | D$ 第 2 拍 / 浮点第 1 拍 |
| M | load 对齐 / 浮点第 2 拍 |
| W | 写寄存器堆 / 浮点第 3 拍 |
| X | 流水线延长 / 浮点第 4 拍 |
| T | trap |
| D | 写架构寄存器堆 |
6.3 分支预测与取指派发
改进的 Gshare 预测器采用16K 项 2 位饱和计数器,因为容量太大,访问本身分两级流水;误预测代价,taken 罚 3 拍(靠 4 项 miss queue 补救),not-taken 罚 7 拍,加权平均约 4.5 拍
- 每拍最多取指 4 条;20 项指令队列把取指侧与执行侧解耦
- 译码后每拍最多 6 条进入 dispatch,受执行管线资源与分组规则限制,实际 sustained 为 4-issue
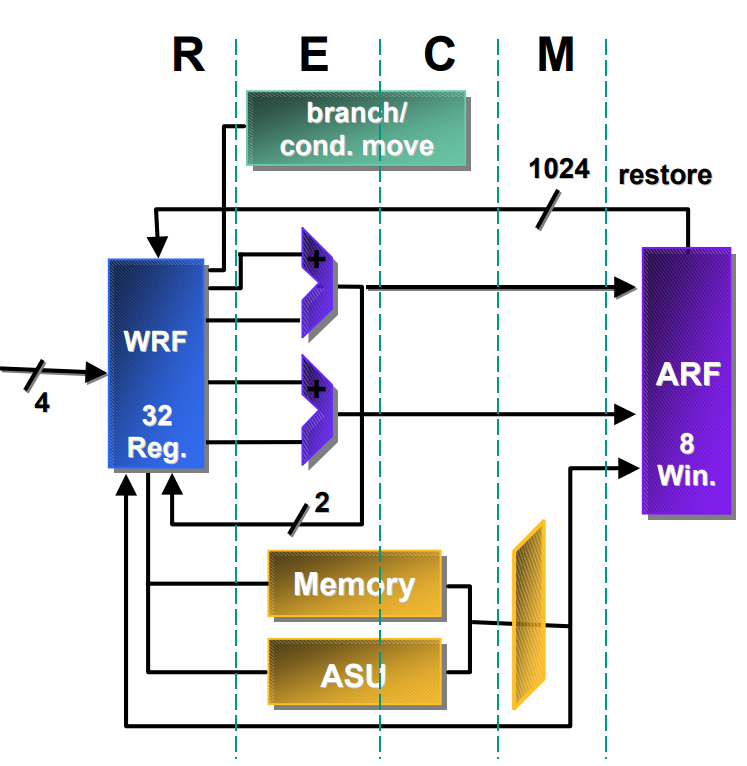
6.4 整数执行单元
- 4 integer issue
- Arithmetic/Special Unit (ASU)
- 两条整数管线(A0/A1,算术/逻辑/移位),其中一条只能做简单整数与 load;branch 有独立管线;整数乘除走 ASU,除法不流水
- 流水化的判定执行(predicated execution)
- 7R3W 端口寄存器文件
6.5 浮点/图形执行单元
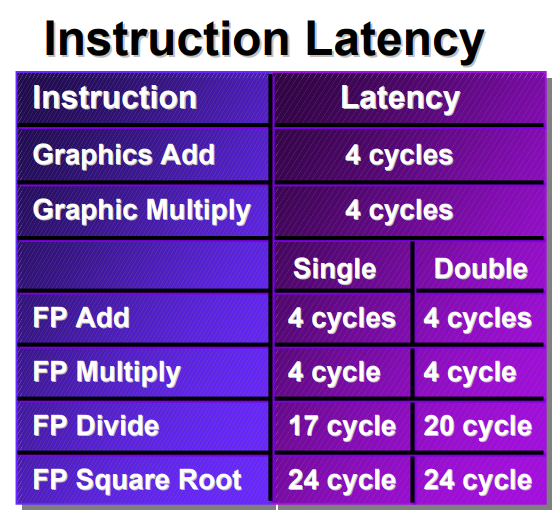
- 2 指令派发,来自
- FP/graphics add
- FP/graphics mul/div/sqrt
- 完全流水化的 FP/graphics add/mul
- 并发的 FP div/sqrt 单元
- 5 读、4 写端口寄存器文件
6.6 存储子系统
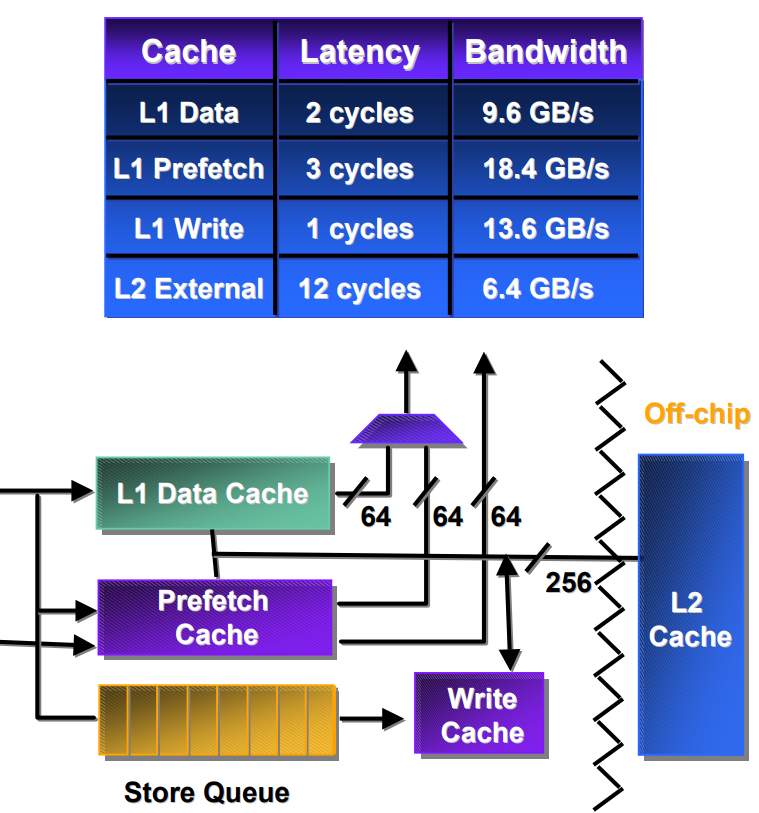
- L1 data cache:64KB,4-way associative
- L1 instruction cache:32KB,4-way associative,32B 行,wave-pipelined 两拍访问
- L1 prefetch cache:2KB,4-way associative
- L1 write cache:2KB,4-way associative
- L2 cache:1–8 MB,direct-mapped,片外;专用 256 位总线 @200MHz,峰值 6.4 GB/s,90KB 的标签放在片上
- 8 entry RAW forwarding store queue
- 片上内存控制器
6.6.2 Prefetch Cache
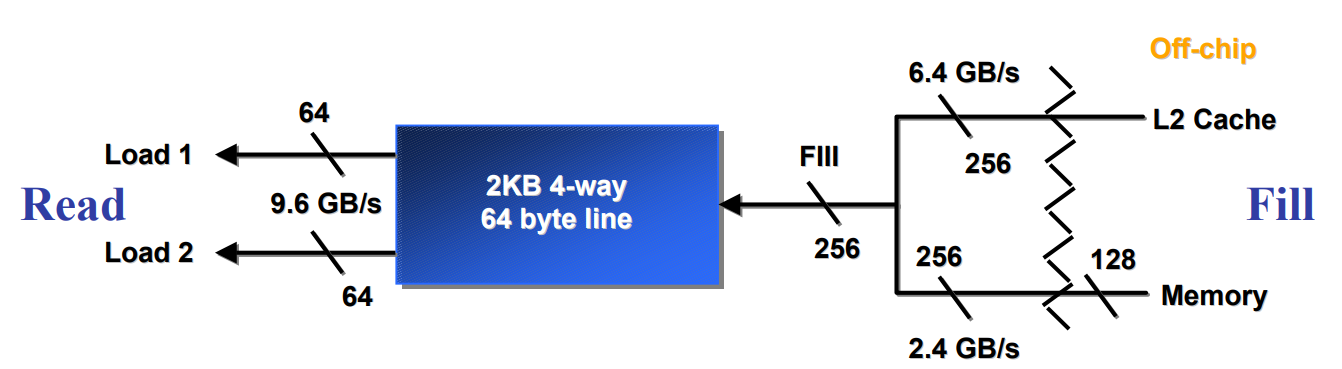
- 并发填充与双读
- 8 个未完成的软件预取
- 自主的硬件跨步预取(stride prefetch)
- 完全一致的缓存
6.7 内存控制器与 JBus
6.7.1 System Scaling
- 片上内存控制器
- 专用 128 位总线 @150MHz 直连本地 SDRAM,最多 4 个 bank、4GB
- 带宽随处理器增加而扩展
- 低延迟
- 片上侦听标签(snoop tags)
- 「No snoop」页
- 15 个未完成事务
- 带标签的事务(Tagged transactions)
- 符合 SPARC V9 TSO
- JBus 系统接口:128 位数据 + 43 位地址,150MHz;SIU 支持 15 个未完成事务与乱序数据返回
6.8 Sun Fire:UltraSPARC 在高端服务器的巅峰
之后 Sun Fire 和 Fujitsu 的 PrimePower,再一同被 Sun / Fujitsu 携手的 SPARC Enterprise 品牌取代,2010 年后,再统一更名成 SPARC M / T(与后来追加的 S)系列。
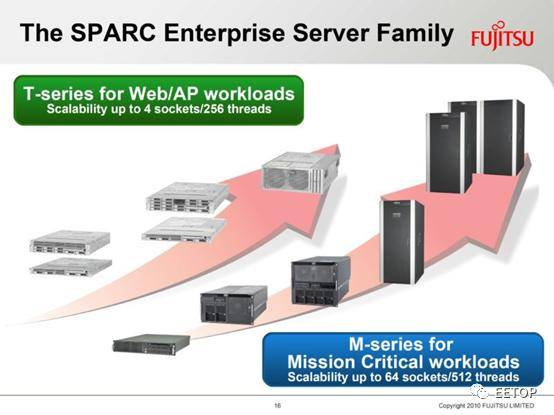
Sun Fire 也是 UltraSPARC 处理器在高端服务器的巅峰,Sun Fire 15K 最多支持 106 颗 UltraSPARC III Cu,而 Sun Fire E25K 更是 72 颗 UltraSPARC IV(144 核心)。15K 的核心是 150MHz 的 Sun Fireplane 冗余 18×18 交叉开关,整机聚合带宽 172.8 GB/s——这在 2001 年是个相当夸张的数字。
6.9 RAS
- L1 缓存与标签支持奇偶校验(单比特纠错)
- L2 与内存总线支持ECC
- JBus支持奇偶校验
- 侦听式一致性
6.10 UltraSPARC IIIi 与 Gemini
2003 年的 UltraSPARC IIIi采用0.13μm 制程,时钟 1GHz–1.6GHz;这年 AMD K8 让 x86 的世界深入 64 位元疆界,Opteron 处理器品牌也从此改变了 AMD 与 Sun 的命运。
6.10.1 Gemini 概述
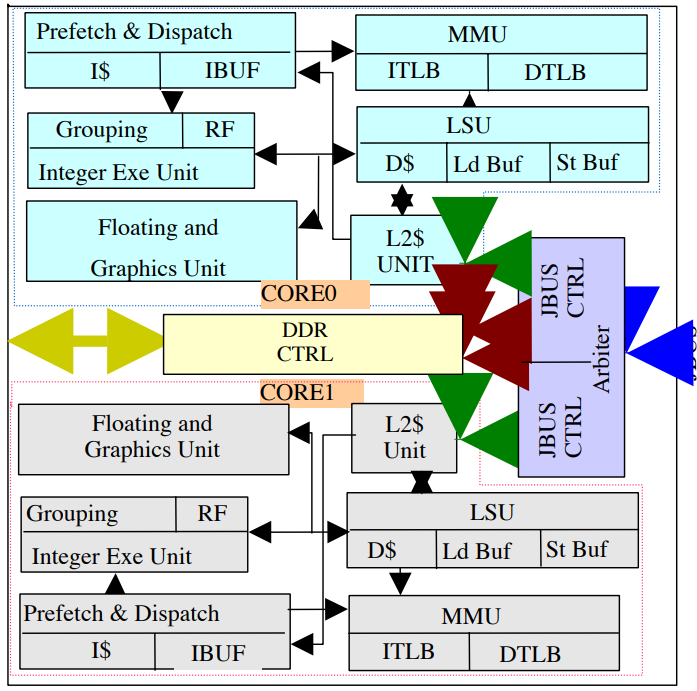
Gemini 是双核版本的 UltraSPARC IIIi:
- 双 4-issue superscalar 核心
- 基于 64-bit SPARC V9 处理器架构
- 每周期 2 个整数操作、2 个 FPU/graphics(VIS 1.0)操作
- 双集成 0.5MB L2 缓存(每核一个)
- 4-way set associative
- 每核支持 way-locking
- 与 UltraSPARC IIIi 处理器引脚兼容
- JBus 系统总线接口
- 集成到标准 DRAM 的内存接口
- 共享 128-bit DDR1 控制器
- 使用 2–4 条 DIMM,总容量最高 16 GB
- 电源管理模式(E*Star)
- 可切换到 Fcpu/2 或 Fcpu/32
- 强健的 RAS 支持
- L1 缓存、JBus 上的奇偶校验
- L2 缓存、DRAM 上的 ECC
- CMT 特性
- 软件控制的核心禁用(core disable)
- 动态的、缓存感知的核心停放(cache-aware core parking)
- 遵循 UltraSPARC CMT 架构规范
- Technology
- 晶体管数:80 million
- Die size:206 mm²
- 封装:959 pin ceramic uPGA
- 最大功耗:32 Watts @ 1.2 GHz,1.3V
- TI 先进的 130 nm CMOS 工艺,300 mm 晶圆,53 nm Leff,7LM Cu,low-k 介质(OSG),dual Vt
6.10.2 L2 Caches
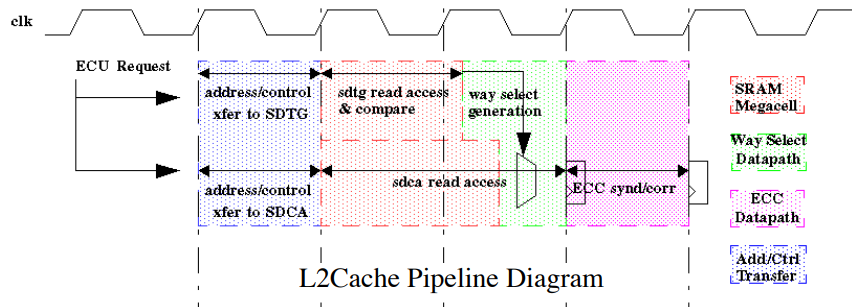
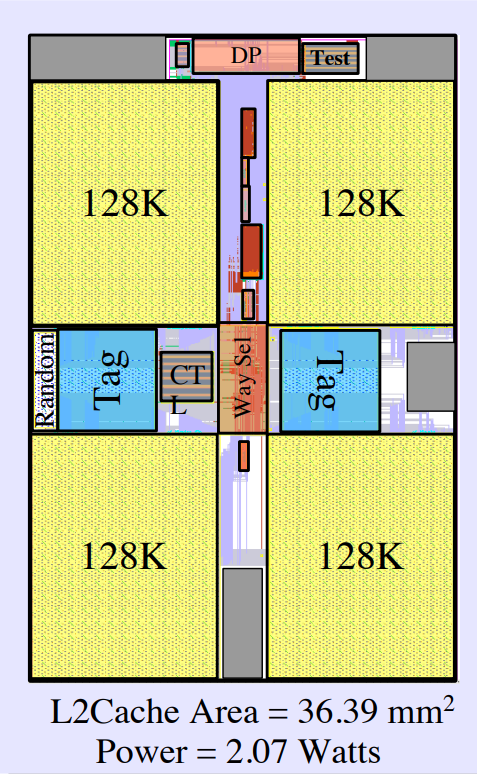
- 每核统一 512KB L2 缓存,4-way set associative,64B line size,伪随机替换
- 2-2 模式访问,4 周期延迟
- 64 位数据配 8 位 ECC,带物理位扰乱(physical bit scrambling),标签受奇偶保护
6.10.3 Memory Controller
- 两核共享的控制器
- DDR1 兼容
- 最多 4 条 DIMM(单面 / 双面)
- 总内存 256MB 至 16GB
- SSTL 输入 / 输出
- 内存接口:128-bit 数据 + 9 位 ECC 校验位
- E*Star 支持(Fcpu 的 1/2 或 1/32)
- PTB 追踪 16 个打开的页
- 峰值带宽 4.2 GB/s
- 实测本地访问延迟:96 ns
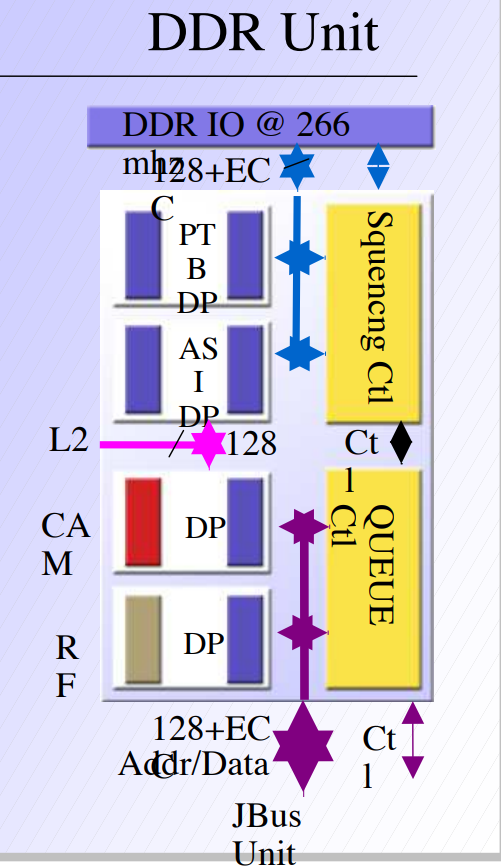
6.10.4 Memory Subsystem Details
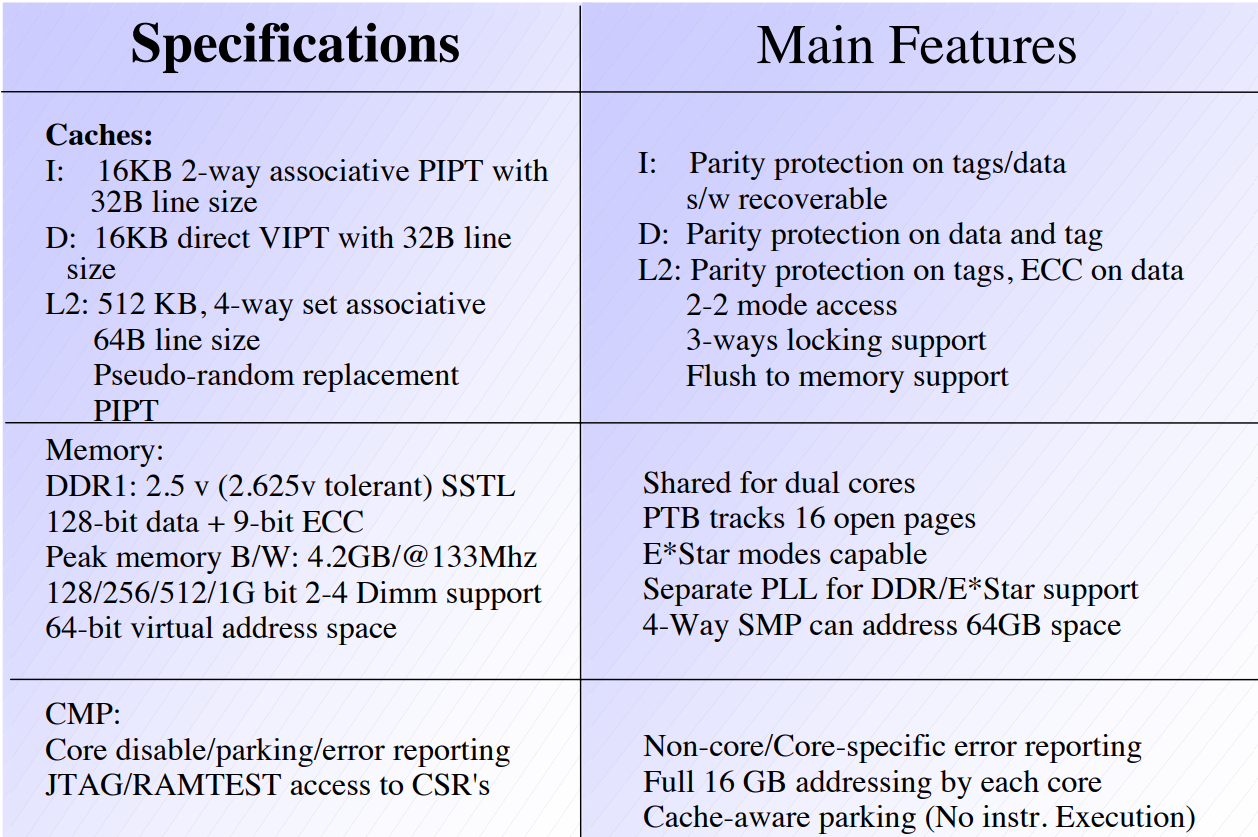
7. UltraSPARC IV / IV+
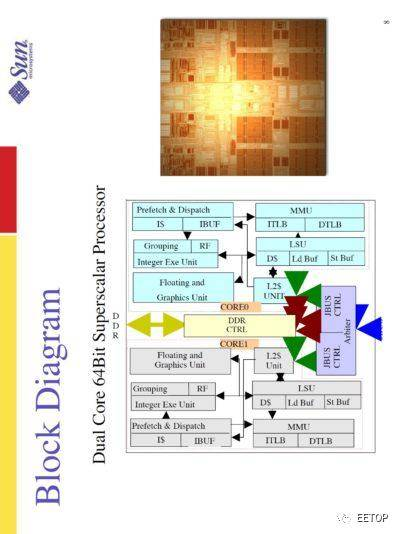
2004 年的 UltraSPARC IV 采用0.13μm 制程,时钟 1GHz–1.3GHz;UltraSPARC 处理器跻身双核心之列(等于 2 颗改良版 UltraSPARC III),那年刚好是 IBM Power5 在高端服务器市场的效能战争横扫千军的高峰。
2004 年,Sun 宣布腰斩 UltraSPARC V「Millennium」 与双核心 「Gemini」(即 UltraSPARC IIIi 的双核衍生版本,详见 6.10 节)之后的高性能核心规划。
7.1 UltraSPARC IV
UltraSPARC IV 的做法很实在,把两颗 UltraSPARC III 核心装进同一块 die,每核自带独立的 L1 缓存与 16 项指令队列,共享经切分的 16MB 片外 L2,对外仍是同一套 JBus / Fireplane 接口——封装、功耗与散热规格都与 UltraSPARC III 保持一致,可以直接替换进既有系统,Sun 用最低的成本把整机性能翻了一倍。
- TI 130nm CMOS,6600 万晶体管
- 时钟 1.2–1.35GHz,最大功耗 102W
7.2 UltraSPARC IV+
2005 年的 UltraSPARC IV+ 采用0.09μm 制程,时钟 1.5GHz–2.1GHz,传统UltraSPARC 处理器的绝响。这时双核心 64 位英特尔 Xeon 和 AMD Opteron 已在服务器市场杀声震天,再次确立 x86 处理器主导服务器市场和云端数据中心的大势。
IV+ 不只是工艺升级——90nm、9 层铜互连、2.95 亿晶体管、336mm²、90W——缓存层次做了大改,从「L1 + 片外 L2」变成三级:
- L1:I$ 加倍到 64KB,D$ 64KB,2KB prefetch cache 保留,2KB write cache 改为全相联
- L2:片上 2MB,4 路组相联,半频运行,写回
- L3:片外 32MB,4 路组相联,victim / exclusive 策略,标签放在片上
零零碎碎的改进还有prefetch buffer 从 1 行扩到 8 行,I-TLB 加到 512 项,新增 32 项 BTB,D-TLB 支持 32MB / 256MB 大页,硬件 POPC 指令,FPU 的 IEEE 754 异常处理增强;I$ / D$ / prefetch cache 与 I/D-TLB 全部加上了硬件错误检测。
8. UltraSPARC T1(Niagara)
8.1 处理器概述
Sun 在 2004 年逐步重整服务器产品布局,除了短暂推出英特尔 Xeon 处理器的 Sun Fire V60 系列,兵分三路,成果可简述成以下数点:
- 通用型服务器:Sun 成为率先压宝 AMD Opteron 的一线服务器大厂,并推出「Galaxy」系列服务器,8 颗 Opteron 的 Sun Fire M4600 为象征。这件事对 AMD 也意义深远,不仅提升 AMD 验证产品的能力,更强化企业用户对「AMD 服务器」的信心。
- 高效能服务器:与 Fujitsu 携手 APL(Advanced Product Line),沿用 SPARC64 系列,标榜大型主机等级的可靠性。
- 网站与数据库:Sun 购并 Afara Websystems 后,以追求「像瀑布般的巨大数据吞吐量」的 Throughput Computing 为名,集中资源打造针对网站服务器特化的 UltraSPARC T 系列(Niagara) 与数据库导向的 UltraSPARC RK(Rock)。
其中最值得大书特书的就是奠定 Sun SPARC 处理器发展方向的 Throughput Computing:
简单多核心、超多线程、大量存储器频宽。
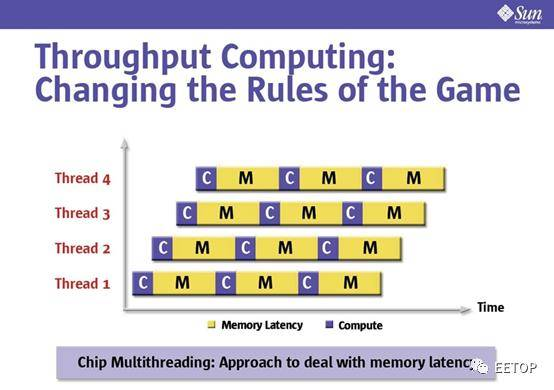
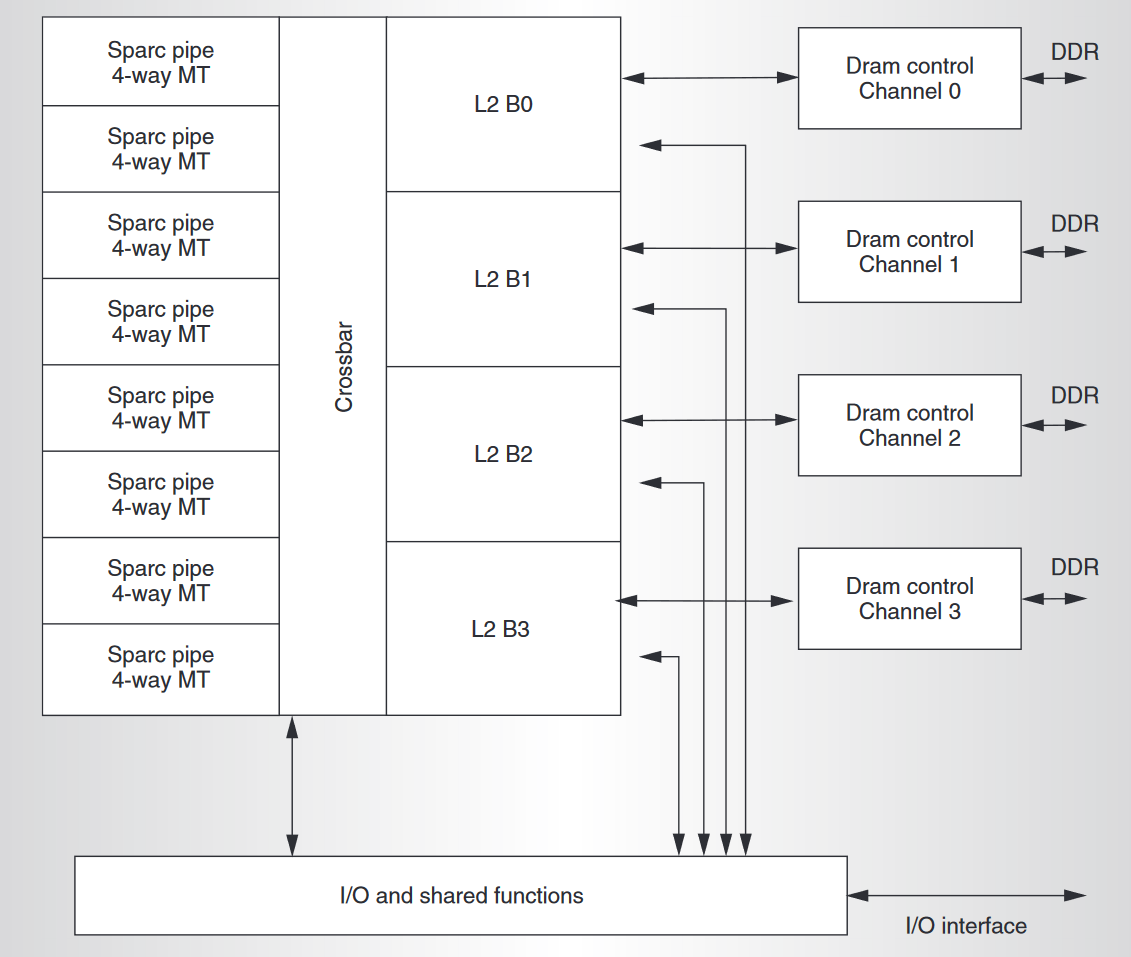
Niagara 提升商业服务器应用吞吐量的方法,是在处理器上支持数量急剧增加的线程,以及为更高带宽而扩展的存储子系统。Niagara 在硬件上支持 32 个执行线程:架构把四个线程组织成一个线程组(thread group),线程组共享一条处理流水线,称为 Sparc pipe。Niagara 使用 8 个这样的线程组,因此 CPU 上共有 32 个线程。每个 SPARC pipe 都带有指令与数据的一级缓存。硬件通过把组内其他线程调度到 SPARC pipe 上来隐藏给定线程的内存与流水线停顿,线程切换代价为零周期。
32 个线程共享一个 3 MB 的二级缓存。该缓存为4 路分体(banked)并流水化以提升带宽,并采用12 路组相联以减轻多线程带来的冲突失效。商业服务器代码存在数据共享,可能导致很高的一致性失效(coherence miss)率。在采用分立处理器与一致性互连的传统 SMP 系统中,一致性失效要经过低频的片外总线或链路,延迟可能很高。Niagara 通过共享的片上缓存消除了这些失效,代之以低延迟的共享缓存通信。
交叉开关(crossbar) 提供 SPARC pipe、L2 缓存分体与片上其他共享资源之间的通信链路,提供超过 200 GB/s 的带宽。每个源—目的对都有 2 项的队列,交叉开关每个方向最多可排队 96 个事务。交叉开关还提供一个用于 I/O 子系统通信的端口。目的端口的仲裁采用简单的基于年龄(age-based)的优先级方案,保证所有请求者之间的公平调度。交叉开关也是整机的内存定序点(point of memory ordering)。
内存接口为 4 通道 DDR2 DRAM,支持超过 20 GB/s 的峰值带宽与最高 128 GB 的容量。
8.2 SPARC Pipe
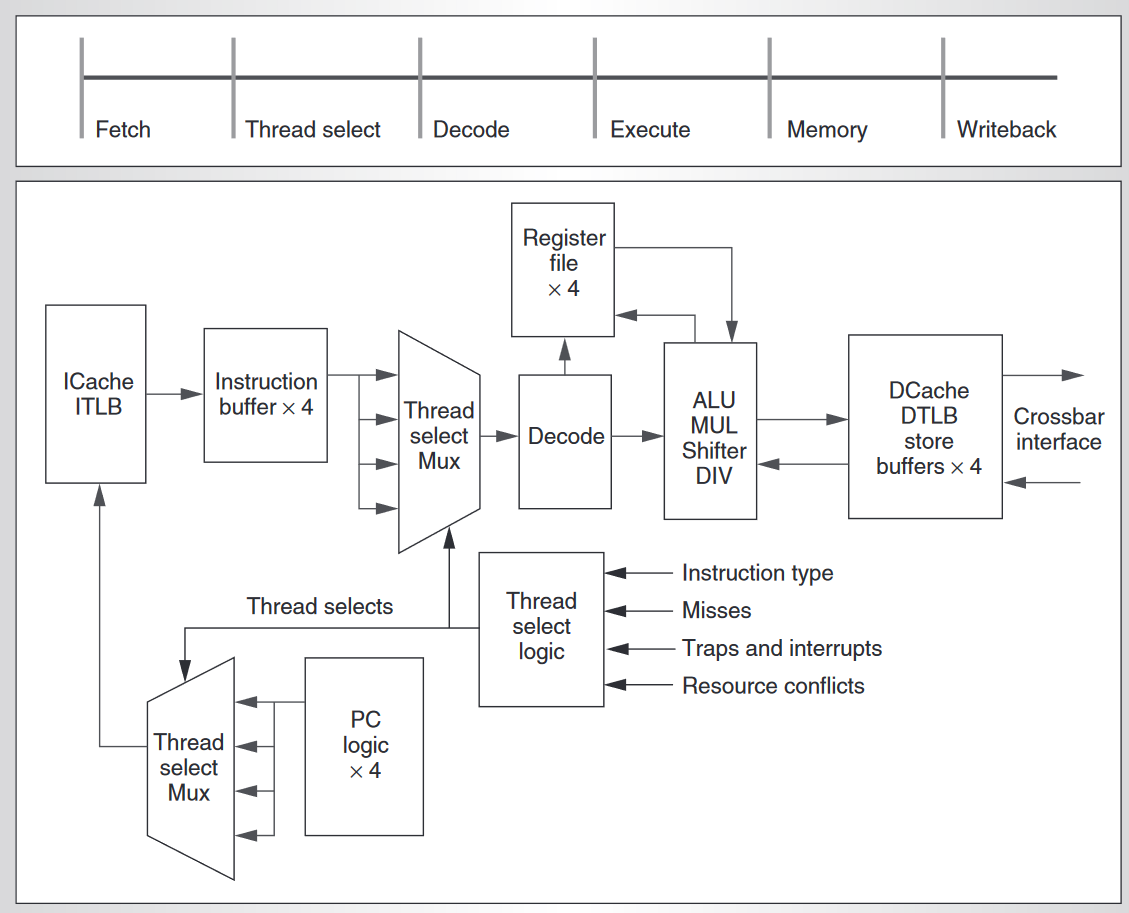
每个线程都有一套独有的寄存器、指令缓冲与存储缓冲。线程组共享 L1 缓存、TLB、执行单元和大部分流水线寄存器。Niagara 实现了一条单发射、六级的流水线:取指(fetch)、线程选择(thread select)、译码(decode)、执行(execute)、访存(memory)和写回(write back)。
- 取指阶段:访问指令缓存与指令 TLB(ITLB)。下一阶段通过选择 way 完成缓存访问。关键路径由 64 项全相联 ITLB 的访问决定。线程选择多路器决定四个线程程序计数器(PC)中的哪一个来执行访问。流水线每周期取两条指令。缓存中的预译码位标识长延迟指令。
- 线程选择阶段:线程选择多路器从可用线程池中选择一个线程,把一条指令发射到下游阶段。该阶段同时维护指令缓冲。若下游阶段不可用,取指阶段从缓存取出的指令可以插入相应线程的指令缓冲。前两个阶段的流水线寄存器为每个线程各复制一份。
- 译码阶段:来自被选中线程的指令进入译码阶段,执行指令译码与寄存器文件访问。支持的执行单元包括 ALU、移位器、乘法器与除法器。旁路单元处理那些必须在寄存器文件更新前传递给相关指令的结果。ALU 与移位指令延迟为单周期,结果在执行阶段产生。乘法与除法为长延迟操作,会引发线程切换。
- 加载存储单元:包含数据 TLB(DTLB)、数据缓存与存储缓冲。DTLB 与数据缓存的访问发生在访存阶段。与取指阶段类似,关键路径由 64 项全相联 DTLB 的访问决定。加载存储单元内含四个 8 项存储缓冲,每线程一个。检查存储缓冲中的物理标签可以识别 load 与 store 之间的 RAW 相关,存储缓冲支持把数据旁路给 load 以解决 RAW 相关。存储缓冲的标签检查发生在写回阶段早期的 TLB 访问之后。load 数据在写回阶段后期可供旁路给相关指令。像
ADD这样的单周期指令将在写回阶段更新寄存器文件。
8.3 寄存器文件
整数寄存器文件具备 3 读 2 写端口。读端口对应单发射机器的需求;第三个读端口用于处理 store 以及少数三源指令。两个写端口分别处理单周期操作与长延迟操作。组内不同线程的长延迟操作(load、乘法、除法)可能同时产生结果,这些指令将仲裁寄存器文件的长延迟写回端口。
SPARC V9 架构规定了如下图所示的寄存器窗口实现。单个窗口由 8 个 in、8 个 local、8 个 out 寄存器组成,在给定时刻对某个线程全部可见。一个窗口的 out 寄存器在寻址上等价于下一个顺序窗口的 in 寄存器,但它们是同一组物理寄存器。每个线程有 8 个寄存器窗口,四组这样的寄存器集支持四个线程,线程之间不共享寄存器空间。寄存器文件总共由 640 个 64 位寄存器组成,是一个 5.7 KByte 的结构。
支持大量的多端口寄存器,无论从面积还是访问时间考量都是重大挑战。Niagara 选择了一种创新的实现,以维持紧凑的面积和单周期访问时间:
- 过程调用可以请求一个新窗口,此时可见窗口上滑,旧的
out变成新的in;调用返回时窗口下滑。 - 线程可见的寄存器集合是工作集(working set),用快速的寄存器文件单元实现。
- 全部寄存器的集合是架构集(architectural set),用紧凑的六晶体管 SRAM 单元实现。
- 一组传送端口(transfer port)连接两个寄存器集;窗口变更事件触发线程取消选择与新旧窗口之间的数据传送。
8.3.1 Thread selection policy
线程选择策略是每周期在可用线程之间切换,优先选择最近最少使用(LRU)的线程。线程会因为长延迟指令(如 load、分支、乘法和除法)而变为不可用,也会因为流水线停顿(如缓存失效、陷阱和资源冲突)而变为不可用。
线程调度器假定 load 会命中缓存,因此可以投机地发射同一线程的相关指令。但是,与能够发射非投机指令的线程相比,这种投机线程在指令发射时被赋予更低的优先级。
8.4 存储子系统
- L1 指令缓存 16 KB,4-way set-associative,块大小 32 bytes,采用随机替换方案以节省面积,且不带来显著性能损失。指令缓存每周期取两条指令;如果第二条指令有用,指令缓存会有一个空闲槽,流水线可用来处理行填充而不停顿。
- L1 数据缓存 8 KB,4-way set-associative,行大小 16 bytes,采用写穿(write-through)策略。
- 尽管 L1 缓存很小,它们仍显著降低了每线程的平均访存时间,失效率在 10% 量级。由于商业服务器应用的工作集往往很大,要让失效率显著下降,L1 缓存必须大得多,从面积角度看这种取舍并不划算。然而,线程组内四个线程有效隐藏了 L1 与 L2 失效的延迟,因此这些缓存容量是失效率、面积与”其他线程隐藏延迟的能力”之间一个良好的折中。
Niagara 使用简单的缓存一致性协议:L1 缓存写穿,load 时分配、store 时不分配;L1 行只有 valid 与 invalid 两种状态。L2 缓存维护一个影子化 L1 标签的目录,并把数据以 64 字节粒度交错分布在各分体上。L1 失效的 load 会连同其在 L1 中的替换 way 一起送到 L2 的源分体;在那里把该 load 失效地址写入目录对应的 L1 标签位置,访问 L2 取得缺失行,然后把数据返回 L1。目录因此以 L1 行粒度维护一个共享者列表。随后来自不同或相同 L1 的 store 会查找目录,并把失效请求排队发给持有该行的 L1 缓存。store 在更新 L2 之前不会更新本地缓存,在此期间 store 可以把数据传给同一线程但不能传给其他线程,因此 store 在 L2 缓存中获得全局可见性。
交叉开关在同一与不同 L2 分体的事务之间建立内存定序,并保证以相同的顺序把事务投递到 L1 缓存。L2 缓存采用写回(copy-back)策略:淘汰脏行时写回,淘汰干净行时直接丢弃。来自 I/O 设备的 DMA 通过 L2 缓存定序。四通道 DDR2 DRAM 提供超过 20 GB/s 的内存带宽。
9. UltraSPARC T2(Niagara-2)
UltraSPARC T2 是 Sun Microsystems 第二代多核多线程 SPARC 片上系统(SoC)。它在几乎相同的功耗包络内,提供了第一代 UltraSPARC T1 两倍的吞吐性能。
UltraSPARC T2 通过 8 个 SPARC 核心、每核心 8 个硬件线程,支持 64 个线程并发执行。各个核心通过高带宽交叉开关通信,共享一个 4MB、8 分体的 L2 缓存。每个 SPARC 核心包含两个整数执行单元和一个专用的浮点与图形单元,在 1.4 GHz 下提供 11.2 GFLOPS/sec 的峰值浮点吞吐;每个核心还带一个密码学单元。
在 I/O 方面,UltraSPARC T2 集成了一条 x8 PCI-Express 通道与两个带 XAUI 接口的 10G 以太网端口。内存通过 4 个片上控制器访问,每个控制器管理 2 个 FBDIMM 通道,峰值内存带宽超过 60 GB/sec。UltraSPARC T2 采用 11 层金属、1.1V、三阈值 CMOS 工艺制造,芯片在 342 mm² 的 die 上集成约 5 亿个晶体管,1.4 GHz 下功耗 84 W。
高度的系统集成,加上高吞吐量、浮点与密码学性能,UltraSPARC T2 的目标负载是 Web 服务器、数据库与应用服务器、HPC、安全网络、园区骨干网与文件服务器。
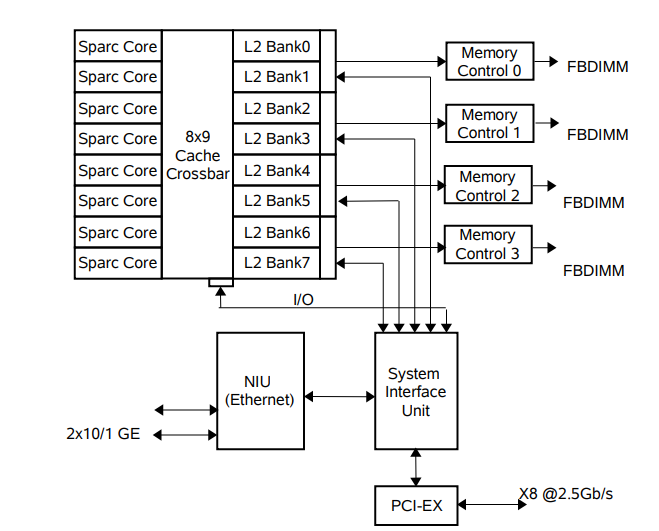
L2 缓存的每个分体为 16 路组相联,行大小 64 字节。8 个 L2 分体支持 8 个并发访问,以满足 UltraSPARC T2 的高带宽需求。SPARC 处理器核心通过高带宽、非阻塞、流水化的交叉开关与 L2 缓存通信;该交叉开关把 8 个 SPARC 核心连接到 8 个 L2 分体与 I/O 端口,总写带宽 90 GB/sec、总读带宽 180 GB/sec。
L2 缓存连接到 4 个片上 DRAM 控制器,后者直接对接一对全缓冲 DIMM(FBDIMM)通道,峰值链路速率 4.8 Gb/sec。选择 FBDIMM 是因为它以不到 DDR2 一半的引脚数提供了约 2 倍的带宽。UltraSPARC T2 的峰值内存带宽为读 50 GBytes/sec、写 26 GBytes/sec。
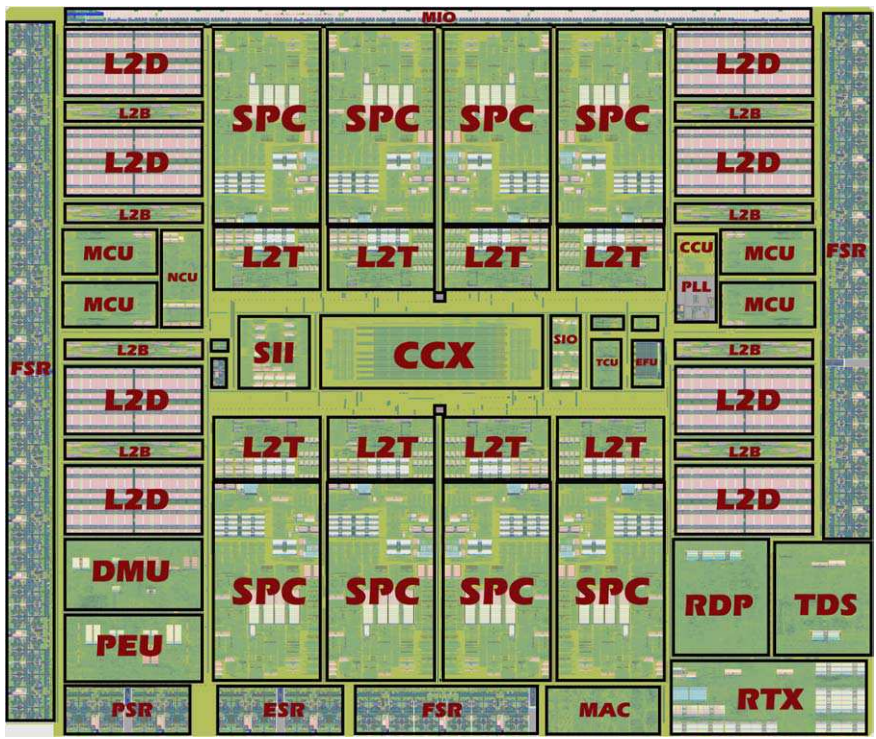
9.1 SPARC Core
UltraSPARC T2 上的每个 SPARC 处理器核心都完整地在硬件上支持 8 个独立线程的执行。该核心由取指单元(IFU)、两个整数执行单元(EXU0 与 EXU1)、一个浮点与图形单元(FGU)、一个加载存储单元(LSU)、一个流处理密码学单元(SPU)、陷阱逻辑单元(TLU)、内存管理单元(MMU) 与gasket unit 组成。
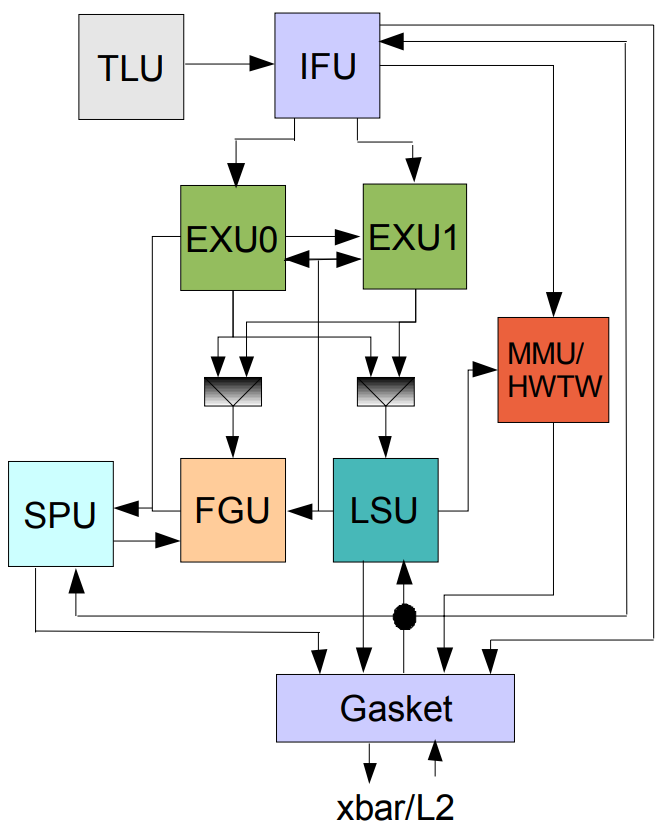
8 个线程被静态划分为两个各含 4 个线程的线程组 TG0 与 TG1;线程组内的 4 个线程共享一个 EXU。FGU 与 SPU 中的执行引擎由全部 8 个线程共享。
- IFU 内含 16KB、8 路组相联、行大小 32 字节的一级指令缓存,以及 64 项指令 TLB,均由 8 个线程共享。
- LSU 内含 4 路组相联、行大小 16 字节的一级数据缓存,以及 128 项数据 TLB,均由 8 个线程共享。
- MMU 支持 8KB、64KB、4MB 与 256MB 页,并实现一个硬件页表遍历引擎(hardware table walk engine)用于快速重载 TLB,该引擎由 8 个线程共享。
- TLU 处理异常与中断,并负责维护每个线程的机器状态。
- Gasket 把来自处理器核心的内存与 I/O 请求送往交叉开关,接收来自 L2 与 I/O 端口的响应,并把响应送给相应的 SPARC 核心。
UltraSPARC T2 实现细粒度多线程 ,在静态划分的线程组 TG0 与 TG1 内,以「最近最少发射」的优先级方案,在可用线程之间逐周期切换线程。当某线程遇到长延迟事件(如缓存失效)时,它被标记为不可用,直到该事件完成前不会从该线程发射指令。每周期最多发射两条指令,每个线程组各一条,可以是两个整数操作、一个整数加一个访存操作、一个整数加一个浮点操作,或一个浮点加一个访存操作。这种细粒度多线程方案把分支误预测与缓存失效带来的吞吐损失降到最低。
9.1.1 Core Pipeline
UltraSPARC T2 对整数操作实现八级流水线,load-use 惩罚为 3 个周期。浮点流水线对相关浮点操作的延迟为 6 个周期。
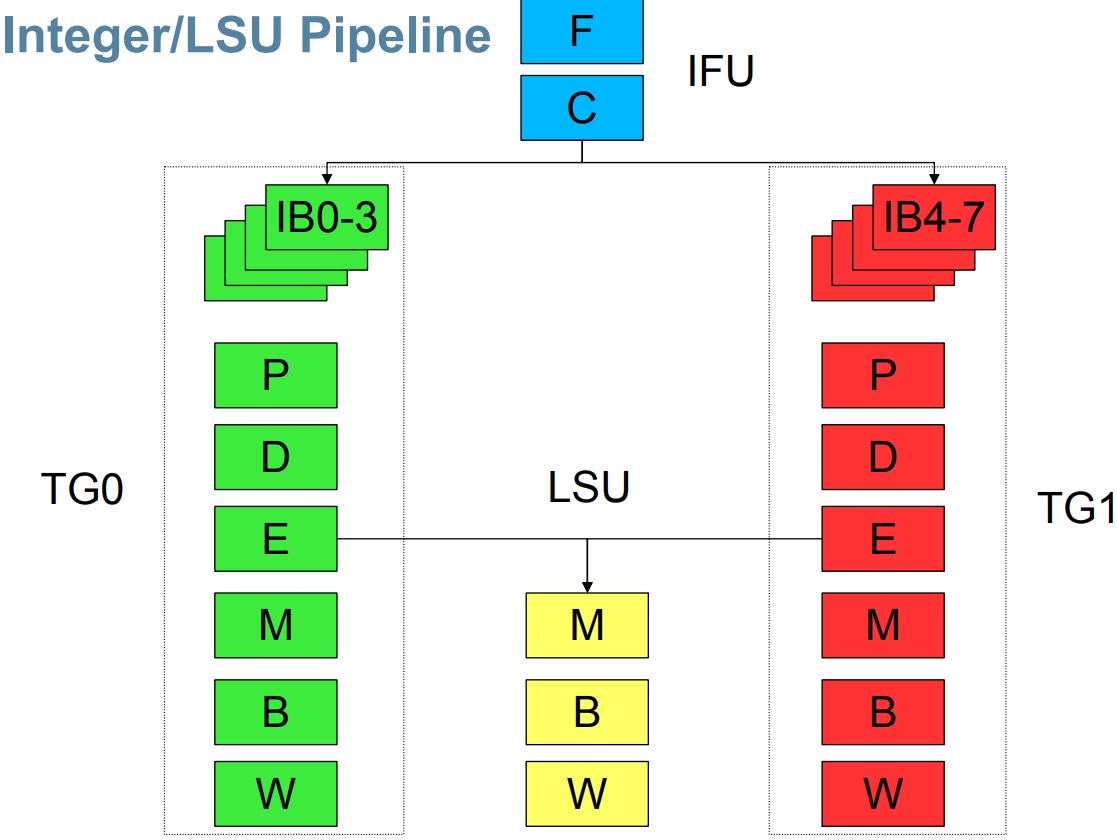
9.1.2 IFU
- 面向 8 个线程的指令缓存与 fetch/pick/decode 逻辑
- 每周期从 I$ 取最多 4 条指令
- 线程处于 ready 或 wait 状态
- wait 状态:TLB miss、cache miss、指令缓冲满
- 在 ready 线程中取「最近最少取指」者
- 每线程一个指令缓冲
- 无分支预测
- predict not-taken,5 周期惩罚
- 有限的 I$ miss 预取
- 取指与 Pick 解耦
- 线程分为 2 组,每组 4 个线程
- 每周期从每个线程组各拾取(pick)一条指令
- 在线程组内 ready 线程中取「最近最少拾取」者
- wait 状态:相关、D$ miss、DTLB miss、divide/sqrt……
- 优先非投机线程(例如非 load hit)
- 译码消解冲突
- 每个线程组独立拾取
- 两个线程组都可拾取 load/store 或 FGU 指令
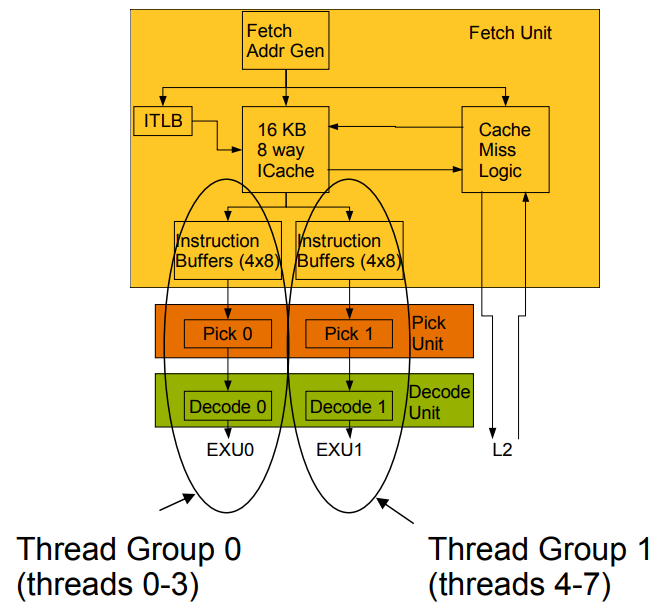
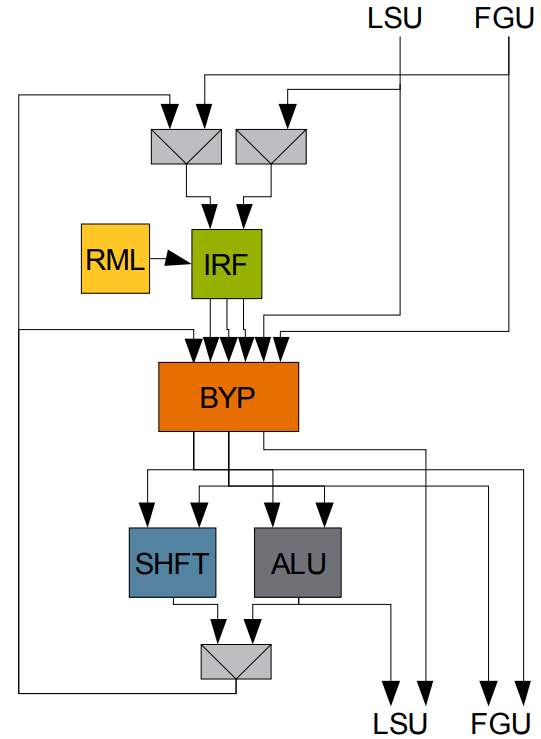
9.1.3 EXU
- 执行整数操作
- 部分图形操作
- 每个 EXU 保存 4 个线程的状态
- 整数寄存器文件(IRF)每线程 8 个寄存器窗口
- 窗口管理逻辑(RML)
- 加法器、移位器
- 为 load/store 操作生成地址
9.1.4 LSU
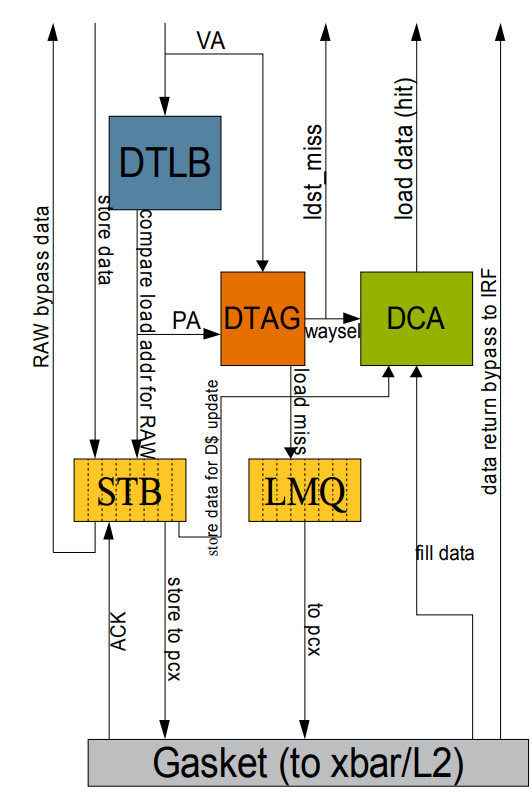
- 每周期一次 load 或 store
- D$ 为 store-through
- D$ 填充与 store 并行进行
- Load Miss Queue (LMQ)
- 每线程一个未完成的 load miss
- D$ 在 load miss 时分配,在 store hit 时更新
- Store buffer (STB) 每线程 8 个 store
- 到同一 L2 缓存行的 store 流水化送往 L2
- 在 load miss 与 store 之间为交叉开关仲裁
- 公平性算法
9.1.5 MMU
- 最多 4 个页表的硬件 tablewalk
- 每个页表支持一种页大小
- 三种搜索模式:
- Sequential——按顺序搜索页表
- Burst——并行搜索页表
- Prediction——基于 VA 预测要搜索的页表
- 用于前两次页表搜索排序的两位预测器
- 最多 8 个未完成的 miss
- 每线程一个 ITLB 或 DTLB miss
9.1.6 FGU
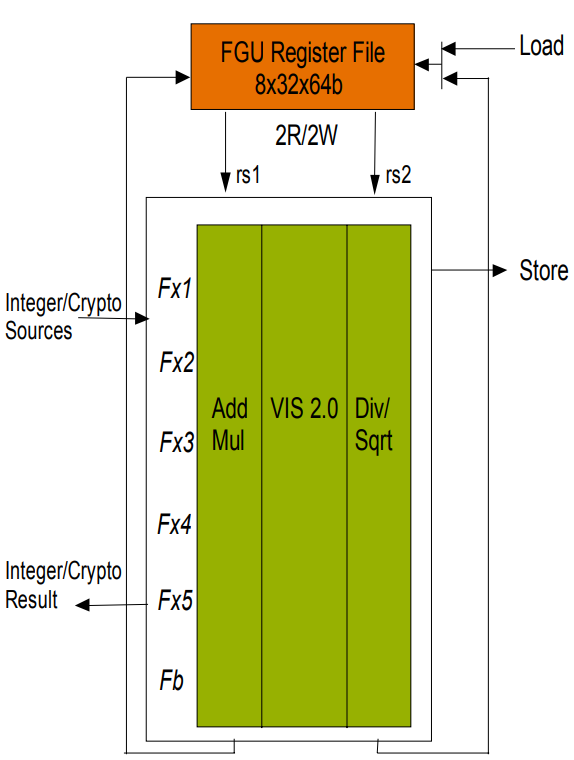
- 除 divide/sqrt 外完全流水化
- divide/sqrt 与其他线程的加法或乘法操作并行执行
- FGU 执行整数乘法、除法、popcount
- 面向模运算的乘法器增强
- 内置累加器
- XOR multiply
9.1.7 SPU
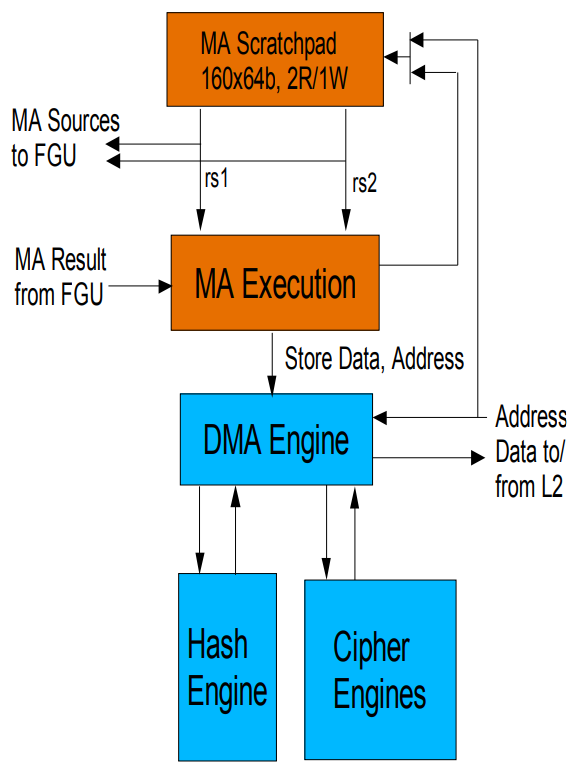
密码学流处理单元(SPU) 用于加速 SSL、TLS 与 IPsec 等安全协议中频繁使用的通用加密与认证操作。密码组(CG) 子单元支持批量加密与认证操作,模运算(MA) 子单元支持公钥密码学,两者彼此独立运行。
CG 子单元的设计目标是在两个 10Gb 以太网端口上支持线速的批量密码与哈希操作,相当于 5 GB/sec 的全双工数据带宽。CG 子单元内含 RC4、DES/3DES 以及全部 AES 变体(128、192、256 位密钥长度)的专用硬件引擎,支持 AES 的 ECB / CBC / CTR 模式与 DES 的 ECB / CBC / CFB 模式,并在硬件上支持 MD5、SHA-1 与 SHA-256 认证函数(含密钥哈希 HMAC)。UltraSPARC T2 上的 8 个 SPU 各自提供 1/8 的处理能力,在 1.4 GHz 下聚合达到 5 GB/sec 的数据速率。
MA 子单元加速 IPsec 与 SSL/TLS 等安全协议的密钥交换、密钥生成与认证功能,通过模幂运算直接以硬件支持最高 2048 位密钥的 RSA、DSA 与 Diffie-Hellman 操作,此外还支持使用椭圆曲线密码学(ECC) 的密钥交换与签名生成/验证,具体说就是加速各种标准化曲线、密钥长度超过 600 位的二元域与整数域上的点乘运算。
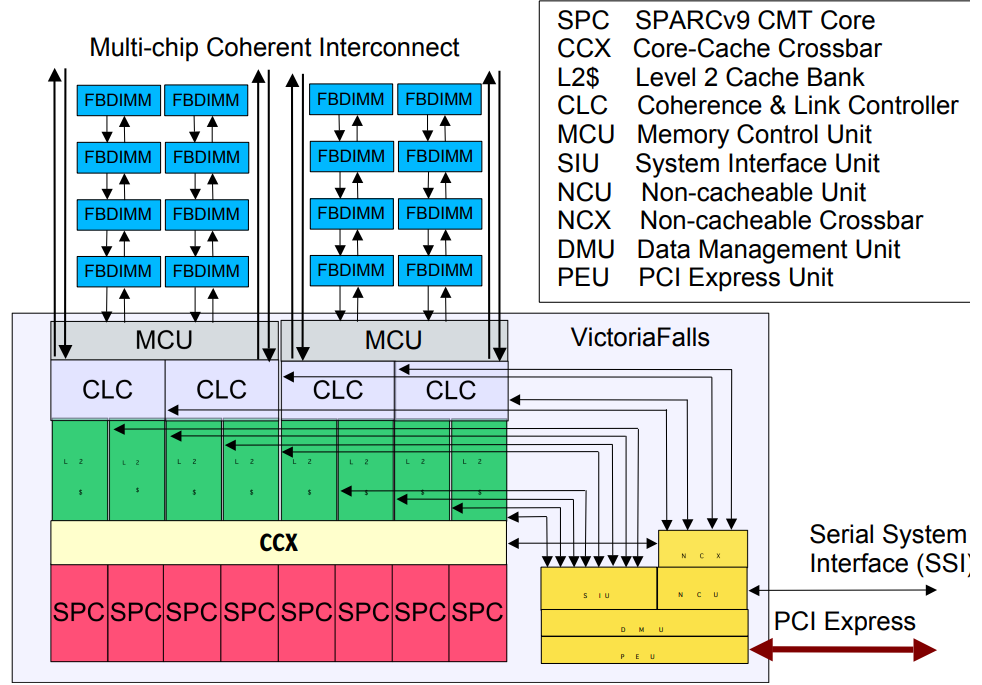
9.2 Victoria Falls 芯片多处理器
Victoria Falls 是 UltraSPARC T2 的双芯片版本:
- 8 核 CMP,每核 8 Strands @ 1.4GHz
- Niagara2 SPARCv9 核心
- 2 × 8-stage 整数单元(每流水线 4 线程),每流水线单发射
- 12-stage 流水化 FGU(除 divide/sqrt)
- 集成密码学加速器
- 16KB 8-way SA L1-I$,32B 行,写穿
- 8KB 4-way SA L1-D$,16B 行,写穿
- 64 项全相联 I-TLB
- 128 项全相联 D-TLB
- 4 MB 共享 L2$
- 2 个双通道 FBDIMM 内存控制器
- 集成 PCI Express I/O 桥
- 多芯片一致性链路
9.2.1 High Level Block Diagram
- SPC Memory Model
- TSO 合规性由核心 Load/Store 单元与 L2$ 交叉开关共同维持
- 例外是那些明确不需要支持 TSO 的指令
- 非阻塞的核心—L2$ 交叉开关
- 在来自相同与不同 L2$ 分体的事务之间建立内存定序
- 保证以相同顺序把事务投递到 L2$ 分体
- 180 GB/sec 命中带宽
- 并发度
- 每线程 8 项深的 store buffer
- 每处理器最多 384 个事务(L2$ 上限)
- 4MB 共享 L2$
- 8 个分体,各自独立的 L2$ 流水线
- 64B 缓存行,写回,Modified-LRU 替换
- 维护 L1$ 标签的目录
- 最小化 L2$ 冲突
- 有限的线程投机
- 高组相联度(每分体 16 路)
- 组索引哈希(Set Index Hashing)
- 微并行化挑战
- 把串行代码段划分给并发的工作者线程
- 无锁同步原语
- 通过为核间通信优化的公共 L2$ 降低同步开销
- 由于热锁、真实或伪数据共享,L1-D$ 无需侦听
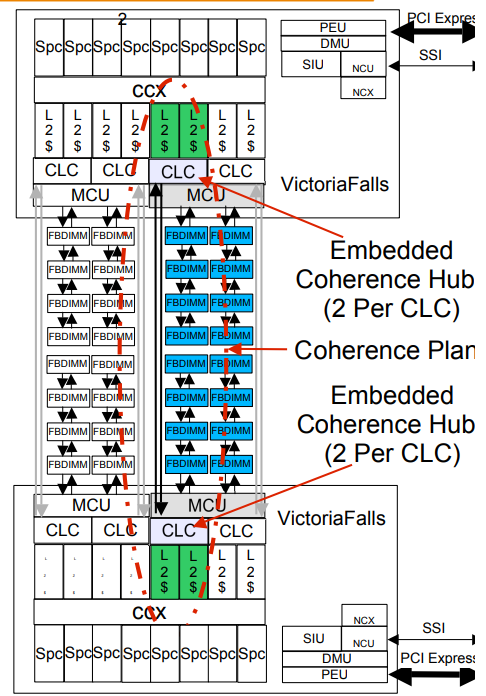
- 基于侦听的一致性互连
- 物理地址划分到 4 个一致性平面(Coherence Planes)
- 用点到点链路取代多条总线
- 支持芯片直连或 Hub/Star 物理拓扑
- 多分体 L2$ 提供充裕的侦听带宽
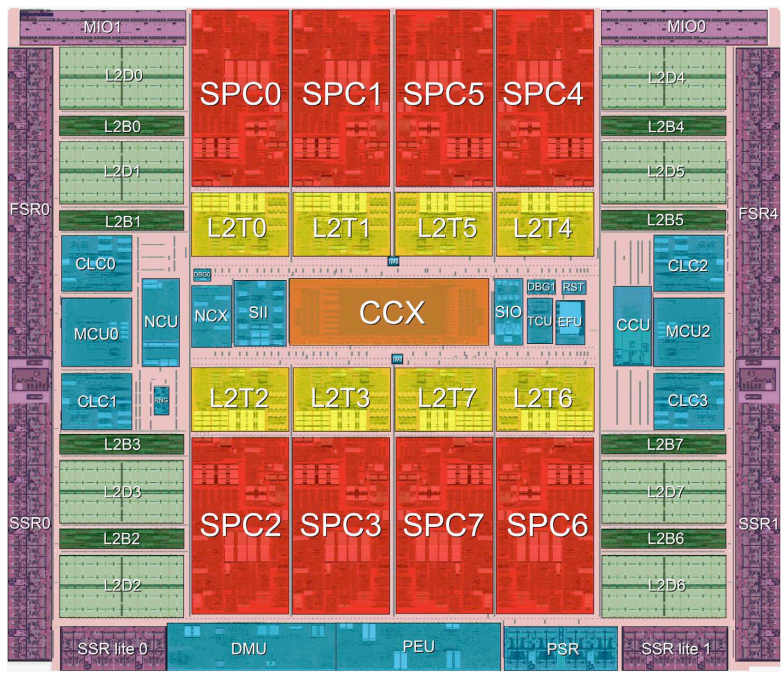
65nm CMOS,11 Metal Layer,709 Signal I/O,1831 Total I/O
9.2.2 Multi-chip Interconnect
- 分布式的全局定序点
- 各一致性平面彼此独立运行
- 物理地址冲突由一致性 Hub 串行化
- 缓存状态:MOESI,由 L2$ 跟踪
- 对 M、O、E 与 S(MCU 节点)状态的侦听命中引发 C2C 传输
- 3 个虚拟通道之间独立的包处理
- 乱序(OOO)侦听响应
- 公平性算法
- 超越停滞侦听继续推进
- 物理层
- 每通道 14 条发送与 14 条接收 lane
- 4.8 GT/sec,每方向 8.4 GB/sec 原始链路带宽
- 时钟恢复、位/符号对齐、初始化与训练
- 可靠的点到点数据链路层
- 定长帧:144 bit 载荷 + 24 bit CRC
- 7.2 GB/sec 载荷带宽,每链路 6.4 GB/sec 峰值数据带宽,全双工
- 硬件帧重传、链路重训练与 lane 失效切换,并维持完整的 CRC 连续性
- 虚拟通道:Request / Request-ack / Response / Data+Critical Data
- 事务层:3/7/18 字节包,可跨越帧边界;出向虚拟通道队列的加权轮询仲裁
10. SPARC Rock(UltraSPARC RK)
2010 年取消的 UltraSPARC RK,就是让人感到极度惋惜的未竟之憾了:
- 16 个 4 指令派发、非循序预测执行的核心(Sun 的历史创举)
- 每个核心 2 条同时多线程(SMT)
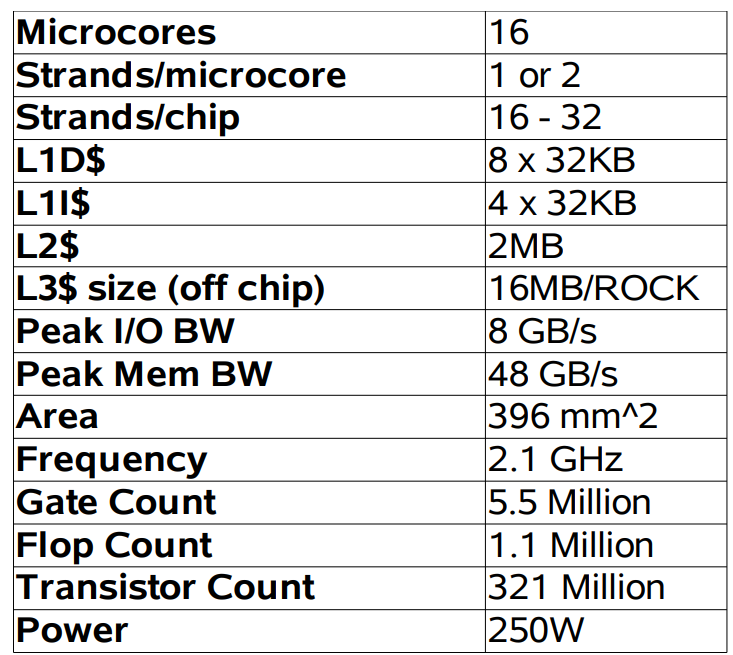
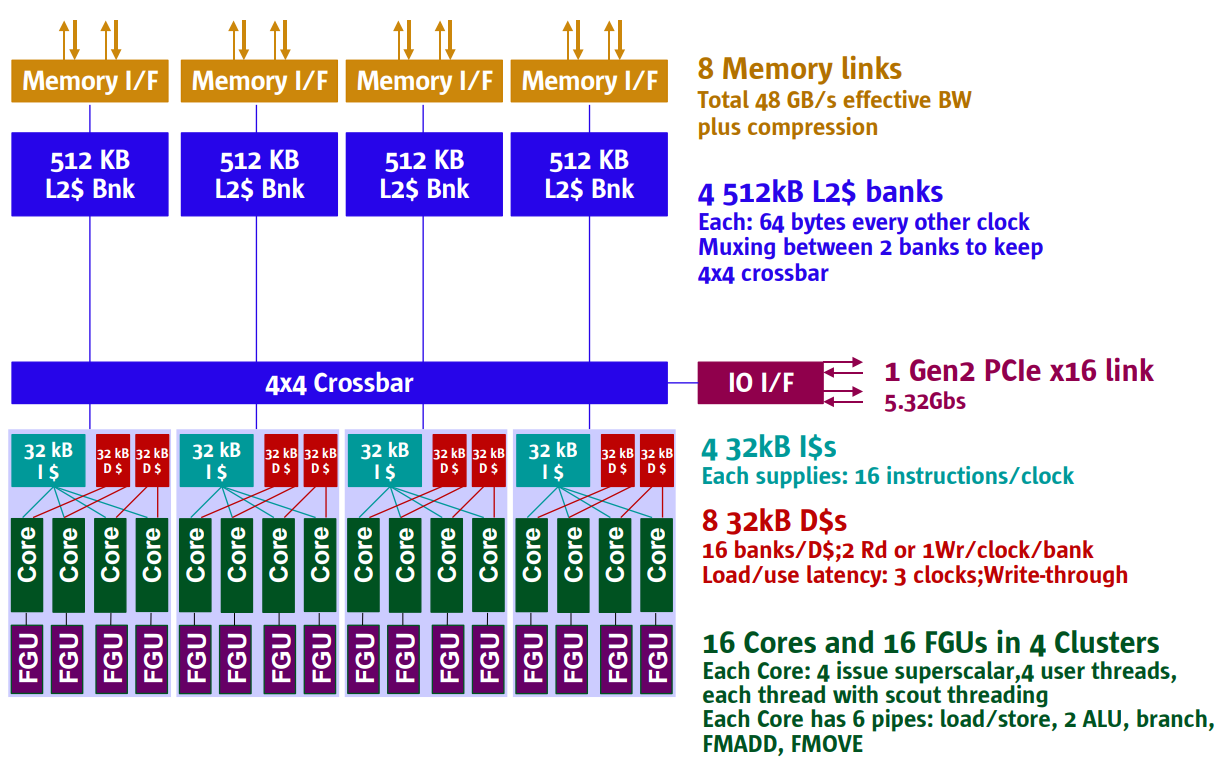
- 总计切成 4 个丛集(Cluster),每个丛集共享 1 个 32kB 指令缓存、2 个 32kB 数据缓存、2 个浮点运算器
- 耗电量高达 250W
- 具备更精细的多线程存储器数据同步 Transactional Memory(近似英特尔 TSX)
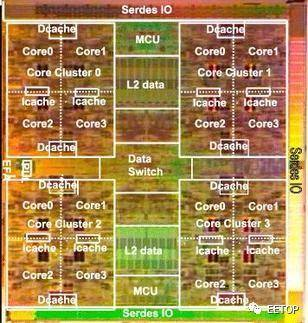
10.1 芯片组织
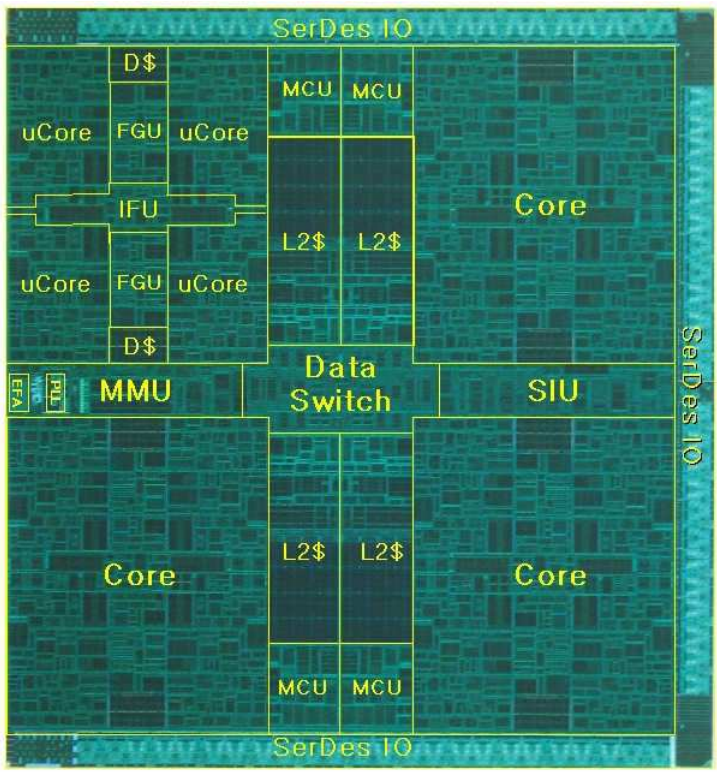
65nm 工艺,396mm²,时钟 2.3GHz。16 个核心切成 4 个簇,每簇 4 核:
- 每簇共享一个取指单元(IFU),round-robin 服务簇内 8 个 strand,每周期取一整条 16 指令的缓存行
- 每簇共享 32KB、4 路组相联的 L1 I$(64 项 4 路 ITLB)
- 每对核共享 32KB、4 路、双端口的 L1 D$(各自私有 tag 阵列,load-use 3 周期;32 项 2 路 skewed-associative、带 way 预测的 micro-DTLB)
- 每核 32 项 store buffer:2 路分体、支持 store merging;写命中同时更新 D$ 与 L2,写 miss 只更新 L2、不在 D$ 分配
- L2 共 2MB:4 个 512KB、8 路的分体,经交叉开关连接 4 个簇、MMU 与系统接口
10.1.1 Floorplan
10.2 流水线与执行
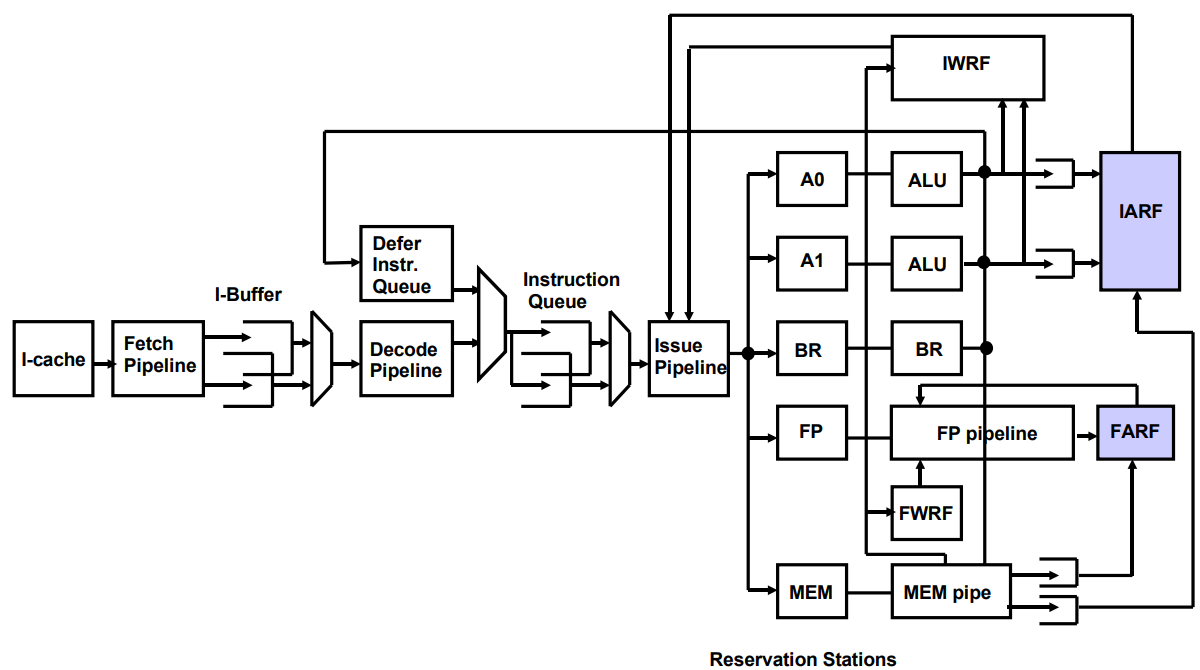
- 译码单元带 helper ROM,负责把复杂指令拆成微操作
- 每周期最多 4 条指令分配到 5 个各 3 项深的 issue FIFO:A0(简单整数)、A1(复杂整数,如前导零检测)、BR、FP、MEM(每周期 1 条 load/store);FIFO 之间可以乱序推进
- 暂时无法完成的指令进入 deferred queue(DQ)——一块单端口 SRAM
- 非投机状态下每周期最多退休 4 条;投机成功时经 join 可以不限量批量提交
10.3 分支预测
- 60-Kbit gshare:30K 个 2 位饱和计数器,并利用 SPARC V9 的软件预测位
- 每周期预测 2 条 PC-relative 分支
- 间接分支用 128 项 BTB 加 128 项返回地址预测器
10.4 寄存器堆
采用两级结构,第一级是含 1 个寄存器窗口的多端口快速堆,第二级 SRAM 保存全部 8 个窗口。每个架构寄存器都有 main 与 speculative 两份副本,用一个 1 位指针区分——投机提交(join)时只需翻转指针,不用搬数据。
10.5 内存与互连
- 内存控制器在片外 ASIC 上,每个含 8MB L3,全系统的这些 L3 构成全局共享缓存
- 每个内存控制器 4+1 路 FB-DIMM 通道,第 5 路为冗余
- 处理器与内存控制器之间的串行链路对数据包做硬件压缩
- 一致性采用目录式 MESI(不支持 O 态)
10.6 投机执行
Rock 在投机执行上做了大量激进的尝试,主要包括以下几项:
- Execute-Ahead(EA):load miss、micro-DTLB miss、除法这类长延迟操作触发 checkpoint;其目的寄存器在 scoreboard 上标记 NA,依赖它的指令进 DQ,无关指令继续投机退休、写入 speculative 副本。长延迟操作完成后进入 replay 阶段从 DQ 重放,join 时翻转 1 位指针即可。D$ 每行每 strand 设 1 个 s-bit,用来发现投机 load 的数据被无效化或驱逐。一次 EA 可以让上千条指令在飞。
- Simultaneous Speculative Threading (SST):单线程独占核内两个 strand(双 checkpoint),一条 strand 在 replay 的同时另一条开启新的 EA 阶段,不需要额外状态。
- Scout threading:store buffer 或 DQ 溢出导致 EA 走不下去时,该执行流转为 hardware scout 继续向前跑,为 load 与 store 预取(Memory Level Parallelism,MLP)并顺路预热分支预测器;scout 对软件不可见,等长延迟指令完成后从该指令处恢复正常执行。
- Parallelization of programs
10.7 Transactional Memory
- 新增
chkpt(带 fail-pc 参数)与commit指令和 cps 状态寄存器,复用 EA 的 checkpoint 机制 - 事务内的 load 置 s-bit;store 按序进 store queue,地址送 L2 做冲突侦测
- commit 时 L2 锁定全部被写行,store queue 排空时逐行解锁(bulk commit);事务规模受 store queue 容量限制
- TLB miss、中断、除法等都可导致 abort——best-effort,不保证事务成功,思路与后来英特尔的 TSX 近似
10.8 取消
2009 年 6 月,《纽约时报》披露 Rock 被砍,主要是性能未达预期、研发耗资巨大,再赶上 Sun 被 Oracle 收购,这个 Sun 历史上最激进的核心就此止步,只留下若干篇 IEEE 论文供后人凭吊。
11. SPARC T3 / T4 / T5
- 2010 年的 SPARC T3:40 纳米制程,时钟 1.65GHz,16 核 128 线程,可视为 UltraSPARC T2 的加倍版,然后 SPARC Enterprise 服务器品牌也取消,统一称为 SPARC T 系列。
- 2011 年的 SPARC T4:40 纳米制程,时钟 2.85~3GHz,8 核 64 线程。
11.1 SPARC T3
SPARC T3 相当于把两颗 T2 级别的核心阵列合进一块 die,核心本身(S2)相对 T2 改动不大,还是顺序双发射、每核 8 线程。
- 16 核 128 线程,1.65GHz,TSMC 40nm,377mm²
- 每核 L1:16KB I$ + 8KB D$
- 6MB 共享 L2,带宽 461 GB/s
- 4 条 DDR3 通道
- 2 条 PCIe 2.0 x8,2 个 1G/10G 以太网口
- 每核一个安全协处理器(AES/DES/SHA/RSA/ECC),带硬件随机数
- 2 个一致性控制器、6 条一致性链路(每条 14 条单向 lane),免胶合扩展至 4 路(512 线程)
- 6 个时钟域、4 个电压域
11.2 SPARC T4
2011 年的 SPARC T4,就是 8 个双指令派发、非循序预测执行的 S3 核心(代表第三代 SPARC 核心,并追加 VIS 3 指令集),每个核心 8 条同时多线程的产物,一路「核心堆堆乐」到 12 核 96 线程的 SPARC M6。
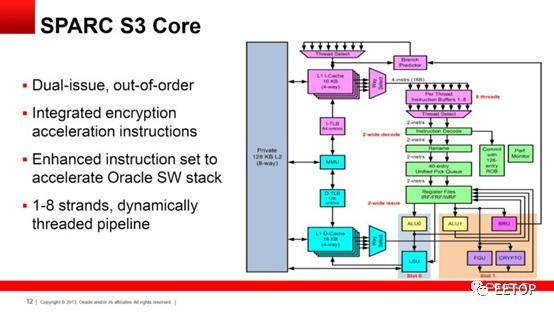
其主要规格为:
- 8 个 SPARC S3 核心,每核 8 线程
- 共享 4 MB L3,8 分体,16 路组相联
- 2 个双通道 DDR3-1066 内存控制器
- 2 个 PCI-Express x8 2.0 端口
- 2 个 10G 以太网端口
- TSMC 40 nm,约 8.55 亿晶体管
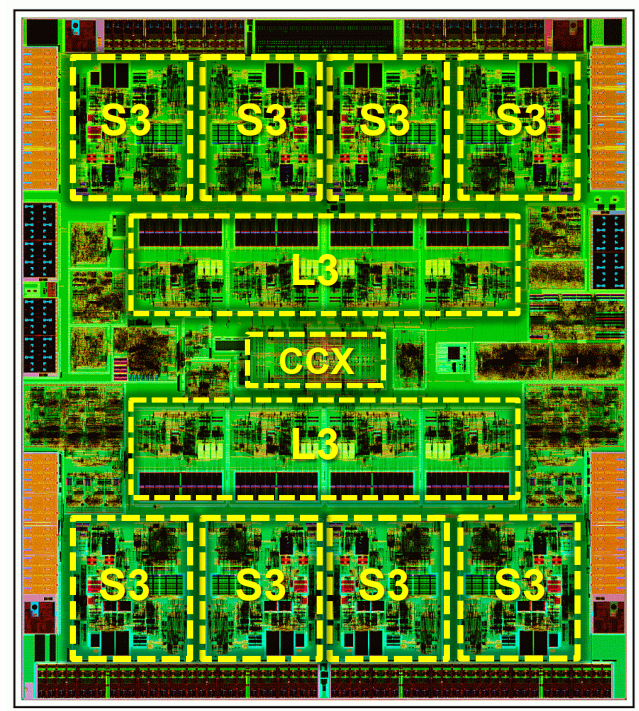
11.2.1 S3 Core
- Out-of-order
- Dual-issue
- 动态线程化(Dynamically threaded)
- 均衡的流水线设计
- 单线程性能:估计为 S2 的 5 倍 SPECint2006、约 7 倍 SPECfp2006
- 吞吐性能:约 S2 每线程吞吐性能的 2 倍
- 高频、深流水:16 级整数流水线,3+ GHz
- 广泛的分支预测:感知机方向预测器(Perceptron direction predictor)、用于预测返回地址的 Return Stack、远跳转与间接目标预测器、降低已跳转分支惩罚的 BTC
- 面向 Oracle 应用的硬件 / 软件优化:用户态密码学指令、
PAUSE指令、融合的比较—分支指令 - 硬件预取器:指令缓存顺序行预取器、数据缓存跨步预取器
- 16 KB、4 路组相联 L1 指令与数据缓存
- 128 KB、8 路组相联统一私有 L2 缓存
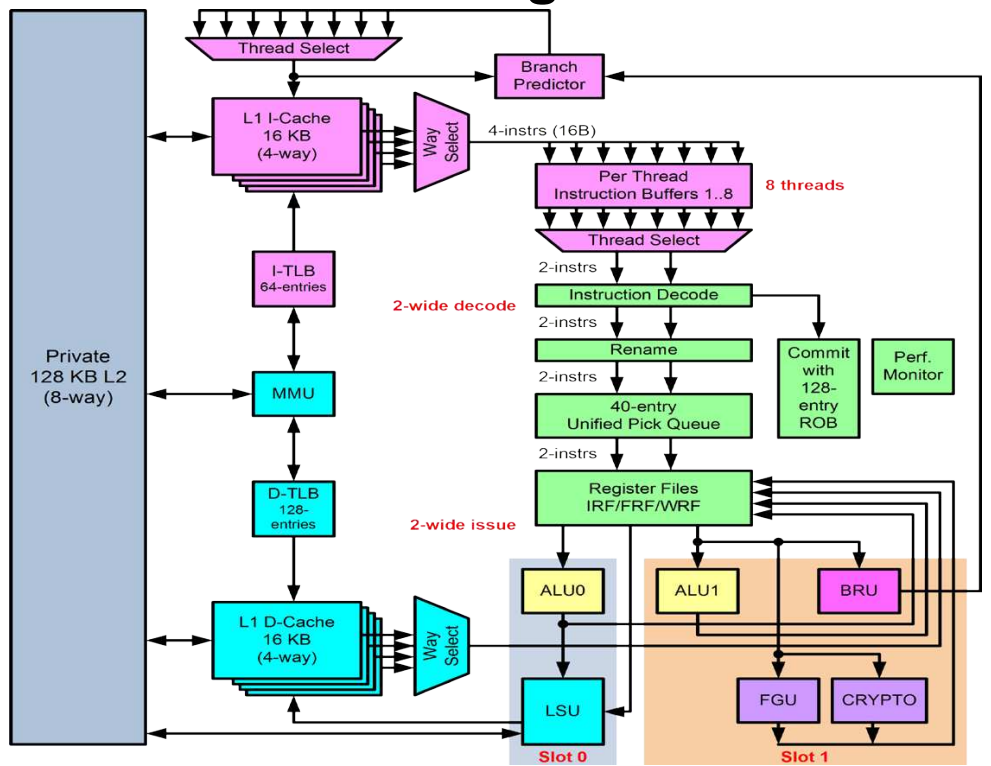
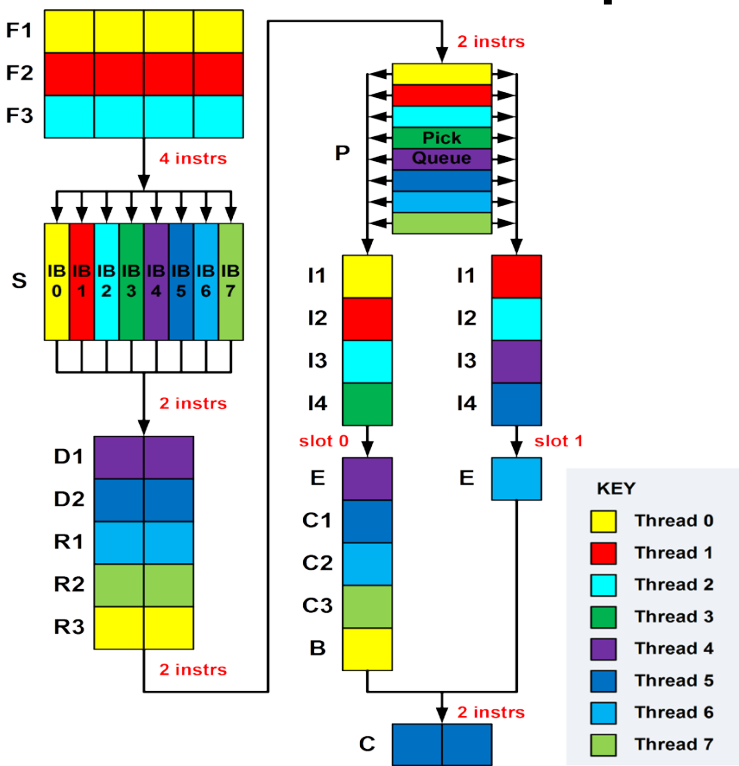
11.2.1.1 S3 Core Pipeline
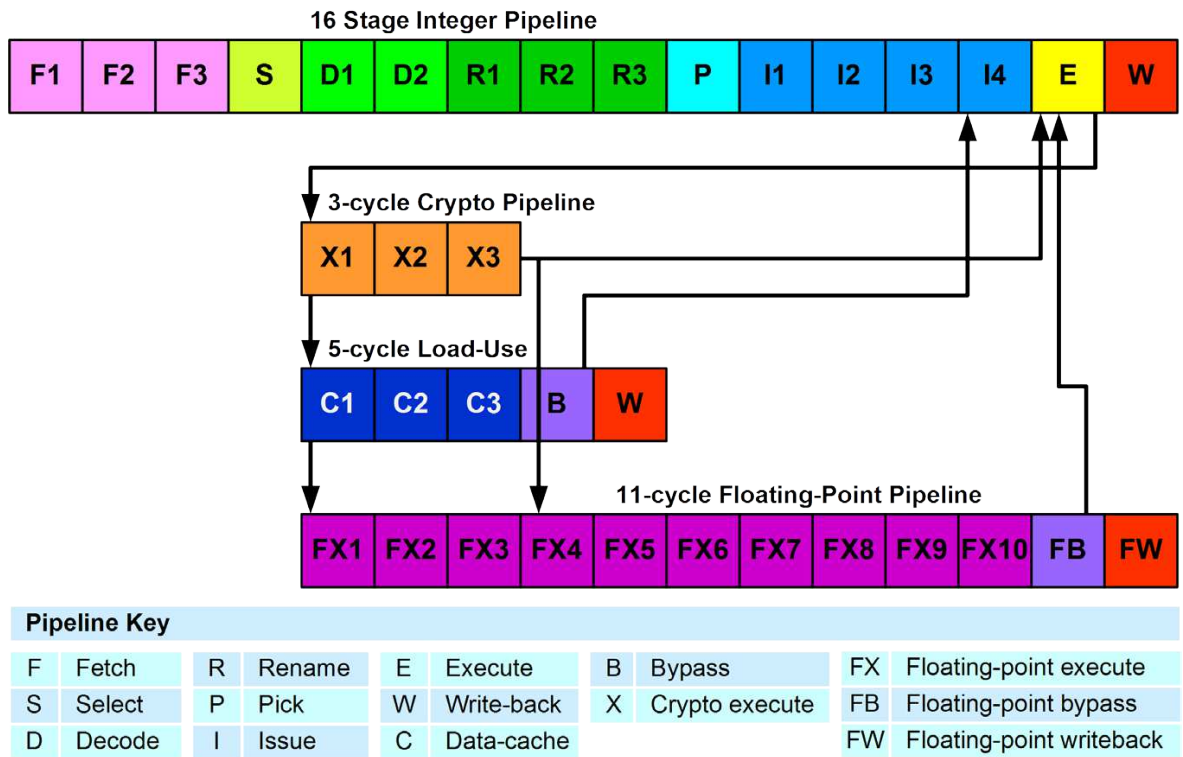
整数流水线 16 级,Fetch1–3 → Select → Decode1/2 → Rename1/2/3 → Pick → Issue1–4 → Execute → Writeback;LSU 20 级,FGU 27 级。
发射配对规则:
- Select 每周期按 LRU 选一个线程,最多取 2 条组成 decode group(rename 阶段不打散该组);
- store 在译码后拆成地址与 store-data 两个微操作。
- 每周期最多发射 2 条常规指令加 1 条 store-data:slot0 去 LSU/EXU0,slot1 去 EXU1/BRU/FGU/SPU,slot2 专走 store-data。
- 40 项 pick queue 是核内最关键的共享资源,带 thread-hog 缓解机制;
- 128 项 ROB 允许被单个线程独占。
Threaded S3 Core Pipeline View:
- Pick 之前:每级流水线只有 1 个线程
- Pick 到 Commit:每级流水线可有多个线程
- Commit:每级流水线只有 1 个线程
11.2.2 Dynamic Threading
- S3 上许多资源在线程间共享:load-buffer、store-buffer、pick-queue、working-register-file、reorder-buffer 等
- 线程共享资源的方式
- 静态资源分配:对异构负载并非最优
- 动态资源分配:更适合异构负载,改善整体应用扩展性;资源每周期在线程之间动态配置,无需同步
11.3 SPARC T5
- 2013 年的 SPARC T5:28 纳米制程,时钟 3.6GHz,16 核 128 线程。
T5 把 S3 核心移植到 28nm 并做了改进:ROB 扩到 128 项,四条功能管线共享前 14 级流水线以节省面积。
- 每核 L1:16KB I$(4 路)+ 16KB D$(4 路,写穿);128KB、8 路、inclusive 的私有 L2
- 8MB 共享 L3:8 分体、16 路、MOESI,带 reverse directory
- 8×9 交叉开关连接核心与 L3 分体,对分带宽 1 TB/s,是 T4 的两倍
- 内存:8 个 DDR3 BL8 调度器,80 GB/s;经 4 条 12-lane、12.8Gb/s 的私有链路接片外 BoB 缓冲芯片,最多 8 条 DDR3 通道、16 条 DIMM
- I/O:2 条 PCIe Gen3 x8
- 7 条一致性链路(每方向 12 lane,153.6Gb/s),免胶合一跳扩展到 8 路,精确目录一致性
- RAS:L3 支持 DMA buffer 直接分配、竞争锁加速、缓存行刷新退役以避免持久性错误;DVFS 功耗管理;16 种加密算法硬件加速
12. SPARC M 系列
SPARC M7 升级成具改良后的快取存储器阶层和 VIS 4 指令集的 S4 核心,演进到 2017 年的 32 核心 256 线程的 SPARC M8。
12.1 SPARC M5 与 Bixby
2013 年的 SPARC M5采用28 纳米制程,时钟 3.6GHz,6 核 48 线程。
12.1.1 Oracle’s M5-32 System
- 32 个 M5 SPARC 处理器
- 12 个 Bixby
- 4 个物理(硬件)域
- 3.1 TB/s 有效载荷一致性带宽
- 1.5 TB/s 有效载荷扩展性带宽
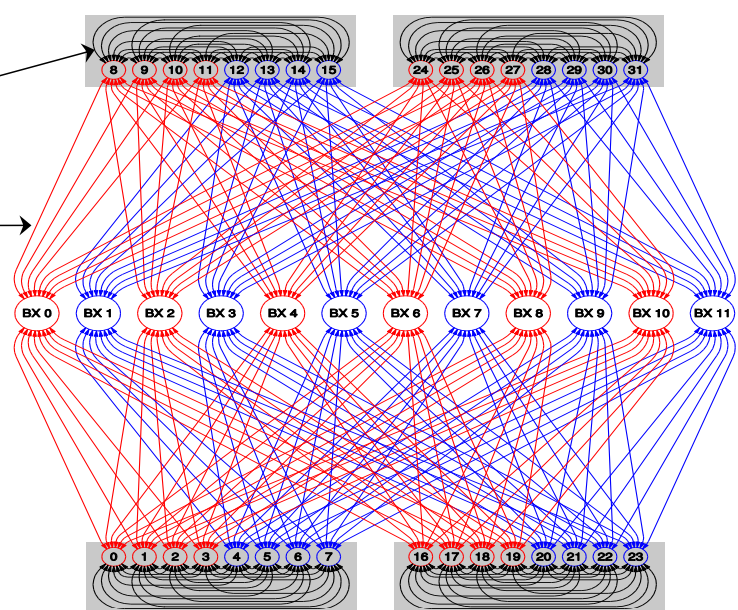
12.1.1.1 M5-32 System Coherence Interconnect
- Coherence Links (CL)——每方向 12 lanes
- Scalability Links (SL)——每方向 4 lanes
- 每 lane 12 Gbps
- 每处理器 7 条 CL + 6 条 SL
- 每个 Bixby 16 条 SL
12.1.2 Bixby
- 96 Tx + 96 Rx,16 Gb/s 长距离 AC 耦合 SerDes
- 封装:45mm × 45mm,1677-pin FPBGA(约 500 个信号 IO)
- 工艺:28nm,10 层金属,0.85V ASIC
- 约 160 Mbits SRAM(约 20MB 标签)
- 约 70M 门(nand2 等效)
12.1.2.1 Floorplan
- 所有主要数据路径上的 SEC-DED
- 控制信号上的奇偶校验
- 顶部两层布线层上的定制顶层走线
- 关键网络由 route 上的 buffer 实现,ps/mm 更快
- PVT 无关的时钟分布
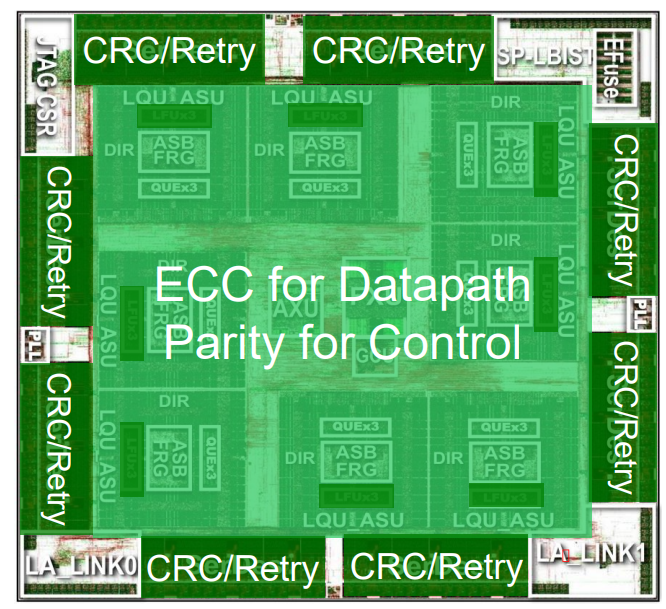
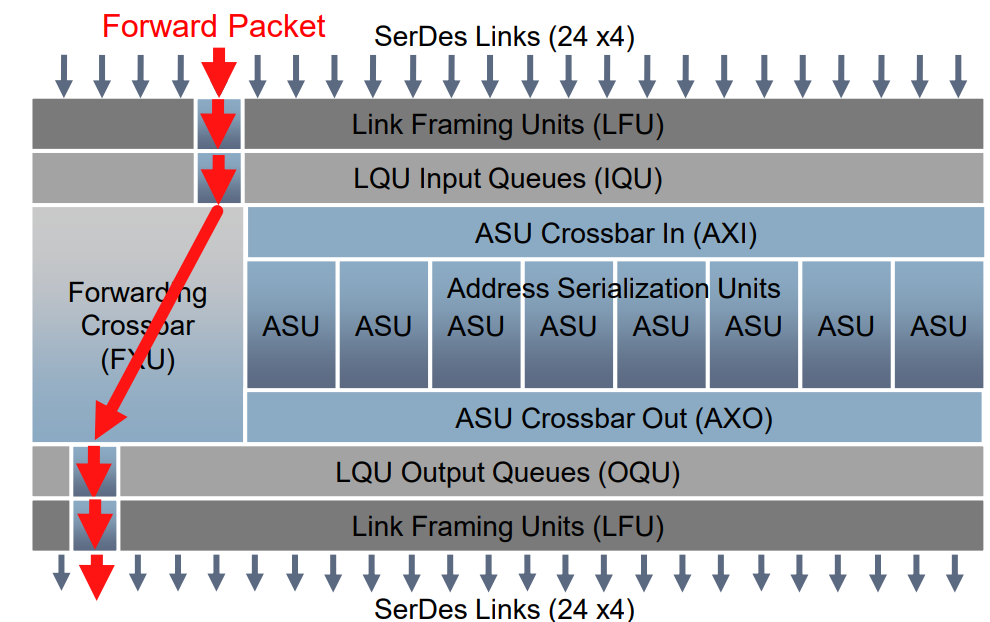
12.1.2.2 Link Queuing Unit (LQU)
- 每个管理一条 x4 Scalability Link
- 为多个虚拟通道提供排队支持
- 每个 LQU 属于单一物理域
- 链路 FIFO(基于 RAM)上的 SEC-DED
12.1.2.3 Cross Bar Units (XBU)
- 单独的数据路径转发流量,其规模考虑了任何队头阻塞(Head-of-Line blocking)的低效
- FXU:24 入 × 24 出(2 周期包)
- AXI:24 入 × 8 出
- AXO:16 入 × 24 出
- 交换结构实现为定制布局的硬宏(hard macros)
- Bixby 在满线速下完全维持混合的请求与数据流量
- FXU 属单域,AXI/AXO 为多域逻辑
- 流水的 SEC-DED,路由控制上带奇偶校验
12.1.2.4 Address Serialization Unit (ASU)
- 划分为 8 个并行单元
- 每个目录单元每周期可比较并处理最多 22,656 位(全芯片每周期共 181,248 位)
- 每周期 0.5 次请求查找(全芯片共 4 次)
- 对入向包与标签目录内容做流水校错
- 目录标签暂存触发器上的重试(Retry)
- 支持最多 12 个带错误导向的硬件域
- 每域内建自初始化(BISI)
- 标签 RAM 擦洗器(scrubber)
12.2 SPARC M6
2013 年的 SPARC M6采用28 纳米制程,时钟 3.6GHz,12 核 96 线程。
12.2.1 SPARC S3 Core
- Dual-issue、out-of-order
- 集成的加密加速指令
- 用于加速 Oracle 软件栈的增强指令集
- 1–8 个 strand,动态线程化流水线
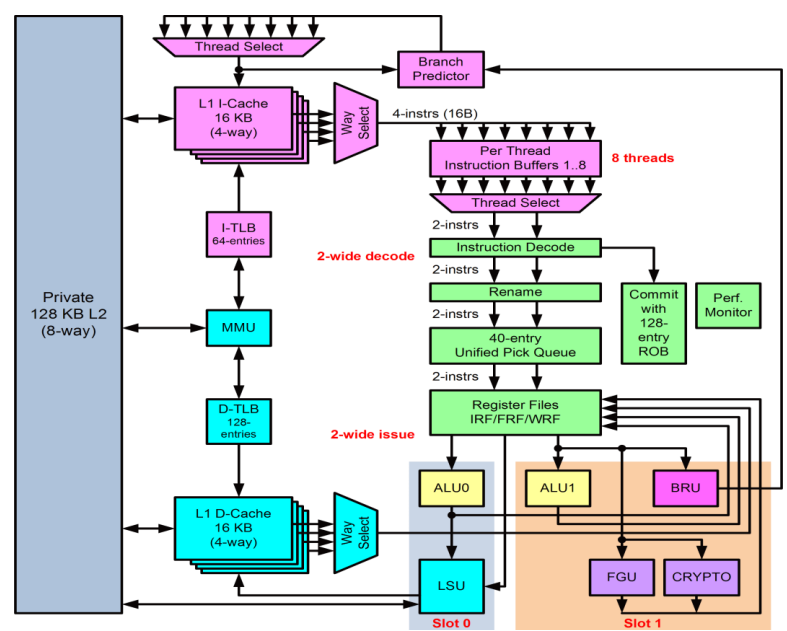
12.2.2 SPARC M6 Caches
- 每核 L1 与 L2 缓存
- L1 I-Cache:16KB,4 路,32 字节行
- L1 D-Cache:16KB,4 路,16 字节行,写穿
- L2 统一缓存:128KB,8 路,32 字节行,写回,inclusive
- 每芯片共享 L3 缓存
- 48MB,4 分体,12 路,64 字节行,inclusive,MOESI
- 基于 PCIe TLP Processing Hints 的 DMA 分配
- 请求打包(Request bundling),改善数据库中高访问共享区的性能
12.2.3 SPARC M6 Memory Subsystem
- 为内存数据库与应用调优
- 4 个高效率 DDR3 调度器
- 每插槽 16 个 DDR 通道
- 每 rank 调度
- 动态调节写与读的优先级
- DIMM 省电模式
- 丰富的地址交织设置,以优化性能、可服务性与功耗的平衡
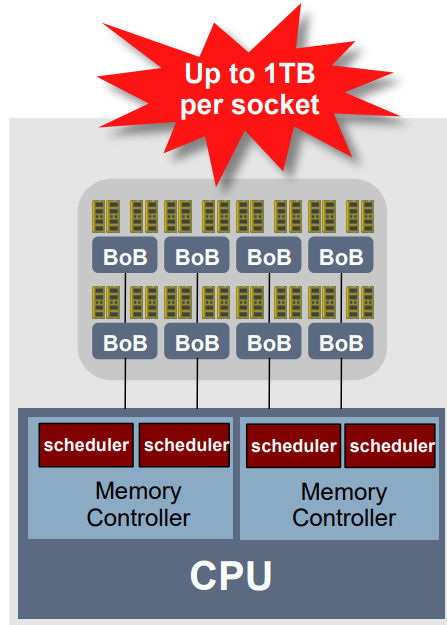
12.2.4 SPARC M6 IO Subsystem
- 双 x8 PCIe Gen3
- 原子操作:fetch-add、swap 等
- TLP hints 把 DMA 写直接导向 L3
- PCIe 电源管理
- 虚拟 IO 的加速功能
- PCIe 架构化错误
- 通过 PCIe 消息的错误信令
- 支持每个 PCIe root complex 及其所连结构的独立复位
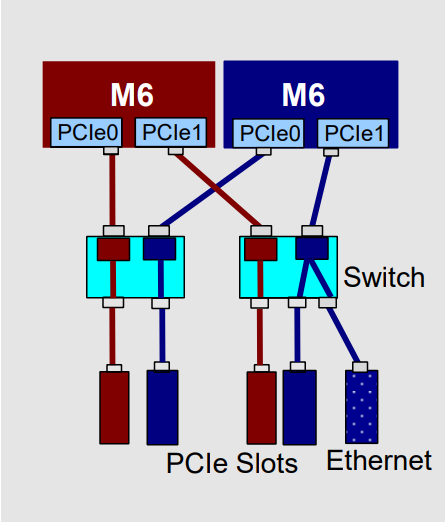
12.2.5 SPARC M6 Processor
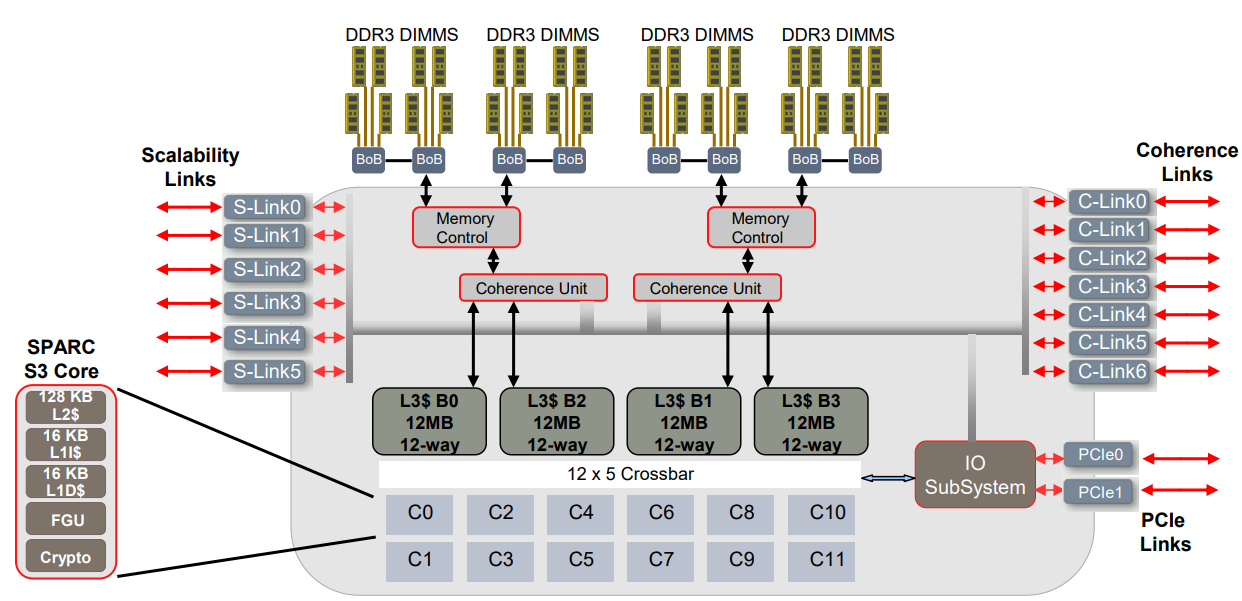
12.2.5.1 SPARC M6 Processor
- 12 个 SPARC S3 核心,96 线程
- 48MB 共享 L3 缓存
- 4 个 DDR3 调度器,每插槽最大 1TB 内存
- 2 个 PCIe 3.0 x8 lane
- 无胶合(glue-less) 最多扩展到 8 插槽
- 有胶合最多扩展到 96 插槽
- 4.1 Tbps 总链路带宽
- 42.7 亿晶体管
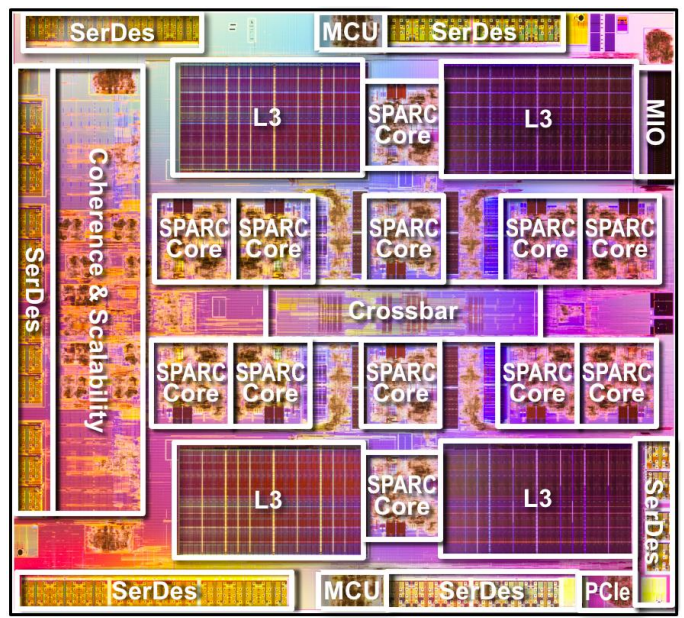
12.2.6 SPARC M6 Scaling
12.2.6.1 Tightly Coupled SMP
- 最多 8 个处理器用 C-Links 直接互连
- 可构建处理器间多链路的 2 路与 4 路配置
- 可在插槽被去配置(de-configured)的情况下运行
- 内存与目录地址在处理器之间切片分布
- 内存 home 与目录 home 采用不同的地址哈希
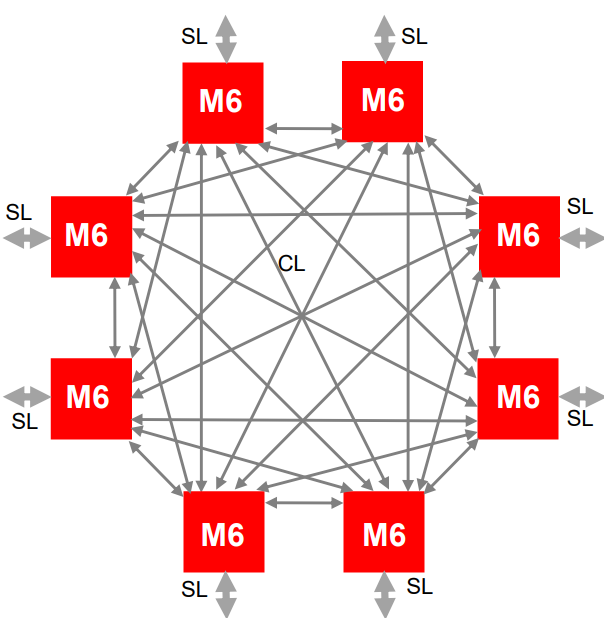
12.2.6.2 Beyond an SMP
- 系统目录位于 Bixby 中,通过 S-Links 连接到处理器
- 一个 SMP 的 48 条 S-Links 代表不同的地址平面
- 请求必须先用 C-Links 到达正确的处理器,再用 S-Links 到达目录
- 响应沿请求的路径回溯
- 数据在所有可用平面上动态路由
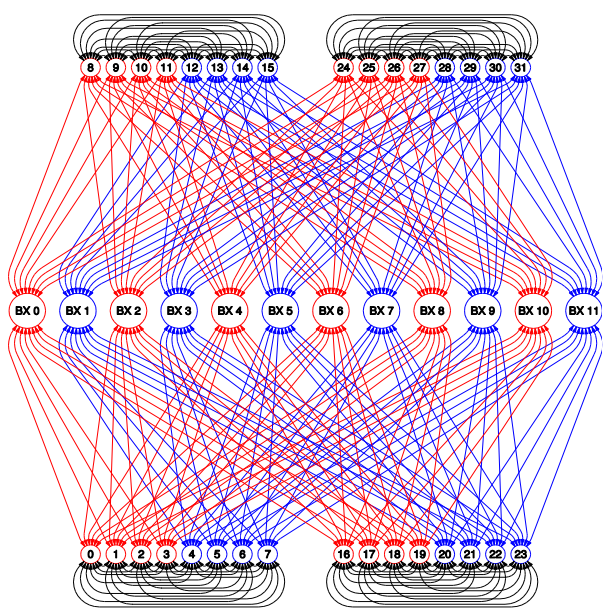
12.2.6.3 Larger Systems
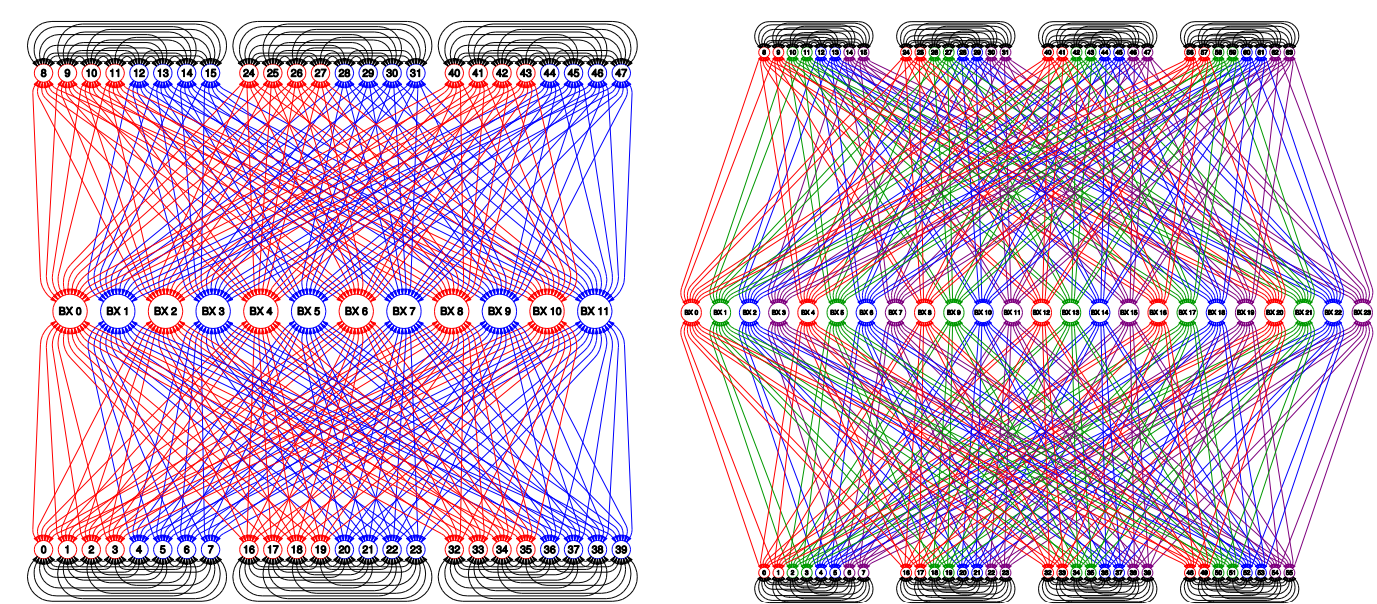
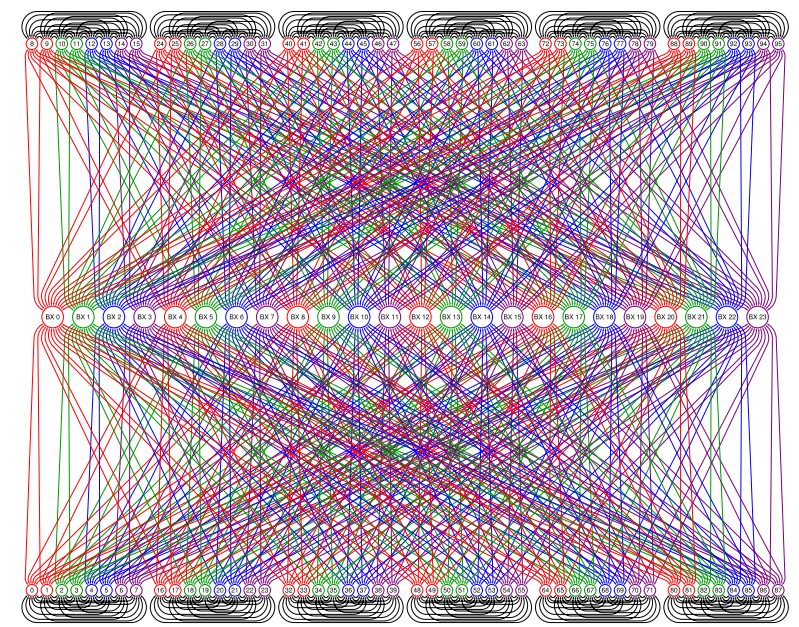
12.2.7 SPARC M6 Coherence Simple Transaction
- 请求被送往目录,SpecRead 被送往内存 home
- 目录检查行状态,并返回带预期信息的 ReqAck
- 若该行不在任何缓存中,目录指示内存 home 提供数据
- 若该行在某些缓存中,目录指示某个缓存提供数据,并在必要时指示其他缓存使其副本失效
- 请求者收集所有持有者的 InvAck,然后通知目录解锁该行
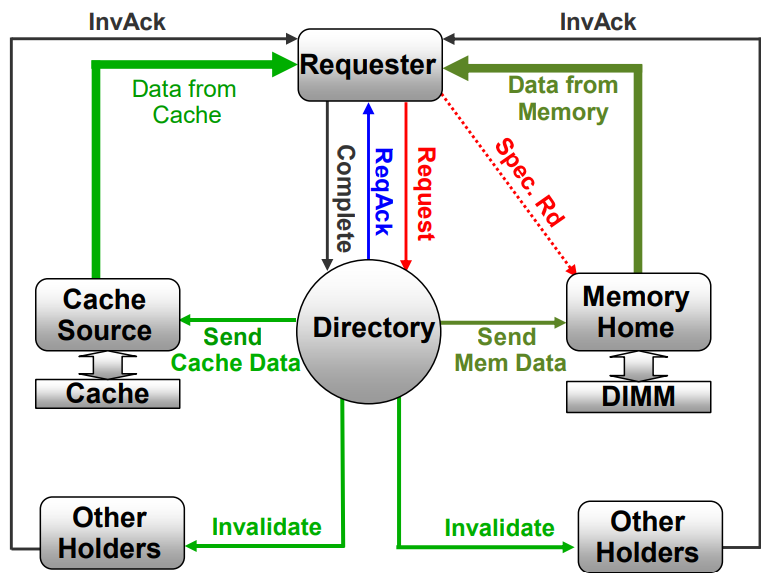
12.3 SPARC M7
SPARC M7 的要点:
- 32 个 SPARC 核心
- 第四代 CMT 核心(S4)
- 动态线程化,每核 1 至 8 线程
- 新的缓存组织
- 共享的二级数据与指令缓存
- 64MB 共享且可分区的三级缓存
- DDR4 DRAM
- 每处理器最高 2TB 物理内存
- 内存带宽为上一代的 2–3 倍
- PCIe Gen3 支持
- 应用加速
- 实时应用数据完整性(Real-time Application Data Integrity)
- 并发内存迁移与 VA Masking
- 数据库查询卸载引擎(DB Query Offload Engines)
- 从 1 到 32 处理器的 SMP 扩展性
- 一致性内存簇(Coherent Memory Clusters)
- 工艺采用 20nm,13ML
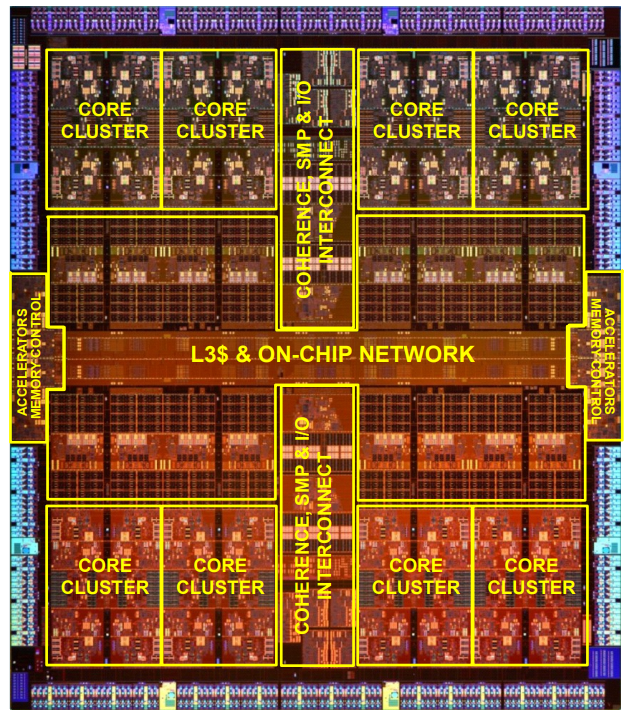
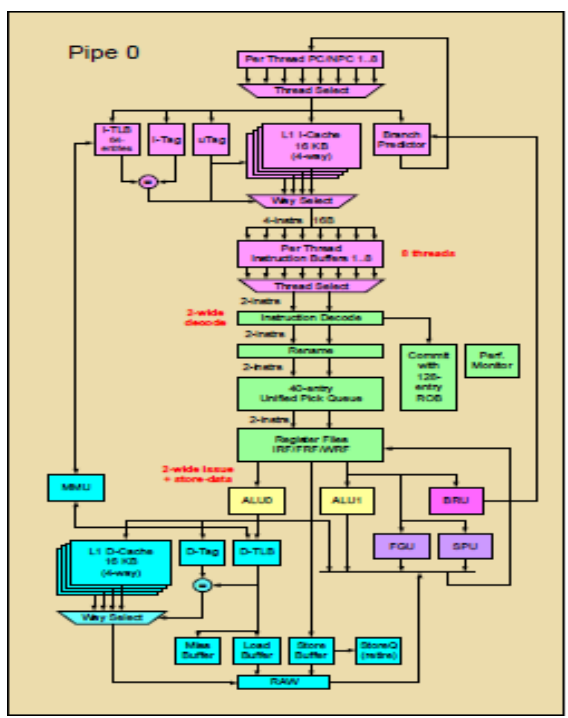
12.3.1 M7 Core - S4
- 动态线程化,1 至 8 线程
- 双发射、乱序执行核心
- 2 个 ALU、1 个 LSU、1 个 FGU、1 个 BRU、1 个 SPU
- 40 项 Pick Queue
- 64 项全相联 I-TLB,128 项全相联 D-TLB
- 密码学性能改进
- 54 bit VA,50 bit RA/PA,寻址能力提升 4 倍
- 16 级整数流水线(与 S3 同深度,频率更高),全核最多 128 条指令在飞(128 项 ROB)
- 发射槽位:slot0 = EXU0 + LSU,slot1 = EXU1 + BRU + FGU/SPU,另有独立的 store-data 通道,峰值 2 IPC
- load-use 延迟:L1 5 周期、L2 19 周期、L3 41 周期
- fetch 按「最近最少取指」选线程、decode 按「最近最少译码」,槽位内 oldest-ready-first 发射;乱序完成、strand 内按序提交
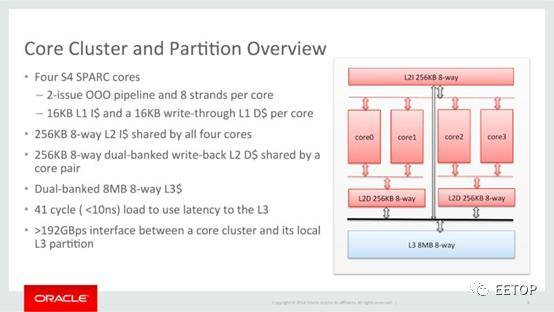
12.3.2 M7 Core Cluster
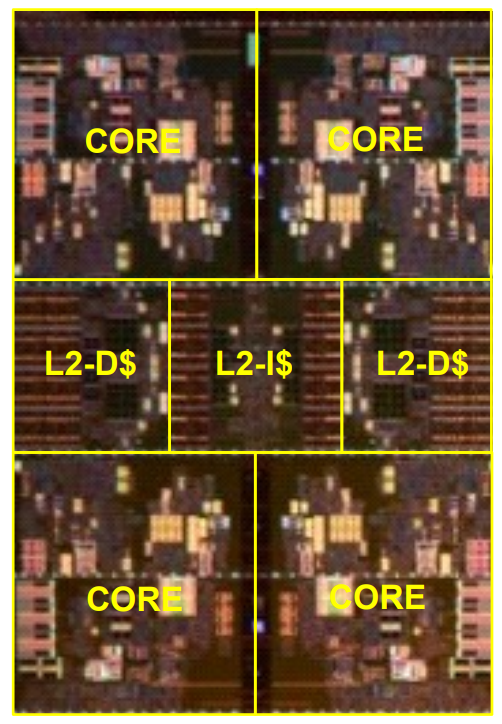
- 每簇 4 个 SPARC 核心
- 新的 L2$ 架构
- 容量比上一代大 1.5 倍,而延迟周期数相同
- 每核带宽 2 倍;每核心簇 >1 TB/s,全芯片 >8 TB/s
- 256KB L2-I$
- 由核心簇内所有核心共享
- 4 路组相联,64B 行,>500 GB/s 吞吐
- 4 个独立核心接口,每个 >128 GB/s
- 256KB 写回 L2-D$
- 每个 L2-D$ 由 2 个核心(core-pair)共享
- 8 路组相联,64B 行,每个 L2-D$ >500 GB/s 吞吐
- 每个 L2-D$ 2 个独立核心接口,每个 >128 GB/s
- Core-pair 动态性能优化
- 在上一代线程数下使核心执行带宽翻倍,最大化每线程性能
- 利用每核 8 线程最大化核心吞吐
12.3.3 M7 Level 3 Cache 和On-Chip Network
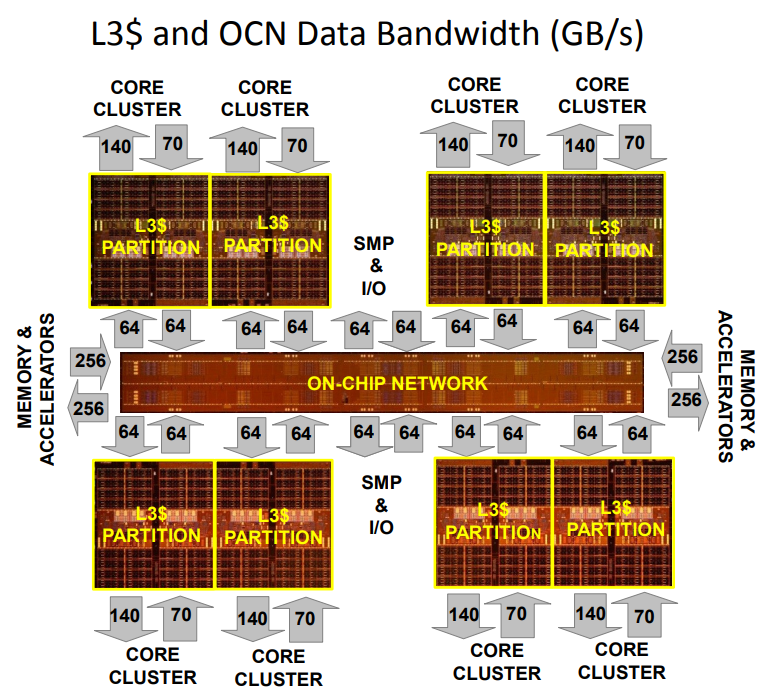
- 64MB 共享且可分区的 L3$
- 8MB 本地区(Local Partition),各 8 路组相联
- 本地 L3$ 周期延迟比上一代(M6)降低 >25%
- 每芯片 >1.6 TB/s L3$ 带宽,为上一代的 2.5 倍(T5)到 5 倍(M6)
- 缓存行可在 L3$ 分区之间复制、迁移或牺牲(victimize)
- 硬件加速器可直接分配进目标 L3$ 分区
- 片上网络(OCN)
- 由 Request(环)、Response(点到点)与 Data(Mesh)三类互连构成
- 0.5 TB/s 对分数据带宽
12.3.4 M7 Memory 和 I/O
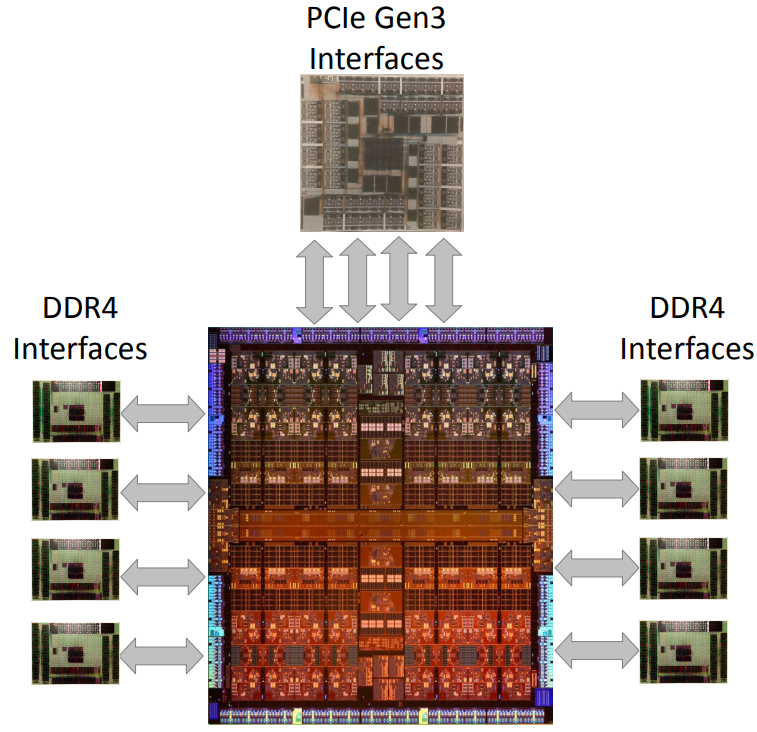
- 4 个 DDR4 内存控制器
- 16 个 DDR4-2133/2400/2667 通道
- 极大的内存容量,每处理器最高 2TB
- 实测 160 GB/s 内存带宽(DDR4-2133),为上一代 T5 与 M6 的 2–3 倍
- DIMM 退役(Retirement)无需停机
- 到缓冲芯片的内存链路
- 12.8 / 14.4 / 16 Gbps 链路速率
- 带完整 CRC 保护的 lane 失效切换
- 投机内存读
- 在本地 L3$ 分区失效时通过预取降低本地内存延迟
- 基于历史(数据、指令)与阈值设置的每请求动态决策
- PCIe Gen3
- 4 条内部链路,支持 >75 GB/s
- 为上一代 T5 与 M6 的 2 倍以上
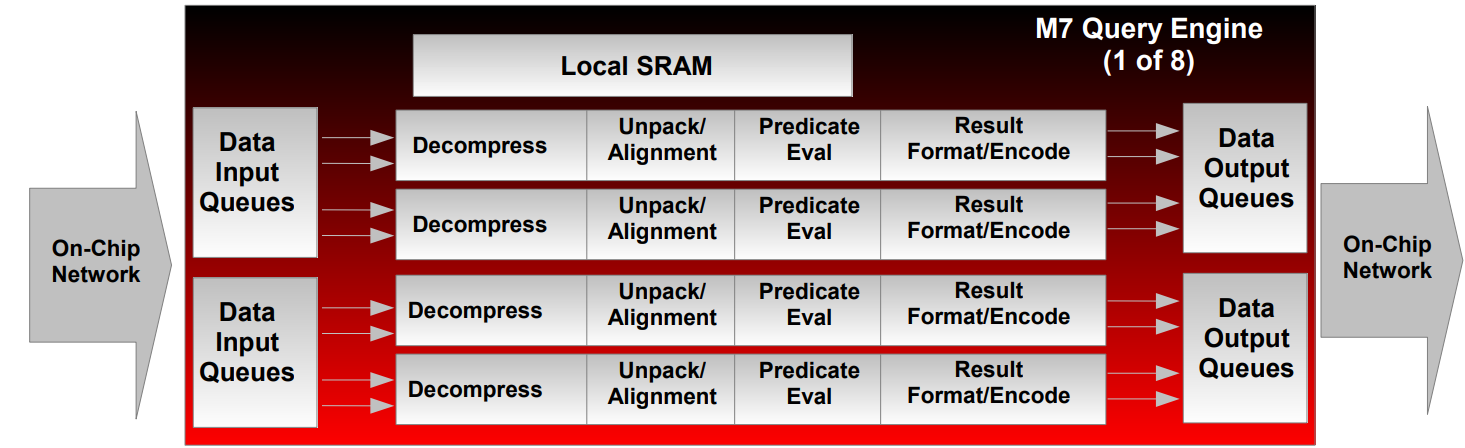
12.3.5 M7 Query Accelerator Engine
- 8 个硅片内卸载引擎
- 核心/线程与卸载引擎同步或异步运行
- 通过共享内存的用户态同步
12.3.6 M7 SMP Scalability
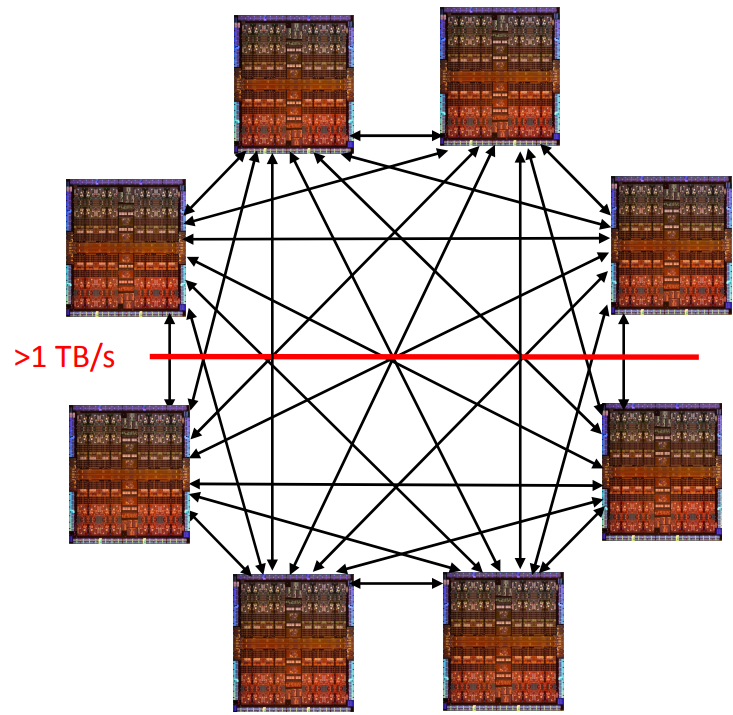
- 全连接的 8 处理器 SMP
- 最多 256 核、2K 线程、16TB 内存
-
1 TB/s 对分有效载荷带宽
- 利用链路聚合(Link Trunking) 的全连接 2/4 处理器 SMP
- 基于目录的一致性
- 16 Gbps 至 18 Gbps 链路速率
- 链路级动态拥塞避免
- 备用路径数据路由
- 基于目的队列占用率
- 链路级 RAS
- 自动帧重传
- 自动链路重训练
- 单 lane 失效切换
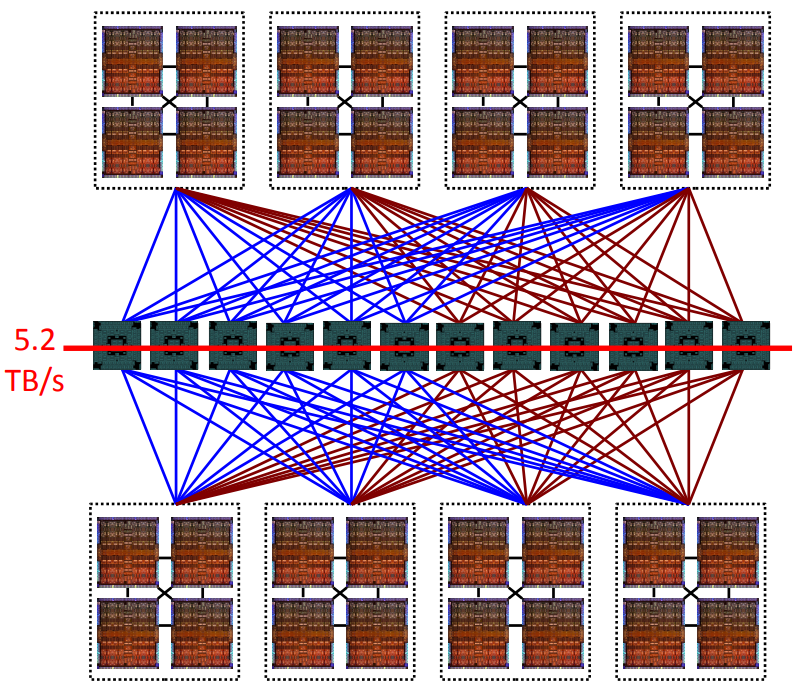
- SMP 扩展到 32 处理器
- 最多 1K 核、8K 线程
- 最多 64TB 内存
- 64 端口交换 ASIC
- 分为 2 个交换组,每组 6 个交换 ASIC
- 5.2 TB/s 有效载荷带宽
- 对分有效载荷带宽为 M6 的 4 倍
- 每 4 个处理器一个物理域
- 全连接的本地拓扑
- 动态组合处理器域
- 全连接交换拓扑
- 每个处理器与交换机之间 2 条链路
- 一致性目录分布在各交换机中
- 相对 M6 代际的延迟降低
- SMP 互连 RAS
- 链路自动重传与重训练、单 lane 失效切换
- 链路级多路径
- 每组 6 个 ASIC 中有 5 个即可运行
12.4 SPARC S7 与 M8
- 2016 年的 SPARC S7 采用20 纳米制程,时钟 4.27GHz,8 核 64 线程,SPARC M7 的低价微缩版。
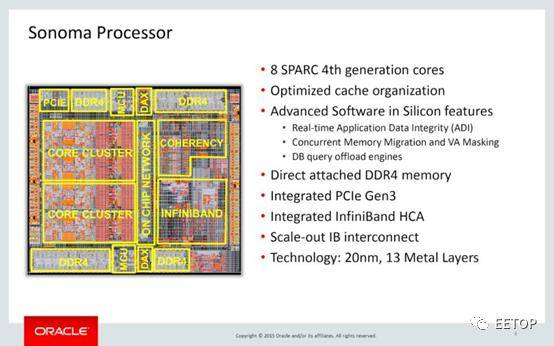
S7(Sonoma)用与 M7 相同的 S4 核心,8 核 2 簇,相当于四分之一颗 M7,但把 M7 需要片外 BoB 芯片承担的内存控制器、PCIe 与 InfiniBand 全部集成上片:
- 每核 16KB + 16KB L1;每簇共享 256KB L2 I$,每对核共享 256KB 写回 L2 D$(各自 500GB/s)
- L3 16MB 全共享、按簇分区、8 路 inclusive
- 2 个 DDR4-2133/2400 控制器(各 2 通道),单插槽最大 1TB、77GB/s
-
1 条 PCIe 3.0;16 个 DAX 引擎(4 单元 × 4 流水线);4 条一致性链路共 128GB/s
- 2017 年的 SPARC M8 采用20 纳米制程,时钟 5GHz,32 核 256 线程,一颗怪物级的大芯片。
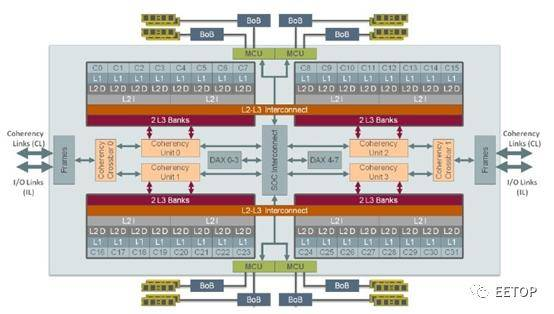
M8 换上第五代 S5 核心,发射宽度从 2 加宽到 4:
- 最多 192 条指令在飞,每周期最多提交 4 条
- 发射结构(据 GCC 调度器源码):两个双发射队列 PQLS 与 PQEX——slot0 为 load 与 store 地址生成,slot1 为 store-data 与分支,slot2 为 EXU2 + SPU2(3 周期加密),slot3 为 EXU3 + SPU3 + FGU + 长延迟加密单元 + Oracle Numbers Unit
- 延迟:整数乘 10 周期、整数除 30 周期、load 3 周期、非对齐 load 11 周期
- L1 I$ 加倍到 32KB(4 路);L2 D$ 改为每核独享 128KB(8 路),不再由核分享
- 不变的部分:32 核 256 线程、64MB 16 路 inclusive L3(2 个 32MB 分区,热点行就近迁移)、每 4 核共享 256KB L2 I$、16KB L1 D$、DDR4-2400(185GB/s)、16GB 大页、最多 8 插槽
同是 20nm,时钟却从 M7 的 4.13GHz 提到 5.0GHz(+22.5%),靠的是核心内部重构与 DVFS——这也是 SPARC 最后一次冲击频率纪录。
13. Fujitsu SPARC64
SPARC64 之名继承自 HAL,而在 2001 年取消 HAL 原案、基于 Fujitsu GS8900 大型主机而重新开发的 SPARC64 V,则是 Fujitsu 在高端 SPARC 处理器最重要的里程碑:四指令派发、非循序指令预测执行、大型主机等级的高可靠度,效能也明显优于 Sun UltraSPARC III。
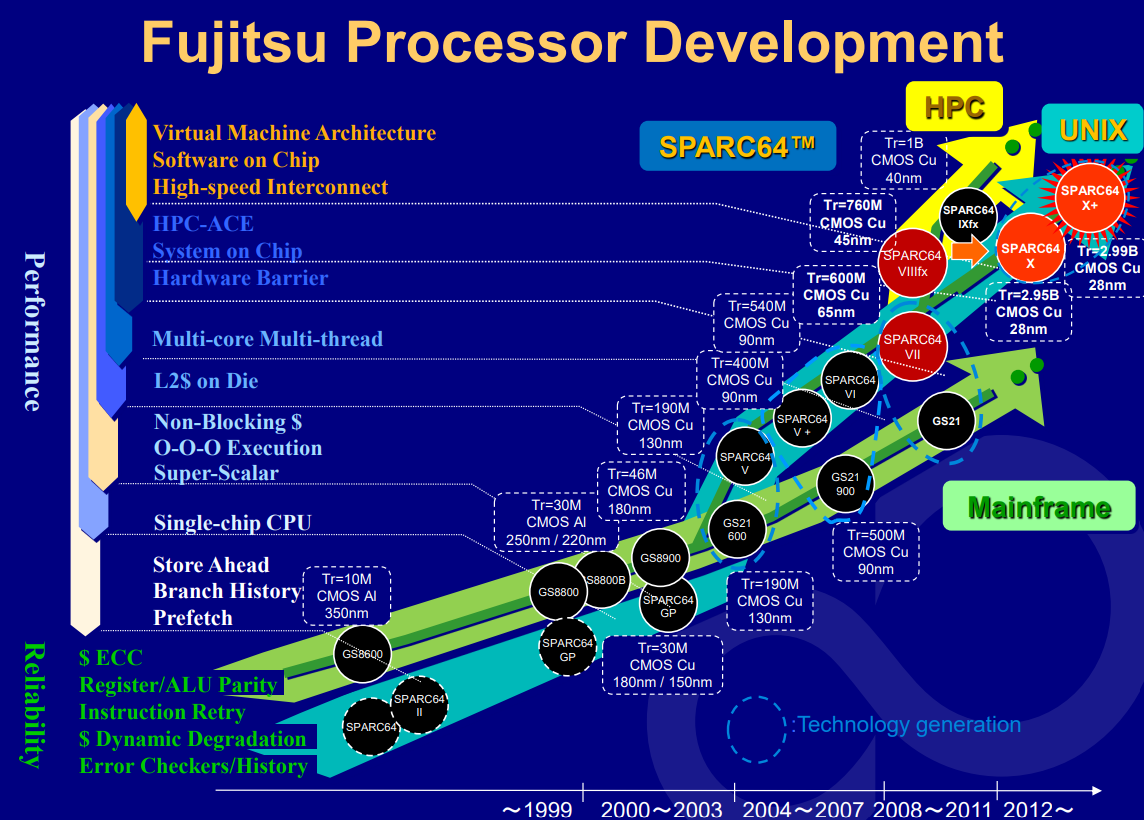
13.1 SPARC64
SPARC64 Processor Module 是一个陶瓷 MCM(多芯片模块),包含:
- 1 个 CPU
- 4 个 CACHE 芯片
- 1 个 MMU
- 1 个 CLOCK 芯片
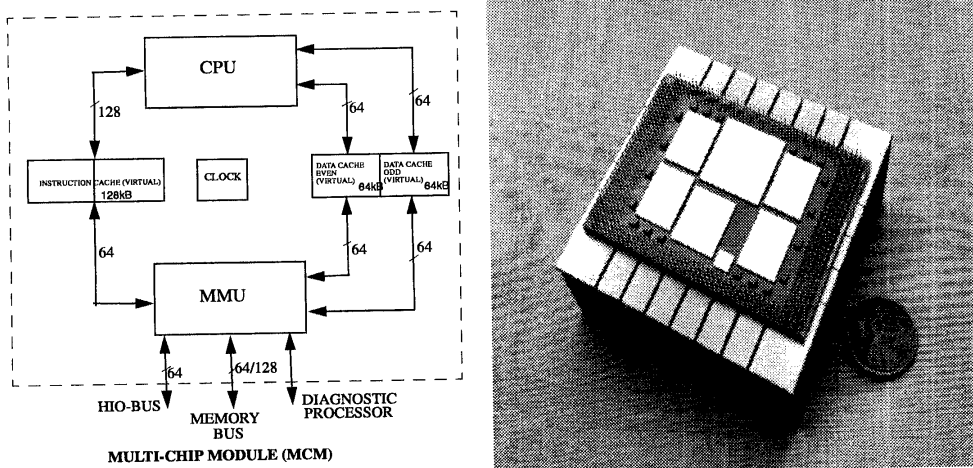
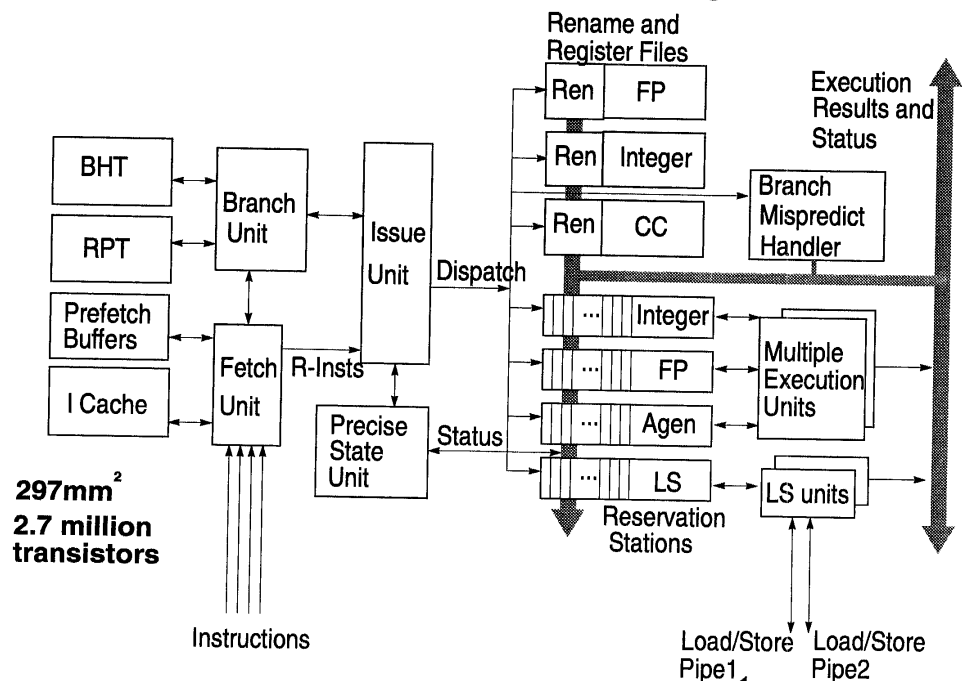
- 通过数据流执行(Dataflow execution)跟踪最多 64 条活动指令
- 采用寄存器重命名(Register Renaming) 与动态分支预测(Dynamic Branch Prediction)
- 顺序发射(ISSUE in-order),乱序执行与完成(EXECUTE/COMPLETE out-of-order),顺序提交(COMMIT in-order)
- 内含 2 个 Load/Store 单元、2 个定点单元、2 个地址生成单元、1 个浮点乘加单元,以及 1 个自定时的浮点除法单元
- CACHE
- 非阻塞,采用虚拟索引与虚拟标签
- 每个芯片 64kB,可服务来自 CPU 的 2 个独立请求
- 4 路组相联
- 服务投机/乱序的 CPU 请求
- 2 个指令缓存芯片,2 个数据缓存芯片
- CLOCK
- 在诊断处理器控制下,为 MCM 上所有其他芯片与内存子系统提供 SYS-CLK / SCAN-CLK
- 频率:15~280MHz,抖动 80~160ps,带可编程延迟线以控制偏移
- PROCESS
- Fujitsu 的 twin-well 0.4 μm、4 层金属 CS55 CMOS 工艺
- 3 层金属用于信号布线
- 第 4 层金属用于键合焊盘、全局电源与时钟布线
- MCM 芯片互连采用焊料凸点键合(Solder Bump Bonding)
13.1.1 MMU
- 与虚拟缓存、内存系统、I/O 以及诊断处理器接口
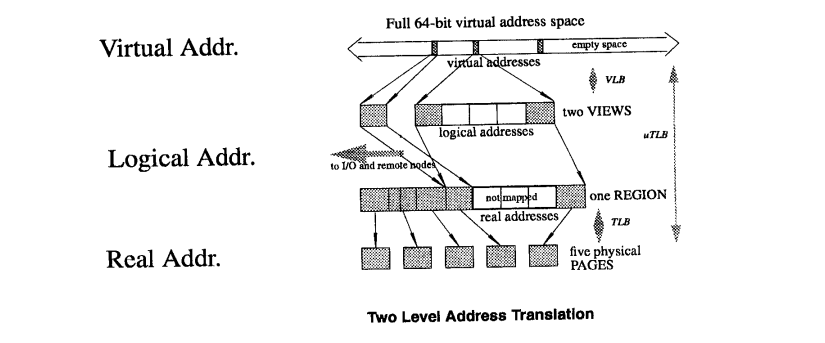
- 通过两级地址转换与三级存储层次(虚拟地址、逻辑地址与物理地址)支持线性 64 位地址空间
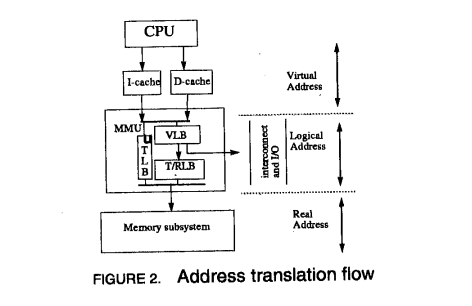
- 3 个「lookaside buffer」降低转换时间
- 128 项全相联 VLB(VA → LA)
- 1024 项、4 路组相联 TLB(LA → PA)
- 8 项、3 端口、全相联 microTLB(VA → PA)
- 内含一个 1024 项的数据缓存实地址表(Data Cache Real Address Table)
- 保存所有数据缓存行的实地址标签
- 若条目匹配,则是一次实命中但虚拟缓存失效,无需访存,只需重新给缓存行打标签
13.1.2 Pipeline
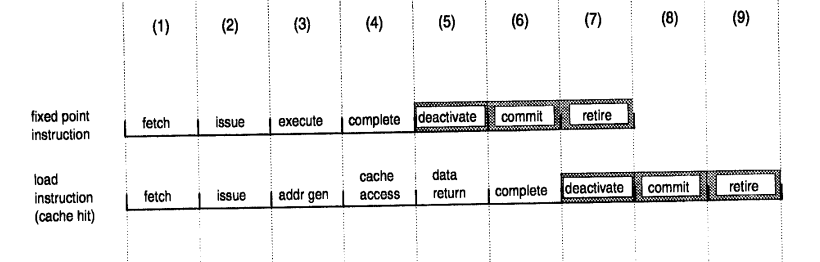
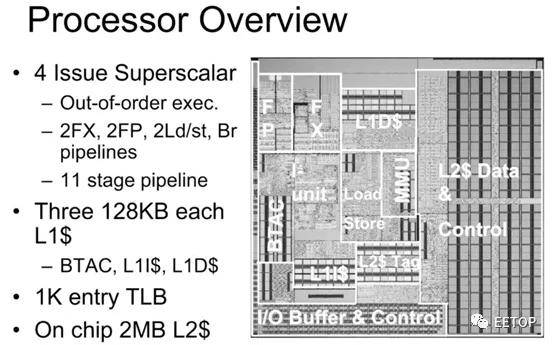
- 超标量、4 发射、真正的 64 位 V9-SPARC 实现
- 定点指令流水线 4 级
- Load 指令流水线 6 级
13.2 SPARC64 V / V+ / VI
13.2.1 SPARC64 V
SPARC64 V 继承了 GS8900 大型主机的核心设计:4 指令派发、非循序预测执行,媒体综述常称其为 15 级流水线。JPS1 手册按功能段描述为:取指段 IA/PS/TT/IM/BB/IR(6 项指令缓冲,每项 32 字节即 8 条指令)→ 发射段 E/D → 执行段 P/B/X → 提交段 U/W,最多 64 条指令在飞。
- 分支预测:BRHIS(branch history)16K 项、4 路组相联,外加返回地址栈(RAS);误预测惩罚约 11 周期
- 执行单元:2 个整数 ALU(EXA/EXB,乘除仅在 EXA)、2 个地址生成器(AGA/AGB)、2 个 FPU(FLA/FLB,各含加法器与乘法器,FLA 附带 VIS 图形单元);6 个 reservation station(每站 8 项),支持投机派发;整数与浮点 update buffer 各 32 项
- 此时的「乘加」还是乘、加两步、两次舍入,单条 FMA 指令要到 VI 才有
- 缓存:L1 128KB 指令 + 128KB 数据,均为 non-blocking,虚拟索引、虚拟标签;片上 L2 1–2MB
- 系统接口:128 位系统总线 @260MHz,SDR/DDR 模式峰值 4.16/8.32 GB/s;PRIMEPOWER 2500 用冗余双交叉开关互连,540MHz source-synchronous,聚合 133 GB/s,每系统板 8.3 GB/s
- RAS——大型主机血统最直观的体现:
- 寄存器、ALU 与内部数据通路奇偶校验
- L1 数据 ECC、L1 标签在 L2 中备份可恢复;L2 数据与标签 ECC;内部总线 ECC
- 硬件指令重试(instruction retry)
- 缓存/TLB 故障时动态降级(limp-along),可预测故障可离线处理
13.2.2 SPARC64 V+
V+ 是 V 的工艺升级版:90nm CMOS、10 层铜互连,约 4 亿晶体管,294.25mm²,时钟 1.82–2.16GHz,L2 增至 3MB/4MB,核心微架构没有大改。
13.2.3 SPARC64 VI
-
2007 年的 SPARC64 VI:90 纳米 SOI、10 层铜,5.4 亿晶体管,421.25mm²,时钟 1.5~2.4GHz,双核心(每核为改进版 V+),导入粗质多线程(Fujitsu 称为 VMT,Vertical Multi-Threading),也是首款实现单条浮点乘积和(FMA)指令的 SPARC 处理器——此前的乘加要分两步、两次舍入。
- VMT 为 Switch-On-Event 式粗粒度多线程:L2 miss、硬件定时器、中断或显式控制指令触发线程切换;PC 与控制/整数/浮点寄存器每线程复制一份,同核线程共享 fTLB/sTLB
- 缓存:每核 L1 128KB;双核共享 6MB 片上统一 L2,12 路组相联,256 字节行;L2 访问总线为 256 位单向读 + 128 位单向写
- 引入 Jupiter Bus 系统互连
13.3 SPARC64 VII
13.3.1 SPARC64 VII Chip
- 架构特性
- 4 核 × 2 线程(SMT)
- 内嵌 6MB L2$
- 2.5GHz
- Jupiter Bus
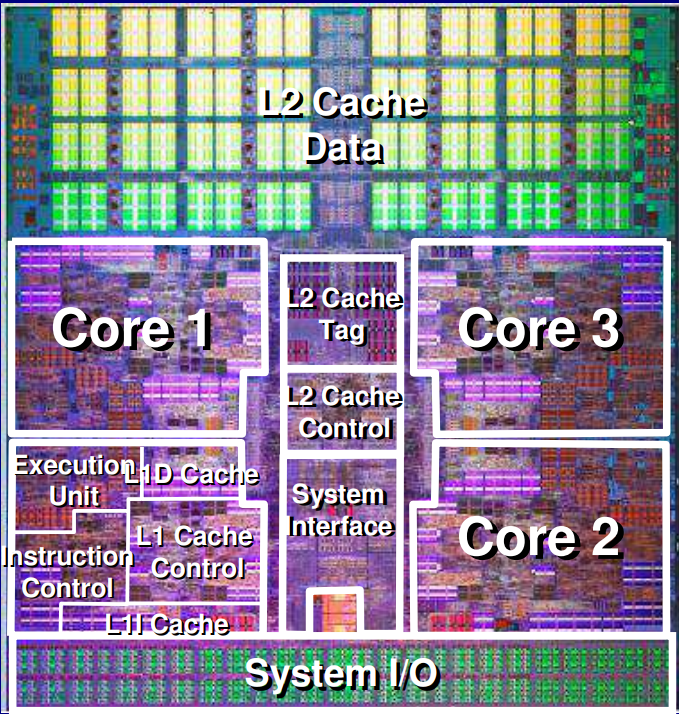
- 工艺:Fujitsu 65nm CMOS,20.31mm × 20.86mm,6 亿晶体管,456 个信号引脚
- 功耗:135 W(max),每核功耗相对 SPARC64 VI 降低 44%
- 微架构
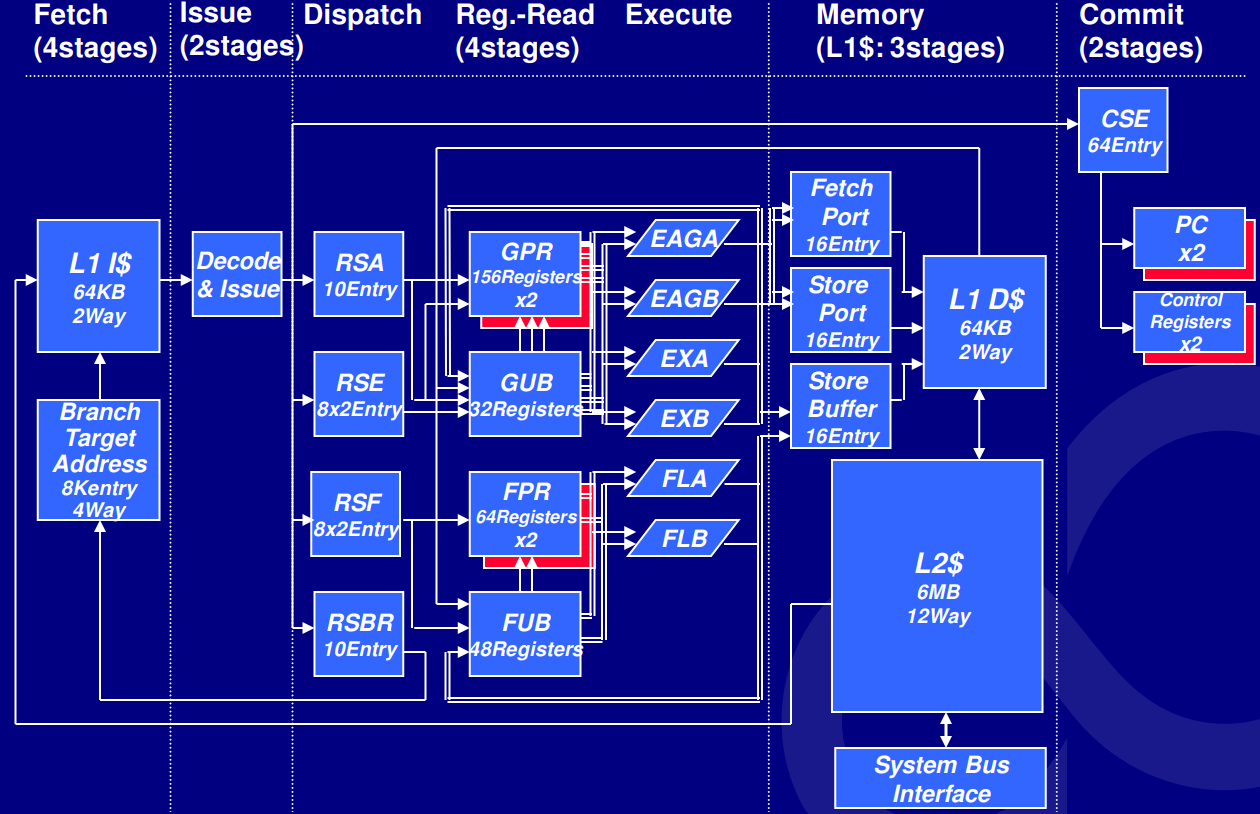
- 约 16 级流水线,fetch/issue/commit 段由两线程共享,部分寄存器每线程复制
- 每核执行单元:2 个整数(EXA/EXB,乘除仅在 EXA)+ 2 个地址生成(EAG)+ 2 个 FPU(FLA/FLB,支持 FMA,除法/开方非流水),reservation station 各 10 项;每核峰值 10.08 GFLOPS
- TLB:32 项 µTLB + 1024 项主 TLB(I/D 分离)
- 缓存:每核 L1 64KB I + 64KB D,2 路;4 核共享 6MB 统一 L2,12 路组相联,写穿;无 L3
- RAS:整数寄存器文件升级为 ECC 保护,片上 error checker 增至约 3400 个
13.3.2 Pipeline Overview
13.3.3 Simultaneous Multi-Threading
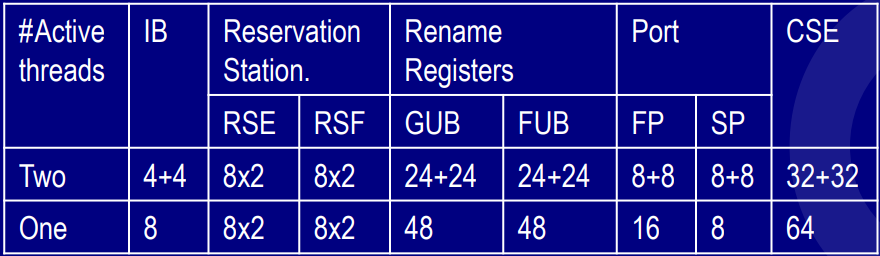
- 细粒度多线程
- 取指/发射/提交阶段:每周期在两线程之间交替选择其一
- 执行阶段:独立于线程,基于「最老的就绪者(oldest-ready)」选择指令
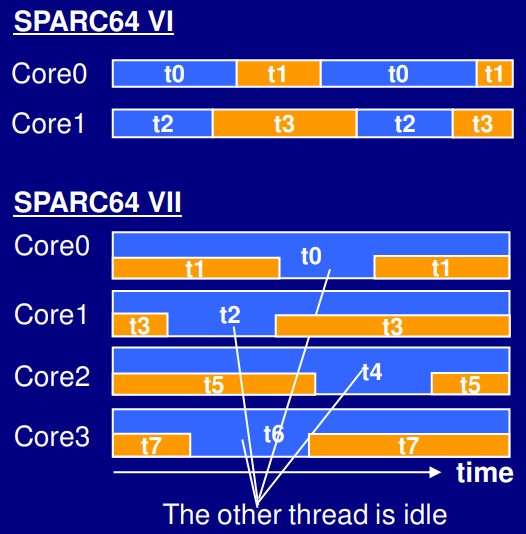
- 分离的硬件队列
- 避免线程之间相互干扰
- 若另一线程空闲,则自动合并
13.3.4 Integrated Multi-core Parallel Architecture
- L2 缓存
- 由 4 个核心共享,避免伪共享(false-sharing)
- L2 缓存与 L1 缓存之间的带宽(为 SPARC64 VI 的 2 倍)
- L2$ → L1$:32 byte/cycle/2core × 4core
- L2$ ← L1$:16 byte/cycle/core × 4core
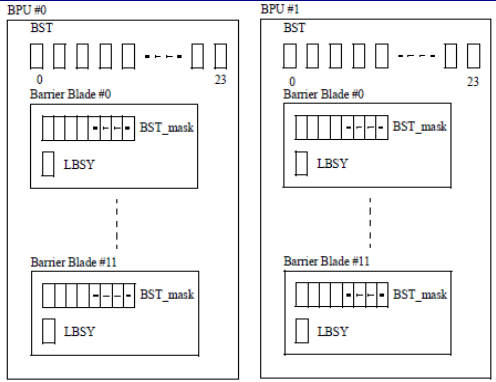
- 硬件栅栏(Hardware Barrier)
- 芯片内核心之间的高速同步机制
- 降低并行执行的开销
13.3.4.1 Hardware Barrier
- 栅栏资源
- BST:Barrier STatus
- BST_mask:选择 BST 中的位
- LBSY:Last Barrier synchronization status
- 当 BST_mask 选中的所有 BST 位被置为同一值时,同步即建立
- 用法
- 每个核心更新 BST
- 等待 LBSY 翻转
13.4 SPARC64 VIIIfx
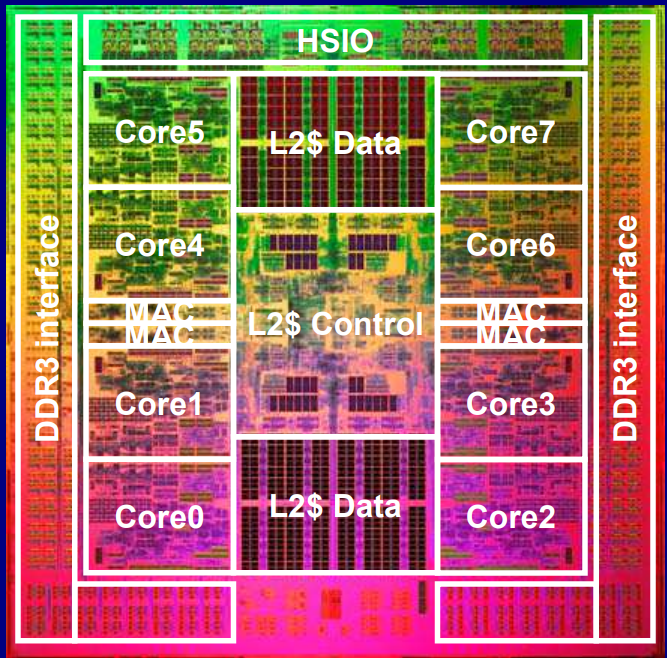
- 架构特性
- 8 核
- 共享 5 MB L2$
- 内嵌内存控制器
- 2 GHz
- 工艺:Fujitsu 45nm CMOS,22.7mm × 22.6mm,7.6 亿晶体管,1271 个信号引脚
- 性能(峰值)
- 128 GFLOPS
- 64 GB/s 内存吞吐
- 功耗
- 58W(TYP,30℃)
- 水冷——低漏电功耗与高可靠性
- 微架构改动(相对 VII)
- 前端去掉多线程;L1 I$ 减半至 32KB;BTAC 从 8192 项 / 8 路减至 1024 项 / 2 路
- 译码前插入一级流水线,专门用于合并 SXAR 前缀指令(见 1.6.5 节)
- 分支 / 整数 reservation station 减至 6 / 10 项,CSE 由 64 减至 48,load queue 由 16 增至 20
- 浮点执行管线前加一级,用来访问扩大的寄存器堆
- 执行与寄存器
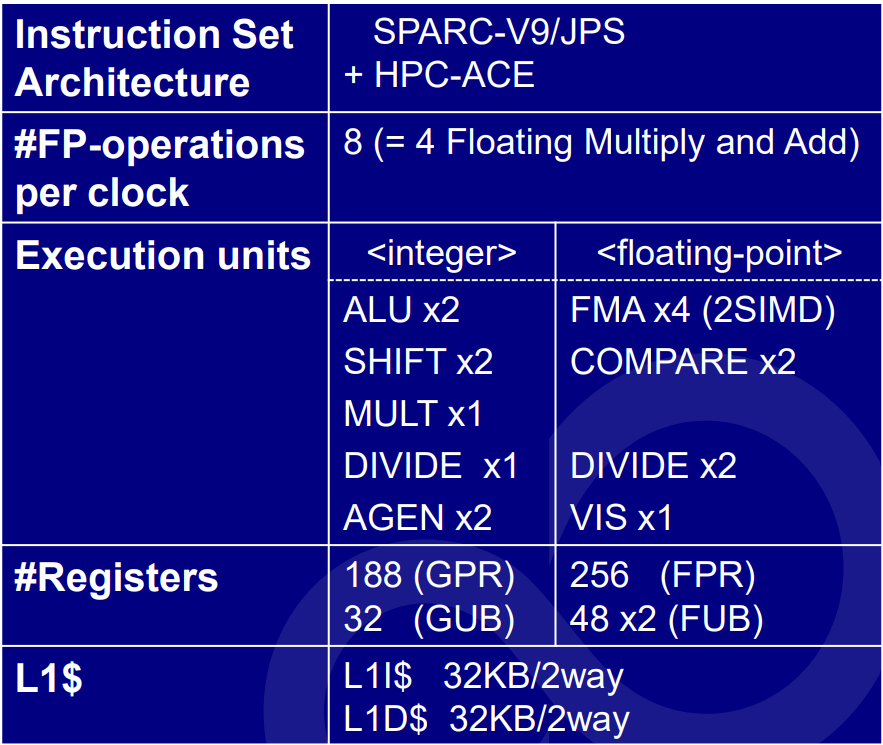
- 2 整数 + 2 地址生成 + 4 个 FMA(FLA/B/C/D,SIMD 一条指令含 2 个 FMA),每核每周期 8 个双精度 FLOP
- 192 个整数寄存器、256 个浮点寄存器(SPARC V9 的 8 倍,经 SXAR 前缀扩展寻址)
- HPC-ACE 另含 sector cache(软件可控)、sin/cos 加速、除法/开方近似指令
- 缓存:每核 L1 32KB I + 32KB D(2 路),D$ 双端口,支持 2×16B SIMD load 或 1×16B SIMD store;8 核共享 5MB L2(12 路、128 字节行、sectored)
- 内存与互连:片上 4 个内存控制器、8 通道 DDR3,容量 64GB、峰值 64 GB/s;经外置 ICC(InterConnect Controller)芯片接 Tofu 6 维 mesh/torus 互连,每链路双向各 5 GB/s、10 个方向
13.4.1 SPARC64 VIIIfx Core spec
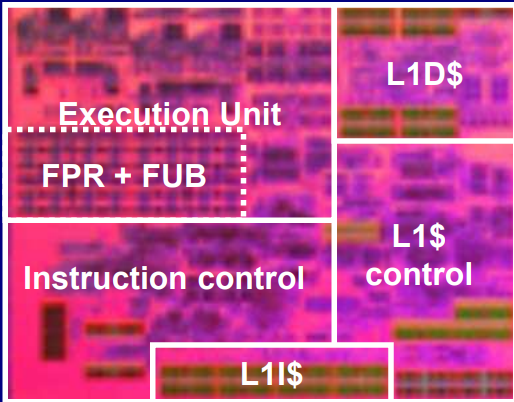
13.4.2 SPARC64 VIIIfx Pipeline
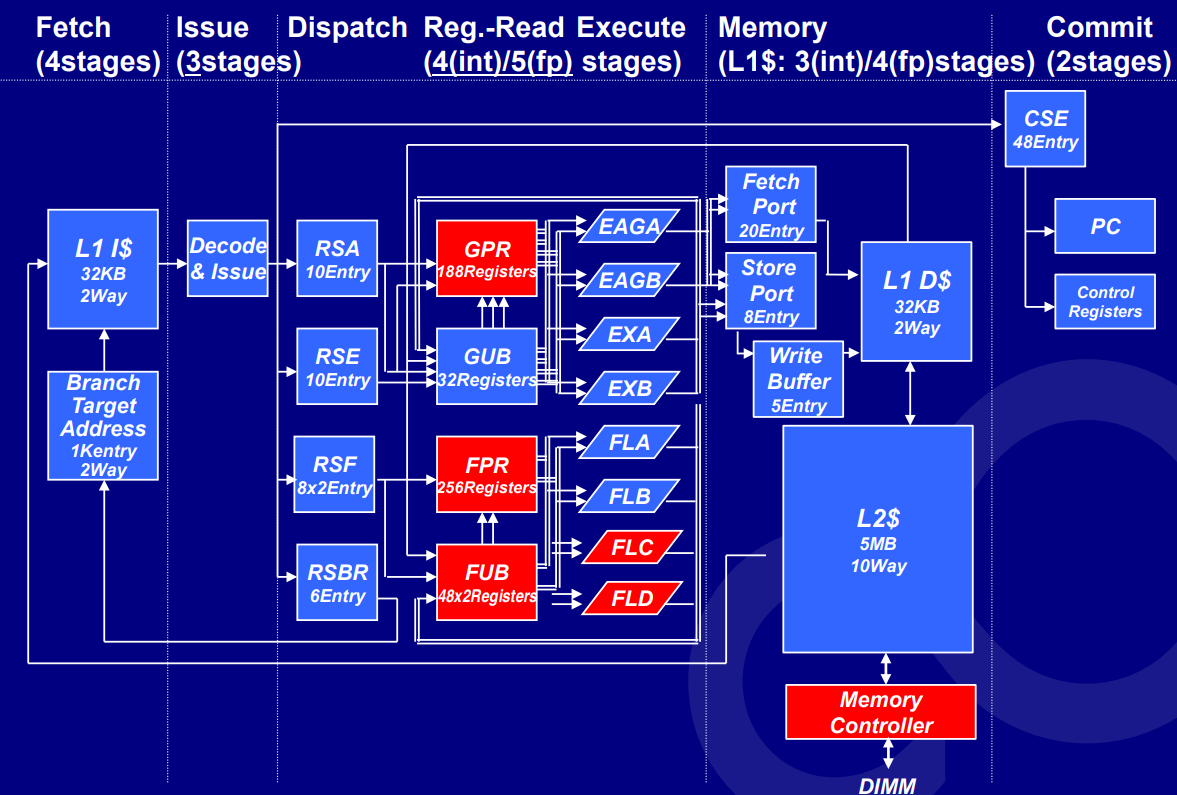
13.5 SPARC64 X / X+
- 2010 年的 SPARC64 VII+ 采用65 纳米制程,时钟提升到 3GHz,L2 快取加倍到 12MB。
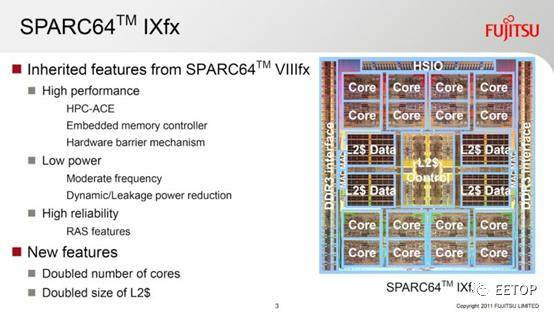
- 2011 年的 SPARC64 IXfx 采用40 纳米制程,时钟 2.85GHz,16 核心,配合 PRIMEHPC FX10 超级电脑而同步发表。总之,只要看到名称内有那个小写的 fx 就知道这是超级电脑特规版了。
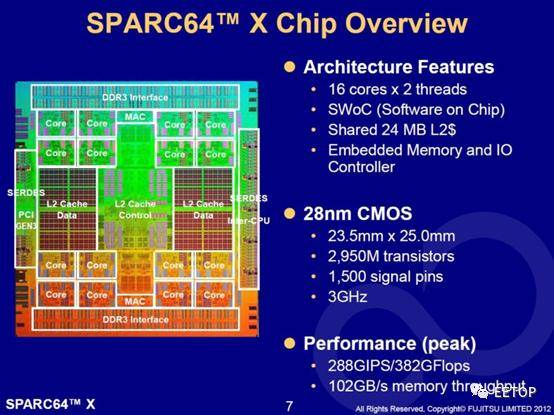
- 2012 年的 SPARC64 X 采用28 纳米制程,时钟 3GHz,16 核心 32 线程,耗电量冲上 270W,存储器控制器也「搬家」到处理器内部了。
13.5.1 SPARC64 X+
- 架构特性
- 16 核 × 2 SMT 线程
- 共享 24 MB L2$
- 内存与 I/O 控制器
- HPC-ACE
- SWoC(Software on Chip)
- 微架构改动(相对 VII+)
- 流水线加深;分支预测改为 4K 项 BRHIS + 16K 项 pattern history table(BTA 4K 项)
- 队列全面加大:RSA 24、RSE 24、RSF 20、RSBR 16、CSE 96、fetch port 32、store port 24
- 寄存器堆:GPR 156×2 + GUB 64,FPR 128×2 + FUB 64
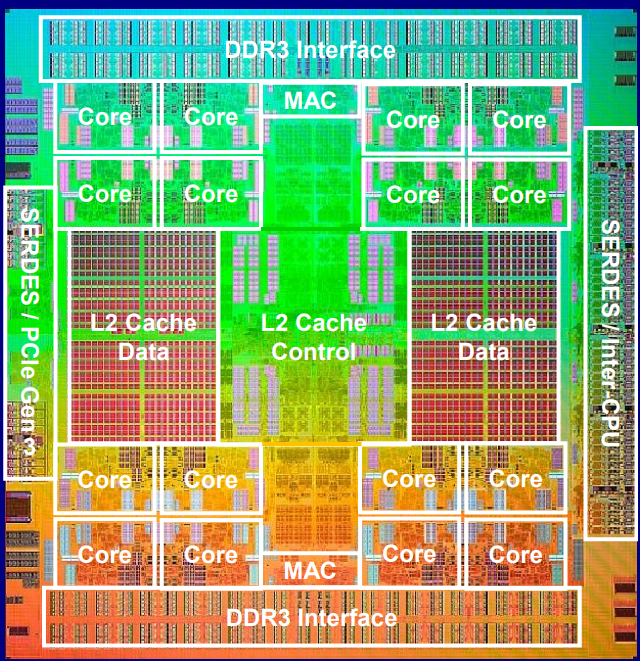
- 执行单元:2EX + 2EX/EAG(每周期可执行 4 条整数指令);FMA ×4(支持 2 路 SIMD)+ FDIV ×2
- 28nm CMOS
- 24.0mm × 25.0mm
- 2,990M 晶体管
- 1,500 个信号引脚
- 3.5GHz+
- 性能(峰值)
- 448 GFLOPS+
- 102 GB/s 内存吞吐
- RAS:SRAM ECC + 硬件指令重试(HIR),flip-flop 广泛奇偶校验;ECC 组列距由 4 扩至 8 以抗多比特翻转;关键 latch 采用 SEILA(soft-error-immune latch,抗单粒子翻转能力提升 100 倍,经大阪大学中子束实验验证)
13.5.1.1 Software on Chip (SWoC)
- Cipher——AES / DES / SHA / RSA
- Decimal(IEEE754 DPD、NUMBER)——加速若干 NUMBER 库
- Database processing
- 在硬件中加速特定的软件功能
- 实现在浮点单元中的 SWoC 引擎可使用 128 个浮点寄存器与软件流水
- 面积/门数 < 核心的 3%、< 芯片的 1%
13.5.1.2 SPARC64 X / X+ System Architecture
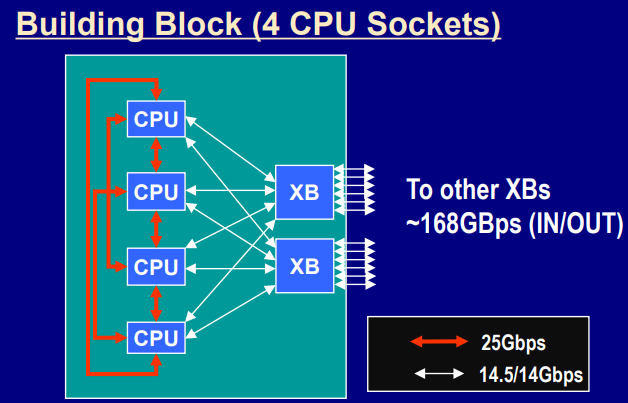
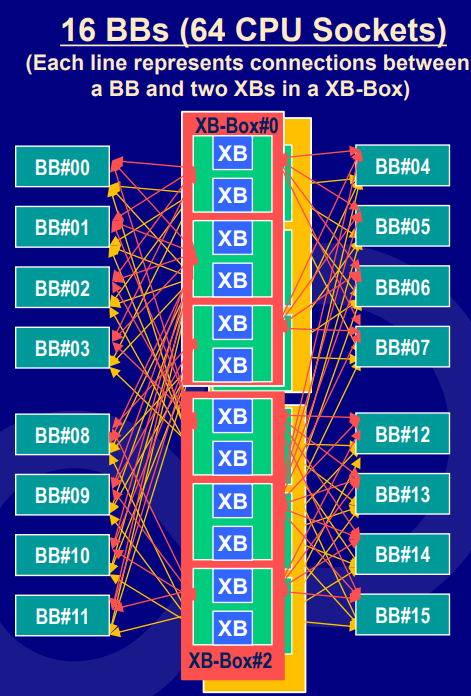
- 从 1 扩展到 64 个 CPU 插槽(2048 线程)
- 基于目录的缓存一致性
- 高速互连,SPARC64 X+ 每 lane 最高 25 Gbps(SPARC64 X 最高 14.5 Gbps)
- 系统配置
- 基本构建块(BB)为 4 个 CPU + 2 个 XB
- 最多 4 个 BB 可由 XB 互连
- 16 个 BB 可通过 XB-Box 互连
13.6 SPARC64 XIfx 与 A64FX
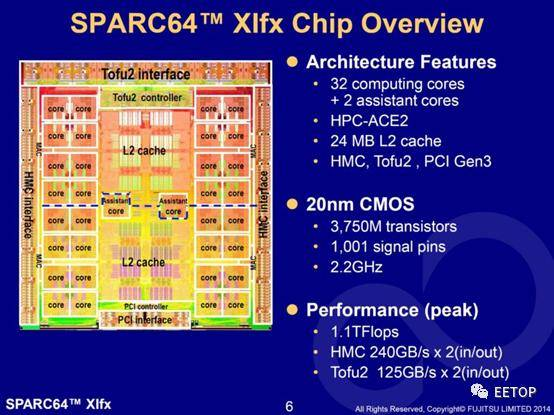
2014 年的 SPARC64 XIfx 采用台积电 20 纳米 HKMG 制程,37.5 亿晶体管,时钟 2GHz,34 核心(32 个运算核心加 2 个辅助核心),新增 HPC-ACE2 指令集。高度整合存储器控制器与汇流排界面的 SPARC64 XIfx 堪称 SPARC 世界第一颗超级电脑系统单芯片。
- 芯片分 2 个 CMG(Core Memory Group),每组 16+1 核共享 12MB L2(共 24MB),CMG 之间为 ccNUMA;整片 1.1 TFLOPS,L1 总带宽 4.4 TB/s
- 核心基于 X+:每核 2 整数 + 2 地址/整数单元 + 8 个 FMA;HPC-ACE2 把 SIMD 拓宽到 256 位(一条指令 4 个双精度 FMA),每核每周期 16 个双精度 FLOP,128 个浮点寄存器;新增 stride/indirect load-store 与 compress/permutation 跨 lane 操作
- 每核 L1 64KB I + 64KB D(4 路);GPR 188 项
- 内存:4 个 HMC(Hybrid Memory Cube) 接口,容量 32GB,每接口 16 lane × 15Gbps,理论带宽 480 GB/s(读 240 + 写 240)——SPARC64 系列第一次用上 3D 堆叠内存
- 互连:片上集成 Tofu2 控制器(10 端口,每链路双向各 12.5 GB/s,25Gbps SerDes 共 40 lane),6 维 mesh/torus,支持 cache injection 与原子操作;机柜间以光缆连接,直接水冷
- 辅助核心 2 个:运行 OS daemon、I/O 与 MPI 异步通信,运算核心不被这些杂务打断
近期夺下 Top500 首位的日本理化学研究所超级电脑「富岳」,其心脏 Fujitsu A64FX,实际上就是将指令集架构,从 SPARC v9 和 HPC-ACE2,替换成 ARM v8.2A 加 SVE 的进化版。
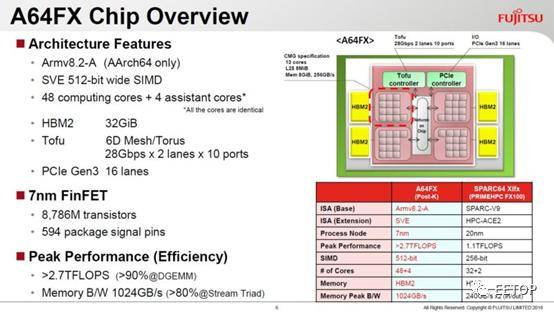
13.7 SPARC64 XII
2017 年的 SPARC64 XII 采用台积电 20 纳米制程,时钟 2.5~4.35GHz,12 核心 96 线程(一个核心 8 线程,和 IBM Power9 一样)。
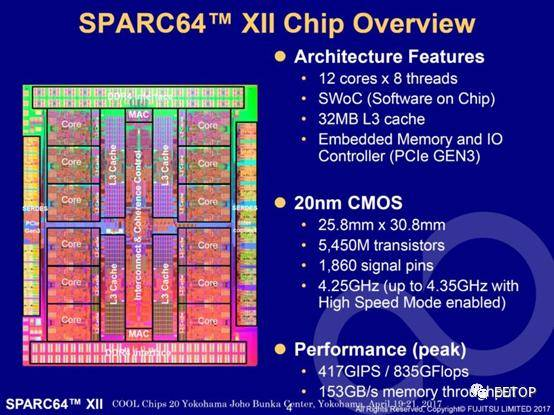
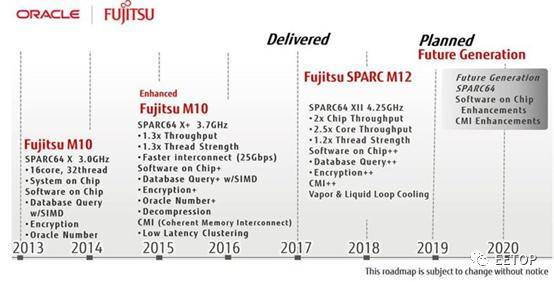
- 每个核心内含两条独立的指令流水线,各自每周期取指 8 条、译码 4 条、执行 6 条,每条流水线 4 路 SMT,合计每核 8 线程;两条流水线之间仅共享 TLB、L1 I$ 与 L2——与其说是 8 线程单核,不如说更像「核内双芯」
- 54.5 亿晶体管,795mm²,时钟 4.25GHz(High-Speed Mode 4.35GHz)
- 缓存:L1 D$ 每流水线 32KB(4 路,每核合计 64KB),L1 I$ 每核 64KB(4 路)共享,L2 每核 512KB(16 路);系列首次引入 L3:32MB,16 路
- 内存:8 通道 DDR4-2400,峰值 153 GB/s,单 CPU 最大 1.5TB;4 条 PCIe Gen3 x8
- 系统:2 个 CPU 组成一个 Building Block,可扩展至 32 CPU / 48TB
- RAS:端到端 ECC 与数据通路完整性保证、instruction retry 自动恢复、L1/L2/L3 缓存 way 动态降级、内存 ECC/扩展 ECC、内存镜像、周期 patrol scrubbing 与 predictive self-healing
13.8 结语
回头看 SPARC 这三十余年:出身伯克利开放的 RISC 思潮,靠寄存器窗口立身,九十年代凭超标量与 VIS 站上巅峰;x86 碾压过来之后,又果断放弃单线程军备竞赛,转进 Throughput Computing,用 Niagara 重新定义了服务器处理器该有的样子——这套思路在今天的众核与吞吐型加速器上仍然清晰可见。
另一端的 Fujitsu SPARC64 自始至终抱着大型主机级的 RAS 与浮点性能,从 GS8900 的血统一路走到 SPARC64 XII,最后把 HPC 的家底搬到 ARM 架构上,成就了「富岳」与 A64FX。
参考文献
- Leon, A.S., Shin, J.L., Tam, K.W., Bryg, W., Schumacher, F., Kongetira, P., Weisner, D., Strong, A., Mircrosystems, S., 2006. 5.1 A Power-Efficient High-Throughput 32-Thread SPARC Processor.
- Kongetira, P., Aingaran, K., Olukotun, K., 2005. Niagara: A 32-Way Multithreaded Sparc Processor. IEEE Micro 25, 21–29. https://doi.org/10.1109/MM.2005.35
- P. Kongetira, “A 32-Way Multithreaded SPARC Processor,” 16th Hot Chips Symp., Aug., 2004.
- G. Grohoski, “Niagara-2: A highly threaded server-on-a-chip,” 2006 IEEE Hot Chips 18 Symposium (HCS), Stanford, CA, USA, 2006, pp. 1-22, doi: 10.1109/HOTCHIPS.2006.7477874.
- Baldwin, T., n.d. UltraSPARC T2: A Highly-Threaded Power-Efficient, SPARC SOC.
- Hughes, J., Morton, G., Pechanec, J., Schuba, C., Spracklen, L., Yenduri, B., 2009. Transparent multi-core cryptographic support on Niagara CMT Processors, in: 2009 ICSE Workshop on Multicore Software Engineering. Presented at the 2009 ICSE Workshop on Multicore Software Engineering (IWMSE), IEEE, Vancouver, BC, Canada, pp. 81–88. https://doi.org/10.1109/IWMSE.2009.5071387
- G. K. Konstadinidis et al., “SPARC M7: A 20 nm 32-Core 64 MB L3 Cache Processor,” in IEEE Journal of Solid-State Circuits, vol. 51, no. 1, pp. 79-91, Jan. 2016, doi: 10.1109/JSSC.2015.2456902.
- P. Li et al., “4.2 A 20nm 32-Core 64MB L3 cache SPARC M7 processor,” 2015 IEEE International Solid-State Circuits Conference - (ISSCC) Digest of Technical Papers, San Francisco, CA, USA, 2015, pp. 1-3, doi: 10.1109/ISSCC.2015.7062931.
- Kathirgamar Aingaran, Sumti Jairath, Georgios Konstadinidis, Serena Leung, Paul Loewenstein, Curtis McAllister, Stephen Phillips, Zoran Radovic, Ram Sivaramakrishnan, David Smentek, and Thomas Wicki. 2015. M7: Oracle’s Next-Generation Sparc Processor. IEEE Micro 35, 2 (Mar.-Apr. 2015), 36–45. https://doi.org/10.1109/MM.2015.35
- R. Sivaramakrishnan and S. Jairath, “Next generation SPARC processor cache hierarchy,” 2014 IEEE Hot Chips 26 Symposium (HCS), Cupertino, CA, USA, 2014, pp. 1-28, doi: 10.1109/HOTCHIPS.2014.7478828.
- SPARC International, Inc., The SPARC Architecture Manual, Version 8, 1992. (后成为 IEEE Std 1754-1994)
- SPARC International, Inc., The SPARC Architecture Manual, Version 9, Prentice Hall, 1994.
- Weaver, D. L. and Germond, T. (Eds.), The SPARC Architecture Manual, Version 9, SPARC International, 1994.
- Sun Microsystems, OpenSPARC T1 Microarchitecture Specification, 2006.
- Stanford VLSI Group, CPU DB — UltraSPARC III (Cheetah), TI C07a / 0.18 μm / 6LM Al. http://cpudb.stanford.edu/processors/566.html
- cpu-collection.de, Sun Microsystems UltraSPARC III / III Cu / IIIi. https://cpu-collection.de/?l0=co&l1=Sun+Microsystems&l2=UltraSPARC++III
- Konstadinidis, G. K. et al., “Implementation of a Third-Generation 1.1-GHz 64-bit Microprocessor,” IEEE Journal of Solid-State Circuits, vol. 37, no. 11, 2002. https://doi.org/10.1109/JSSC.2002.803951
- Sun Microsystems, UltraSPARC-I Data Sheet (STP1030A), 1996. https://datasheets.chipdb.org/Sun/stp1030a.pdf
- Texas Instruments / Sun Microsystems, SuperSPARC Microprocessor Fact Sheet (TMS390Z50), 1992.
- Chaudhry, S. et al., “Rock: A SPARC CMT Processor,” IEEE Micro, vol. 29, no. 2, pp. 6–16, 2009. https://doi.org/10.1109/MM.2009.34
- Turullols, S. et al., “SPARC T5: A 28nm 16-Core 64-Thread Server Processor,” Hot Chips 24, 2012.
- Maruyama, T. et al., “SPARC64 VIIIfx: A New-Generation Octocore Processor for Petascale Computing,” IEEE Micro, vol. 30, no. 2, 2010. https://doi.org/10.1109/MM.2010.41
- Fujitsu, SPARC64 X / X+ Processor, Hot Chips 24, 2012.
- Fujitsu, SPARC64 XII (M12-2) Datasheet / Fujitsu Scientific and Technical Journal, 2017.