
1 概述
投机解码(Speculative Decoding)是一类面向自回归大语言模型(LLM)推理加速的无损解码技术。其基本思想是:以一个轻量的草稿模型(draft model)在低计算开销下并行预测未来 $k$ 个候选 token,再由目标模型(target model)在单次前向传播中并行验证全部候选,并保留通过验证的最长前缀。由此,解码过程由”逐 token 串行”转变为”逐块并行”,在保持输出分布严格不变的前提下显著提升生成吞吐。
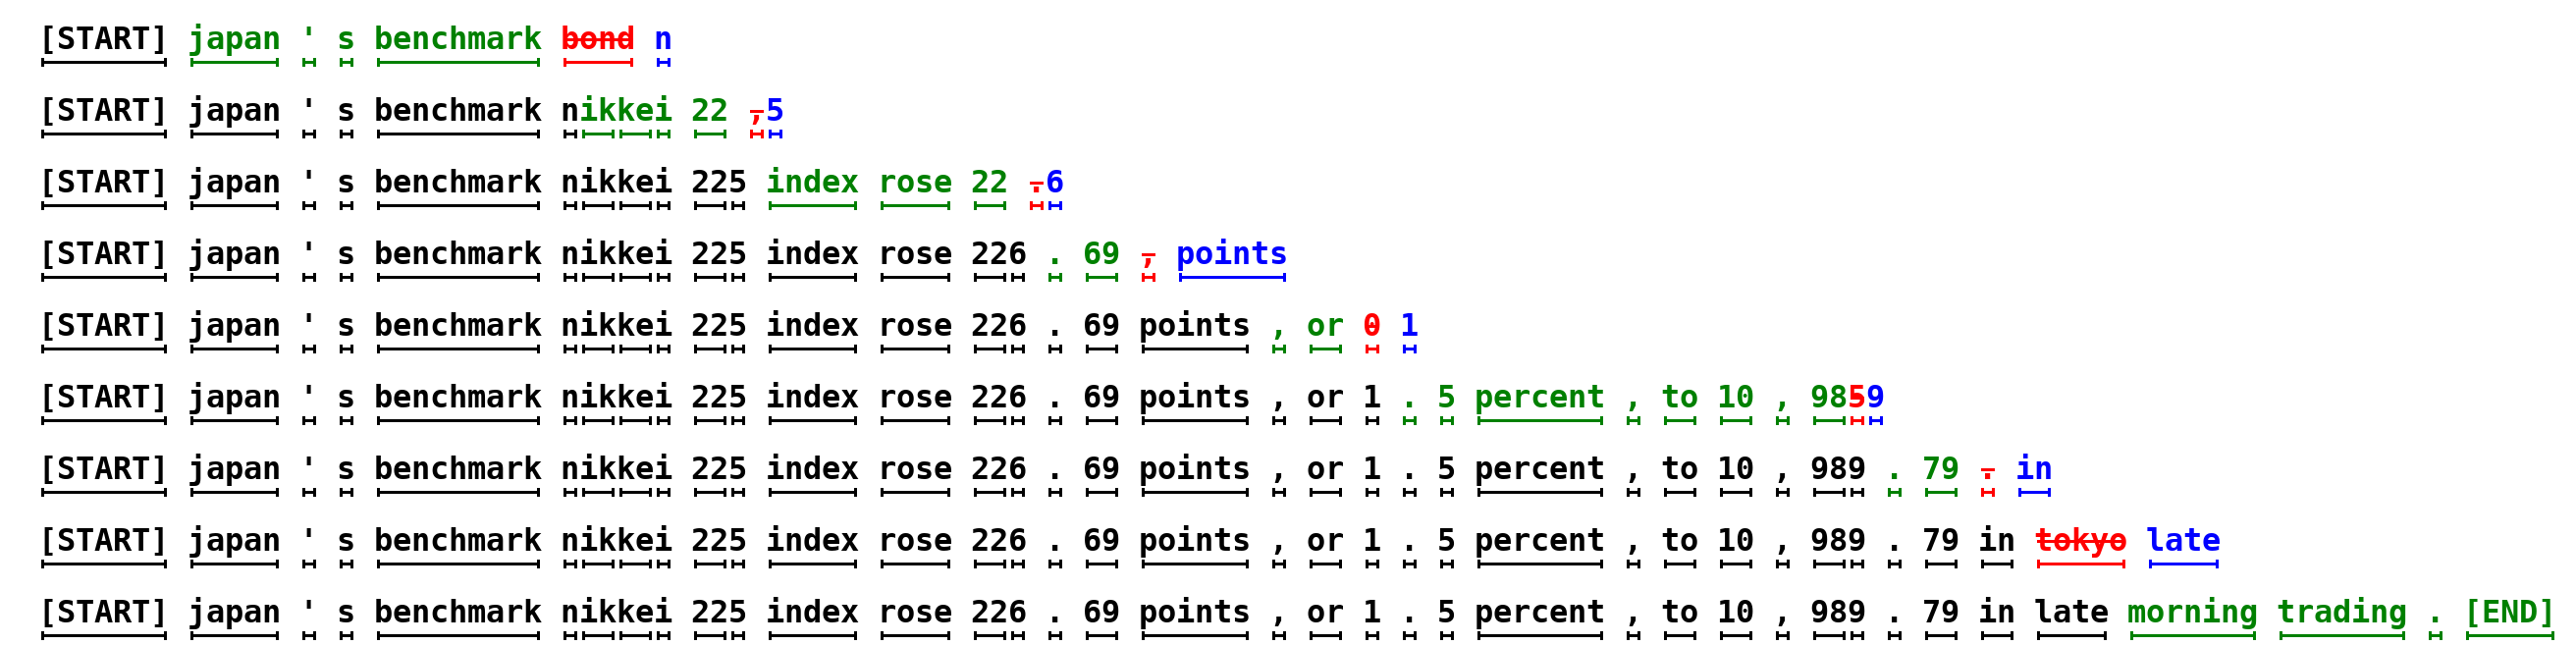 图 1:投机解码的基本流程(Leviathan et al., 2022, Figure 1)。绿色为草稿模型提出的候选 token,红色为验证失败后由目标模型分布改写的 token;每轮迭代中目标模型仅需一次前向即可提交多个 token。
1.1 问题定义与计算瓶颈
给定上下文序列 $x_{<t} = (x_1, \dots, x_{t-1})$,标准自回归解码在每一步从目标模型 $p_\theta$ 的输出分布中采样一个 token:
\[x_t \sim p_\theta(\cdot \mid x_{<t}),\]并将 $x_t$ 追加至上下文后重复该过程。该范式的瓶颈在于:每生成一个 token 都需要完整执行一次前向传播。在 batch size 为 1 的解码阶段,计算访存比(arithmetic intensity)极低,GPU 算力大部分时间消耗于权重搬运(memory-bandwidth bound)而非矩阵运算。因此解码吞吐的实际上限由显存带宽决定,单步延迟近似等于权重自显存读入计算单元的时间。
投机解码正是利用了这一特性:在一次前向中验证 $k$ 个 token 的额外计算开销近似可忽略,但每轮的有效产出可由 1 个 token 提升至 $\mathbb{E}[\tau] > 1$ 个,其中 $\tau$ 表示接受长度(acceptance length)。
1.2 投机解码的基本流程
记草稿模块为 $q_\phi$(既可以是独立的小型语言模型,也可以是附着于目标模型的轻量草稿头)。每轮解码包含三个阶段:
- 草稿生成(Drafting):草稿模块以较低开销生成候选序列 $y_{1:k}$,其参数量与计算量远小于目标模型;
- 并行验证(Verification):目标模型以 $(x_{<t}, y_{1:k})$ 为输入执行一次前向,同时获得各位置的条件分布 $p_\theta(\cdot \mid x_{<t}, y_{<i})$;
- 接受与修正(Accept & Correct):自左向右逐位验证,接受与目标分布一致的最长前缀;于首个被拒绝位置处,由 $p_\theta$ 采样一个修正 token 作为该位置的输出,并以该位置为新起点进入下一轮。
1.3 无损性与加速比
无损性(Losslessness)。标准验证机制采用拒绝采样(rejection sampling):候选 token $y_i$ 以概率
\[\min\left\{1,\ \frac{p_\theta(y_i \mid x_{<t}, y_{<i})}{q_\phi(y_i \mid x_{<t}, y_{<i})}\right\}\]被接受;若被拒绝,则从 $p_\theta$ 的(截断)分布中重采样。该机制保证最终输出序列的边缘分布与目标模型独立解码严格一致(Leviathan et al., 2022; Chen et al., 2023),即加速不以牺牲生成质量为代价。在贪心解码(temperature $= 0$)下,验证退化为逐位 argmax 比对。
加速比。设草稿耗时为 $t_d$、验证耗时为 $t_v$、目标模型单步解码耗时为 $t_0 \approx t_v$,则理论加速比为
\[S = \frac{\mathbb{E}[\tau] \cdot t_0}{t_d + t_v},\]其中 $\tau \in {1, \dots, k{+}1}$ 为每轮接受长度。由此可导出各方法的统一优化目标:
- 降低草稿耗时 $t_d$;
- 提高草稿质量,即增大接受长度 $\mathbb{E}[\tau]$;
- 避免将验证预算浪费于高拒绝风险的候选位置。
1.4 技术路线演进
| 技术路线 | 代表方法 | 核心机制 |
|---|---|---|
| 独立草稿模型 | Leviathan 2022 / Chen 2023 | 独立小模型自回归生成草稿,目标模型并行验证 |
| 多头并行预测 | Medusa | 目标模型挂载多个独立预测头,一次前向并行产出多个候选 |
| 自回归草稿头 | MTP、EAGLE | 复用目标模型的特征与输出权重,训练轻量草稿头执行自回归外推 |
| 并行/半自回归草稿 | DFlash、DSpark | 以块扩散或半自回归结构在单次前向中并行产出整块草稿 |
2 Draft
草稿生成(Drafting)是投机解码框架中决定加速上限的核心组件。由 1.3 节的加速比公式可知,草稿器同时决定分子 $\mathbb{E}[\tau]$(草稿质量)与分母中的 $t_d$(草稿开销)。本章对草稿生成的设计空间、结构选择与长度调度进行系统梳理;第 3–6 章介绍的具体方法均可视为该设计空间中的代表性实例。
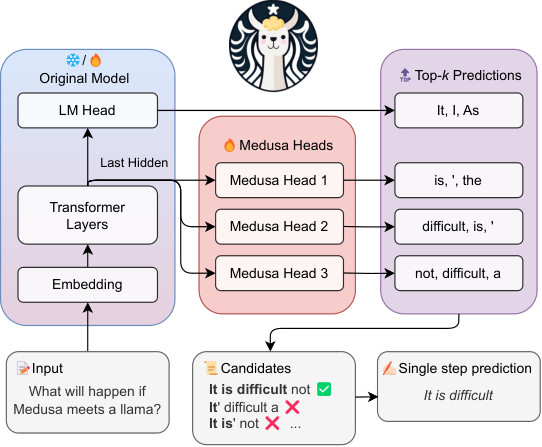 图 2:草稿头的典型结构(Cai et al., 2024, Figure 1, Medusa)。在目标模型最后隐藏状态上并行挂载多个轻量解码头(Medusa Heads),每个头预测一个未来位置的 top-$k$ 候选;候选组合经树式验证后单步提交最长正确前缀。
2.1 草稿器的形式化角色
定义位置 $i$ 的条件接受率(conditional acceptance rate)为
\[a_i = \Pr\big(y_i \text{ 通过验证} \mid y_{<i} \text{ 全部通过验证}\big).\]对链式草稿(chain drafting),每轮提交的 token 数为 $\tau = N + 1$,其中 $N$ 为通过验证的草稿 token 数,$+1$ 为首个被拒绝位置处由目标模型提交的修正 token。于是
\[\mathbb{E}[\tau] = 1 + \sum_{i=1}^{k} \prod_{j=1}^{i} a_j.\]实践中 $a_i$ 通常随位置 $i$ 递增而衰减(后缀衰减,suffix decay),因此单纯增大草稿长度 $k$ 的边际收益递减。草稿器设计面临两个基本矛盾:
- 精度–开销矛盾:自回归草稿器的接受率高,但草稿耗时随长度线性增长($t_d = O(k)$);
- 依赖–并行矛盾:完全并行草稿使 $t_d = O(1)$,但各位置预测相互独立、缺乏块内依赖建模,后缀衰减严重。
2.2 草稿器的设计空间
- 独立草稿模型(Independent draft model):$q_\phi$ 为独立训练的小型语言模型,通常经序列级蒸馏(sequence-level distillation)从 $p_\theta$ 蒸馏而来(图 1 即属此类)。优点是与目标模型完全解耦、易于替换;缺点是草稿分布与目标分布存在错位(distribution mismatch),压低 $a_i$,且引入额外的显存与部署开销。
- 共享主干草稿头(Self-drafting heads):在目标模型上挂载轻量草稿模块,复用其主干特征或输出权重,包括 Medusa(并行独立头)、MTP(联合训练的辅助头,见第 3 章)与 EAGLE(特征层自回归草稿头,见第 4 章)。草稿分布与目标分布天然对齐,且无需独立模型。
- 并行/半自回归草稿(Parallel & semi-autoregressive drafting):以块扩散(DFlash,见第 5 章)或半自回归结构(DSpark,见第 6 章)在单次前向中并行产出整块草稿,使 $t_d$ 与 $k$ 解耦,其核心挑战在于抑制后缀衰减。
- 免训练草稿(Training-free draft sources):Lookahead/Jacobi 解码、$n$-gram / prompt-lookup、检索与缓存复用等。无需任何训练,但接受率高度依赖生成内容的重复结构,适合特定场景。
2.3 草稿结构:链与树
链式草稿每轮仅提出一条候选序列;树式草稿(tree drafting)则在每个节点扩展 top-$w$ 个分支,并通过树形注意力掩码(tree attention)在单次前向中验证整棵候选树。设节点 $v$ 的路径置信度为沿根到 $v$ 各边条件接受率之积,则树结构在同等验证预算下显著提高命中概率,$\mathbb{E}[\tau]$ 相应提升。
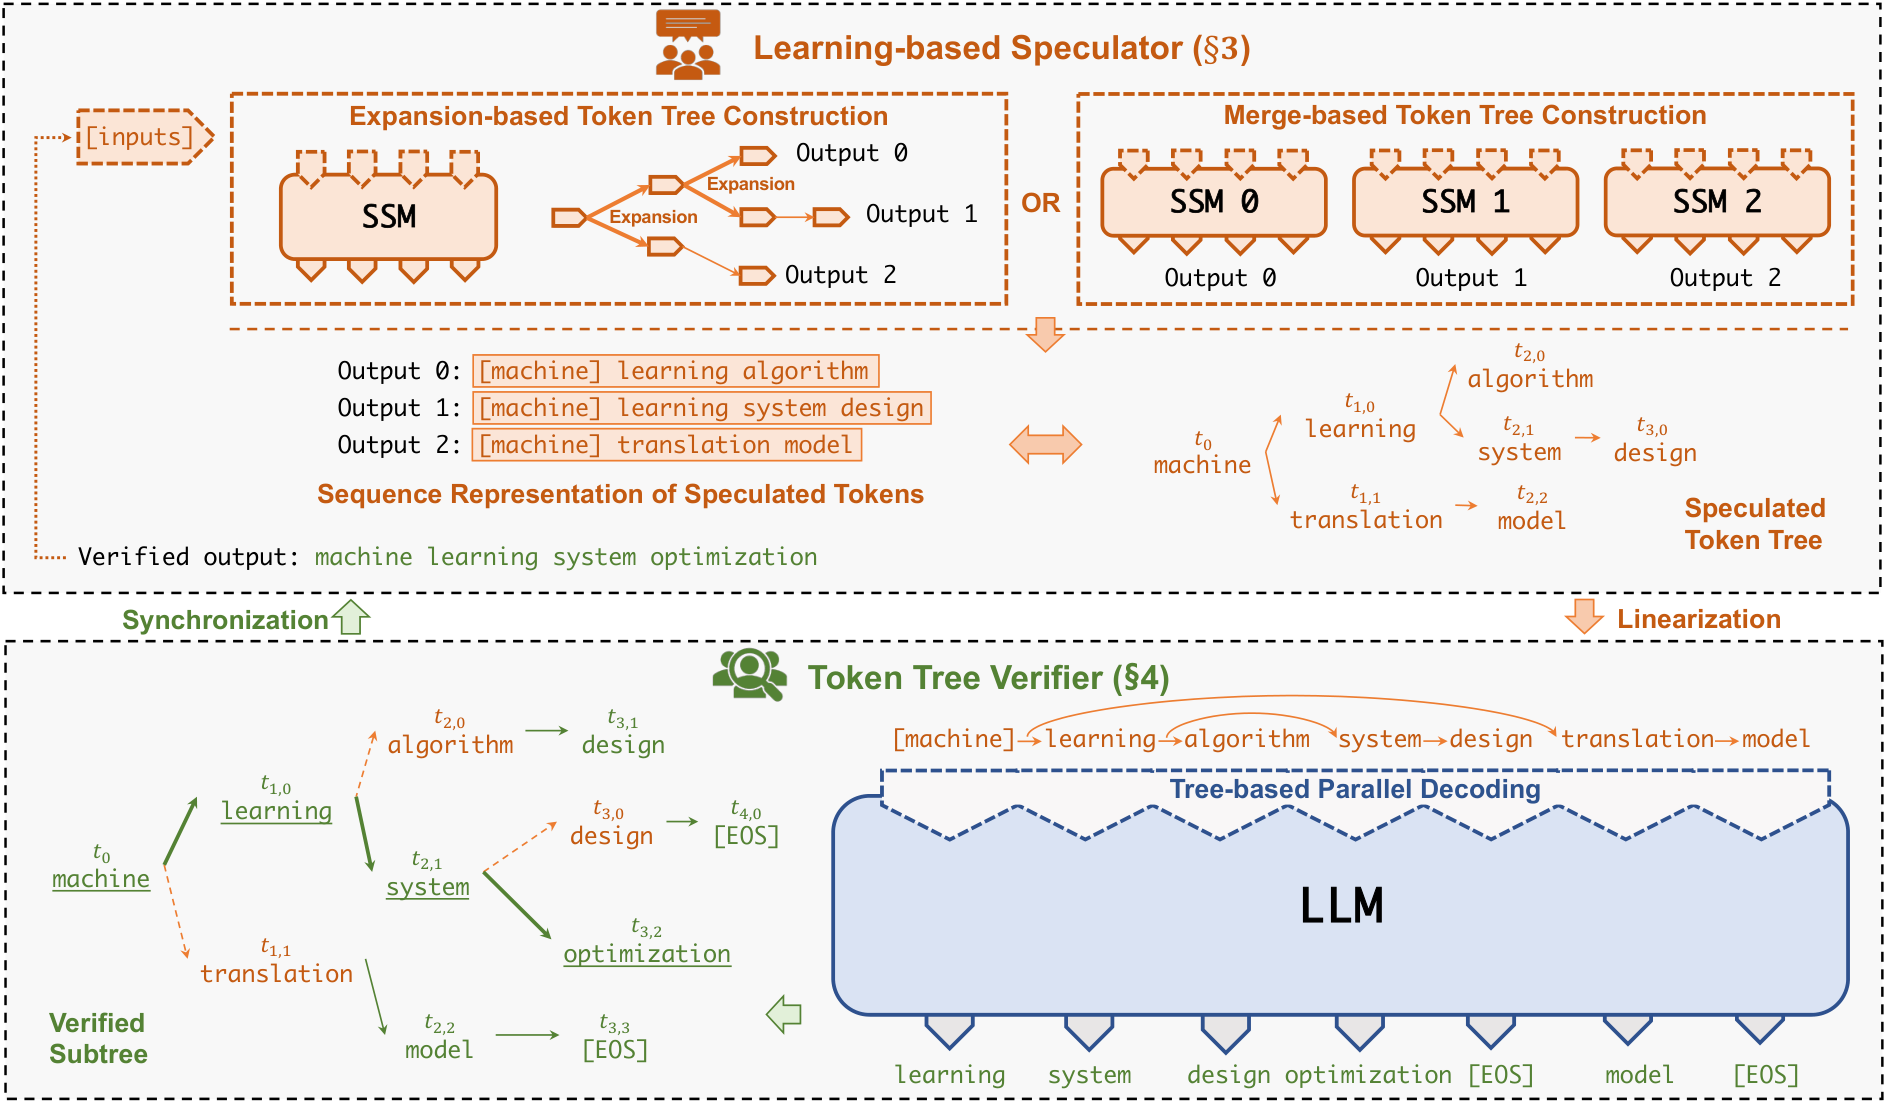 图 3:树式草稿与树验证的总体结构(Miao et al., 2024, Figure 3, SpecInfer)。草稿端以扩展式或合并式构造 token 树(Speculated Token Tree),验证端将树线性化后由目标模型执行树状并行解码(Tree-based Parallel Decoding),最终同步通过验证的子树(Verified Subtree)。
树式草稿的代表工作包括:SpecInfer 的 token 树构造与树验证机制(Miao et al., 2024)、Medusa 的树注意力并发验证(Cai et al., 2024)、EAGLE-2 的置信度驱动动态树(见 4.2 节),以及面向块扩散草稿的 DDTree(见 5.3 节)。
2.4 草稿长度与验证预算
草稿长度 $k$ 的选择存在明确权衡:增大 $k$ 提高潜在的 $\mathbb{E}[\tau]$,但同时推高 $t_d$(自回归草稿)或加剧验证浪费(并行草稿中高拒绝风险候选占用批处理容量)。Leviathan et al. (2022) 给出最优草稿长度 $\gamma^*$ 随接受率 $\alpha$ 与草稿/验证代价比的闭式分析。实践中 $k$ 往往依系统负载自适应:低负载时延长草稿以利用空闲带宽,高负载时缩短草稿以降低验证浪费——DSpark 的置信度调度验证即为该思路的生产级实现(见 6.1 节)。
3 MTP
多 token 预测(Multi-Token Prediction, MTP)将语言模型的训练目标由单一的下一 token 预测扩展为对未来 $D$ 个 token 的联合预测。其辅助预测头在推理阶段可直接充当草稿模块,构成自投机解码(Self-Speculative Decoding)范式——无需独立部署草稿模型。
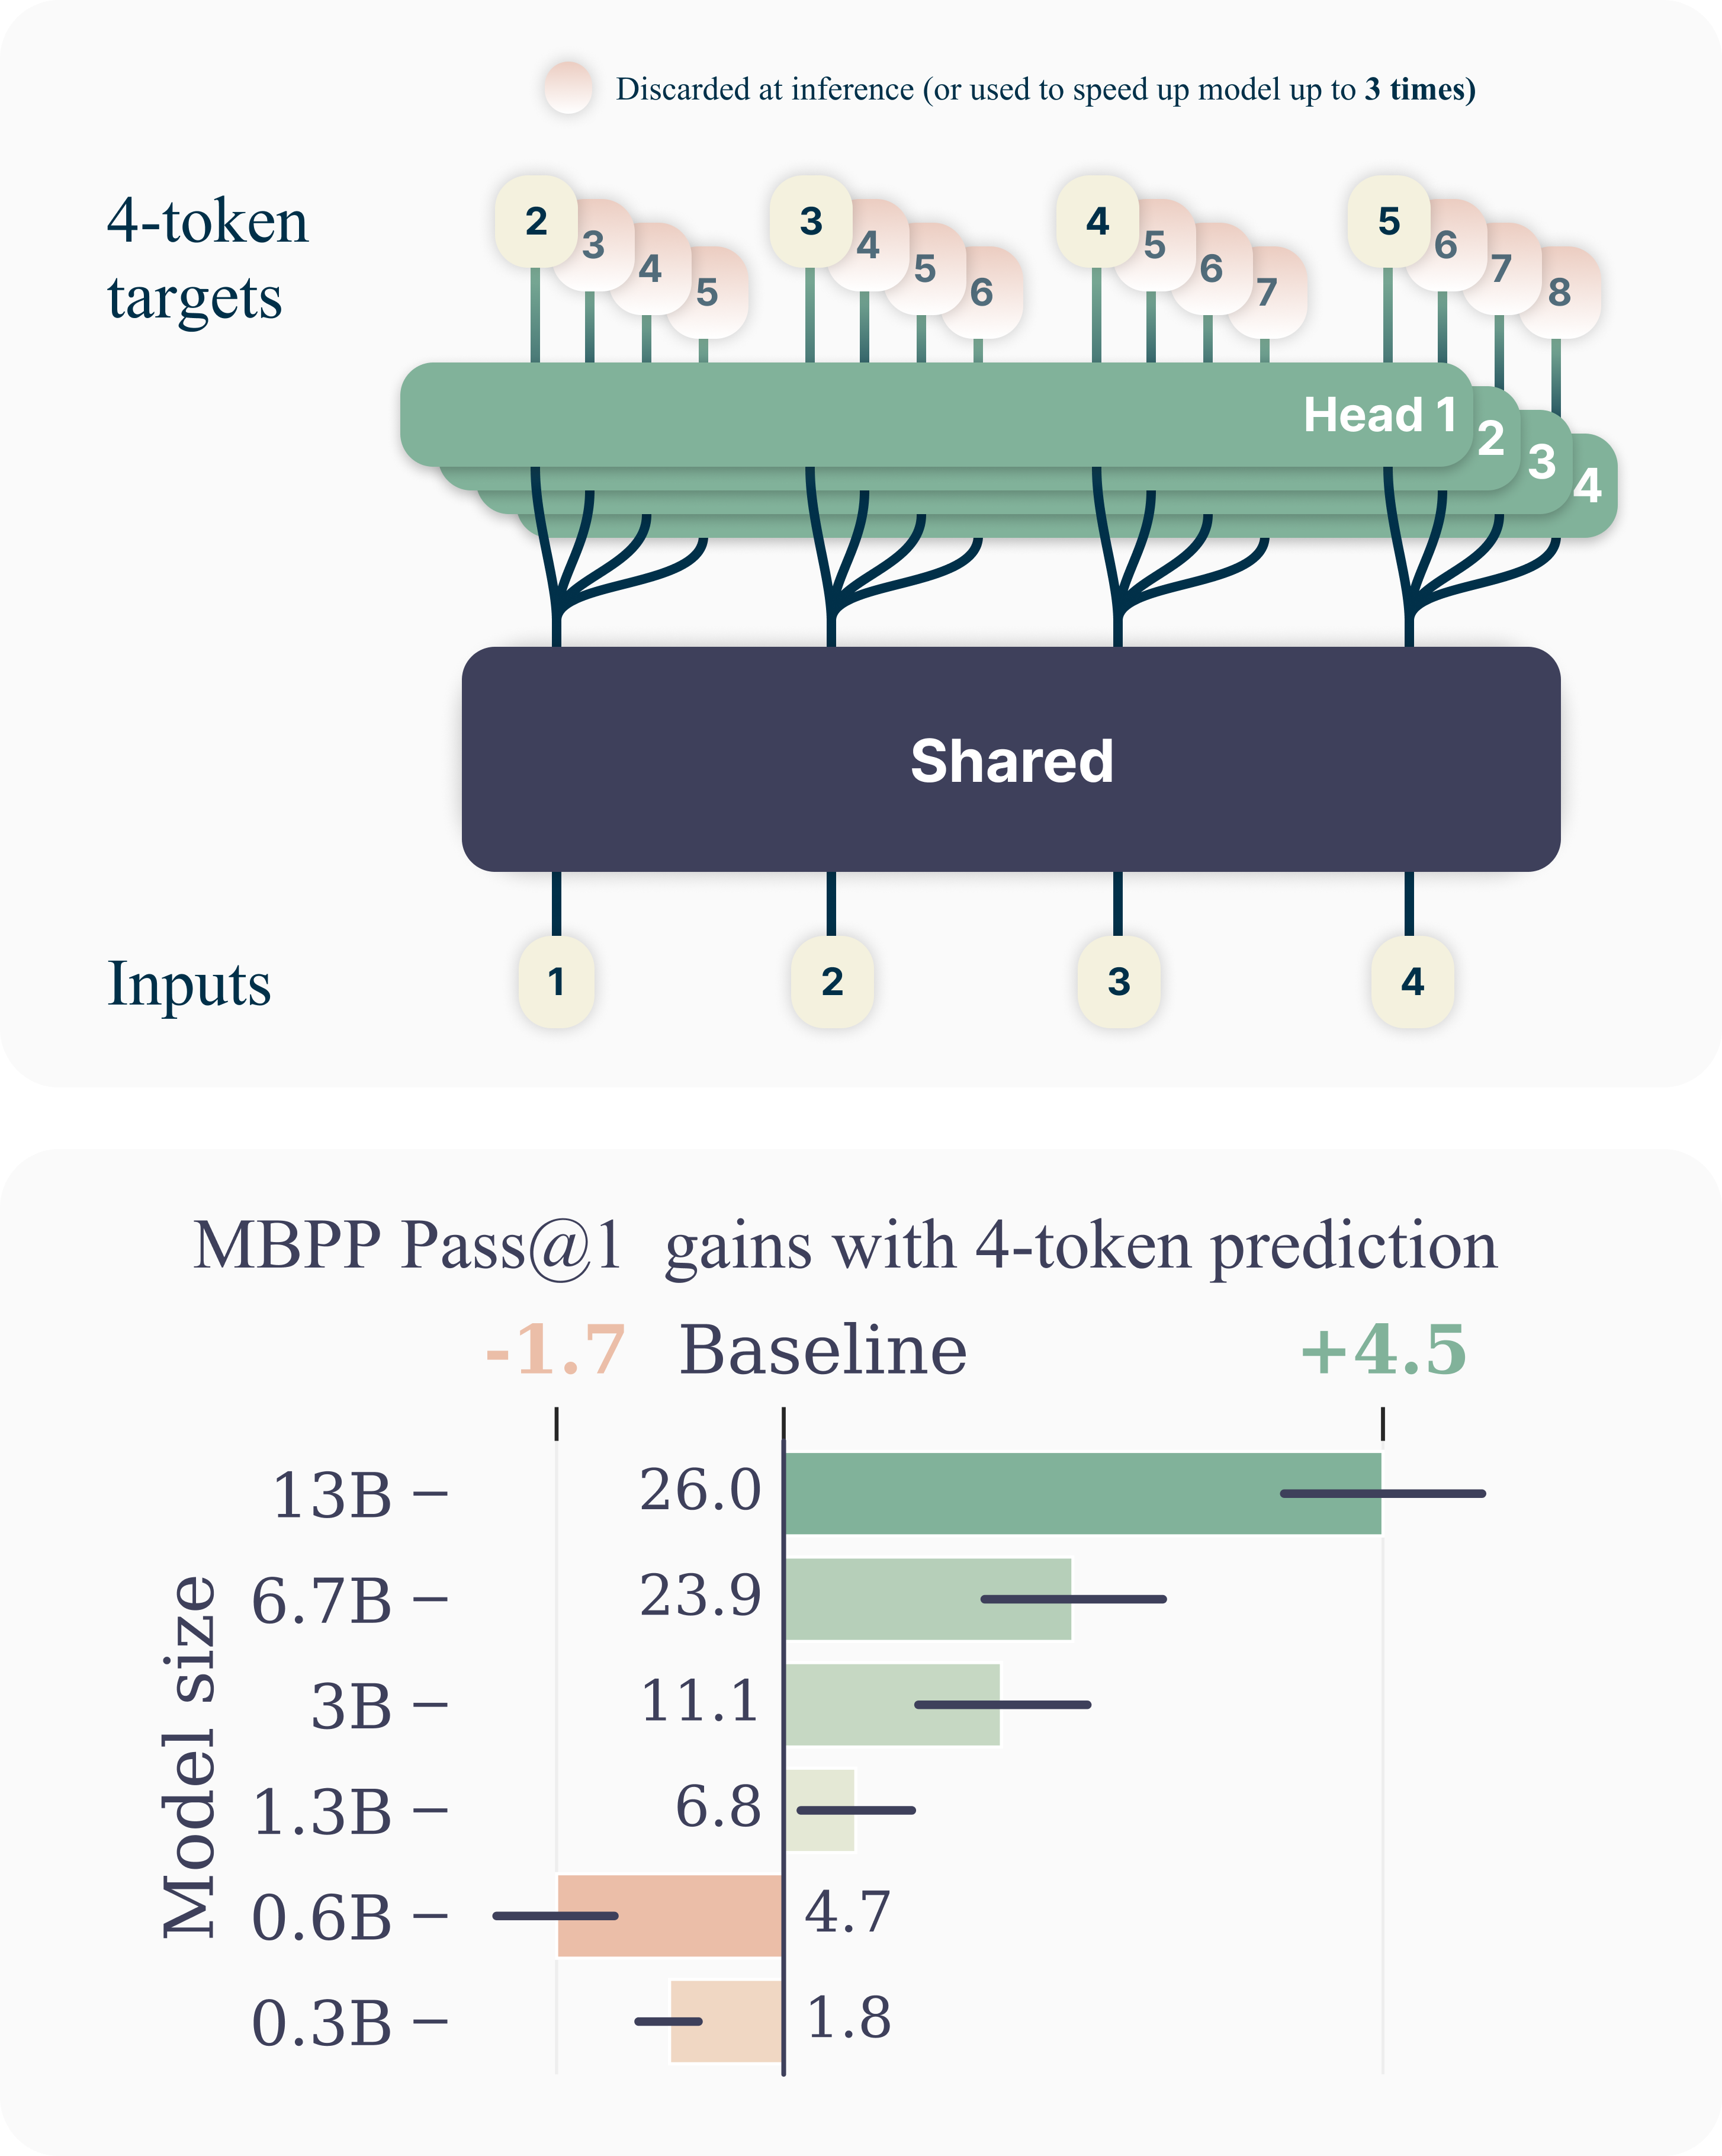 图 4:MTP 原始论文结构图(Gloeckle et al., 2024, Figure 1)。共享主干(shared trunk)与 $D=4$ 个专用输出头:训练时每个位置同时预测 4 个未来 token;推理时辅助头可被丢弃,亦可用于投机解码加速(最高约 $3\times$)。
3.1 训练目标
记预测深度为 $D$(常见取值 1–4)。MTP 在每个位置 $i$ 上除主损失外附加 $D$ 个辅助损失,总训练目标为
\[\mathcal{L}_{\mathrm{MTP}} = \sum_{d=1}^{D} \lambda_d \, \mathcal{L}_{\mathrm{CE}}^{(d)}, \qquad \mathcal{L}_{\mathrm{CE}}^{(d)} = -\log p_\theta^{(d)}(x_{i+d} \mid x_{\le i}),\]其中 $\lambda_d$ 为各深度的损失权重($\lambda_1$ 对应主任务)。权重过大将干扰主目标收敛,过小则辅助头无法达到可用精度,实践中需对 ${\lambda_d}$ 做超参搜索。依据辅助头的条件化方式,实现分为两类:
- 并行独立头(Gloeckle et al., 2024):$D$ 个输出头共享主干、相互独立,各深度的监督信号同时稠密化,提升样本效率与表征质量;
- 顺序式 MTP(DeepSeek-AI, 2024):各深度预测保持完整因果链 $p_\theta^{(d)}(x_{i+d} \mid x_{\le i},\, \hat x_{i+1:i+d-1})$,深层预测以浅层预测为条件,草稿质量更高。DeepSeek-V3 采用 $D=1$ 的 MTP 模块(约 14B 额外参数)。
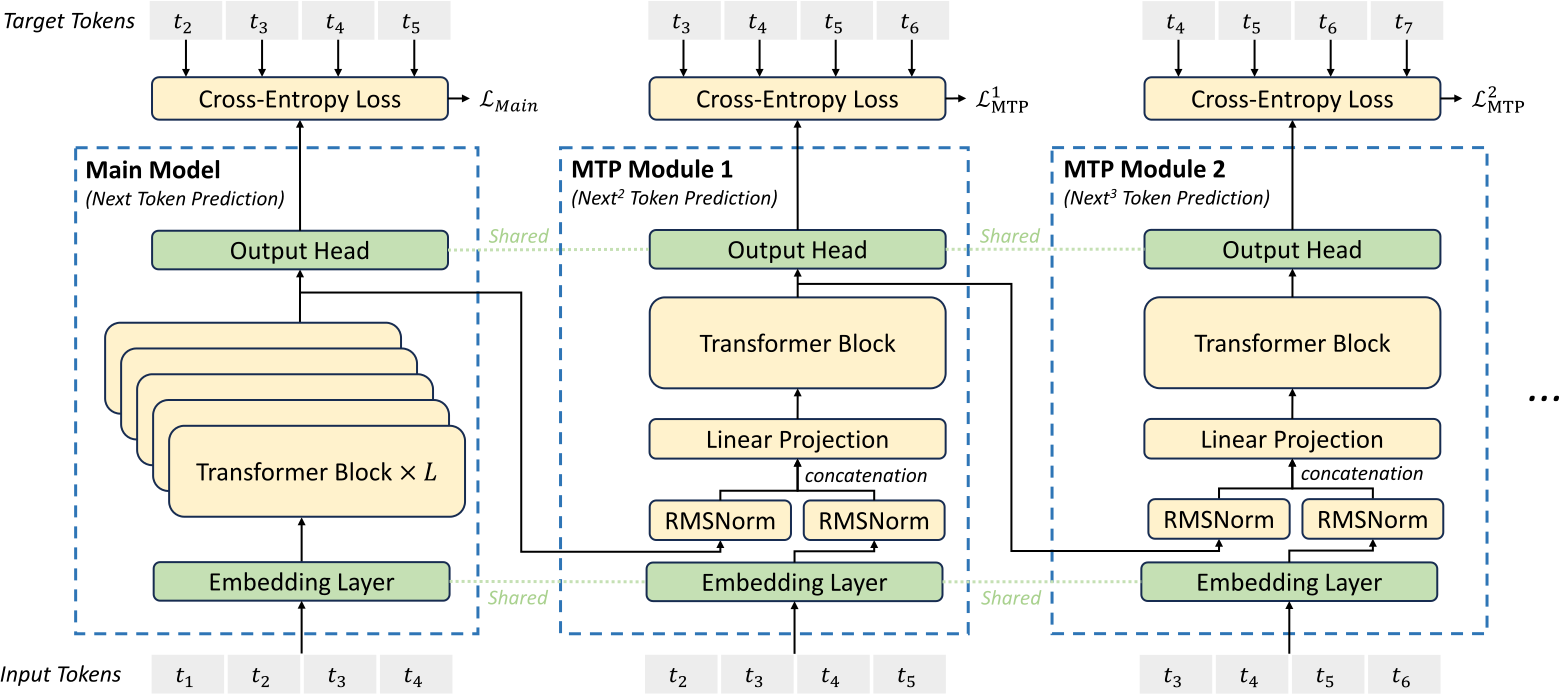 图 5:DeepSeek-V3 的顺序式 MTP 实现(DeepSeek-AI, 2024, Figure 3)。各深度的预测保持完整因果链,MTP 模块的输出即作为投机解码的草稿 token。
3.2 推理机制
推理阶段,MTP 模块以主干隐藏状态为输入生成草稿序列,后续流程与标准投机解码一致:草稿生成 $\rightarrow$ 目标模型单次前向并行验证 $\rightarrow$ 接受最长正确前缀,并在首个错误位置回退至主模型采样。由于草稿头与主模型联合训练,二者分布高度对齐,第二 token 的接受率可达 85%–90%。
3.3 实验结果与讨论
- 加速效果:DeepSeek-V3 报告吞吐约 $1.8\times$;在代码、结构化文本等低熵场景中接受率更高,加速比相应增大;
- 稠密监督效应:MTP 目标可视为对主任务的正则化与表征增强,通常带来约 0.5–1.5 个 benchmark 点的质量提升与更快的收敛速度;
- 无损性:输出分布由验证机制保证与主模型单独解码一致;
- 局限:MTP 头须在预训练阶段引入并联合训练,无法对既有 checkpoint 事后扩展(未训练的辅助头输出近似随机);推理引擎对自投机的支持仍在完善中(vLLM、SGLang、llama.cpp 等陆续支持)。
4 EAGLE
EAGLE(Extrapolation Algorithm for Greater Language-model Efficiency)是目前部署最广的无损投机解码方法家族之一。其核心假设为特征不确定性假设(feature-uncertainty hypothesis):设 $\mathbf{f}_t$ 为目标模型倒数第二层的隐藏特征,则特征序列 ${\mathbf{f}_t}$ 的条件演化较 token 序列更为平滑、更易被轻量模型拟合。据此,EAGLE 将草稿建模由 token 空间转移至特征空间,在特征层执行自回归外推。
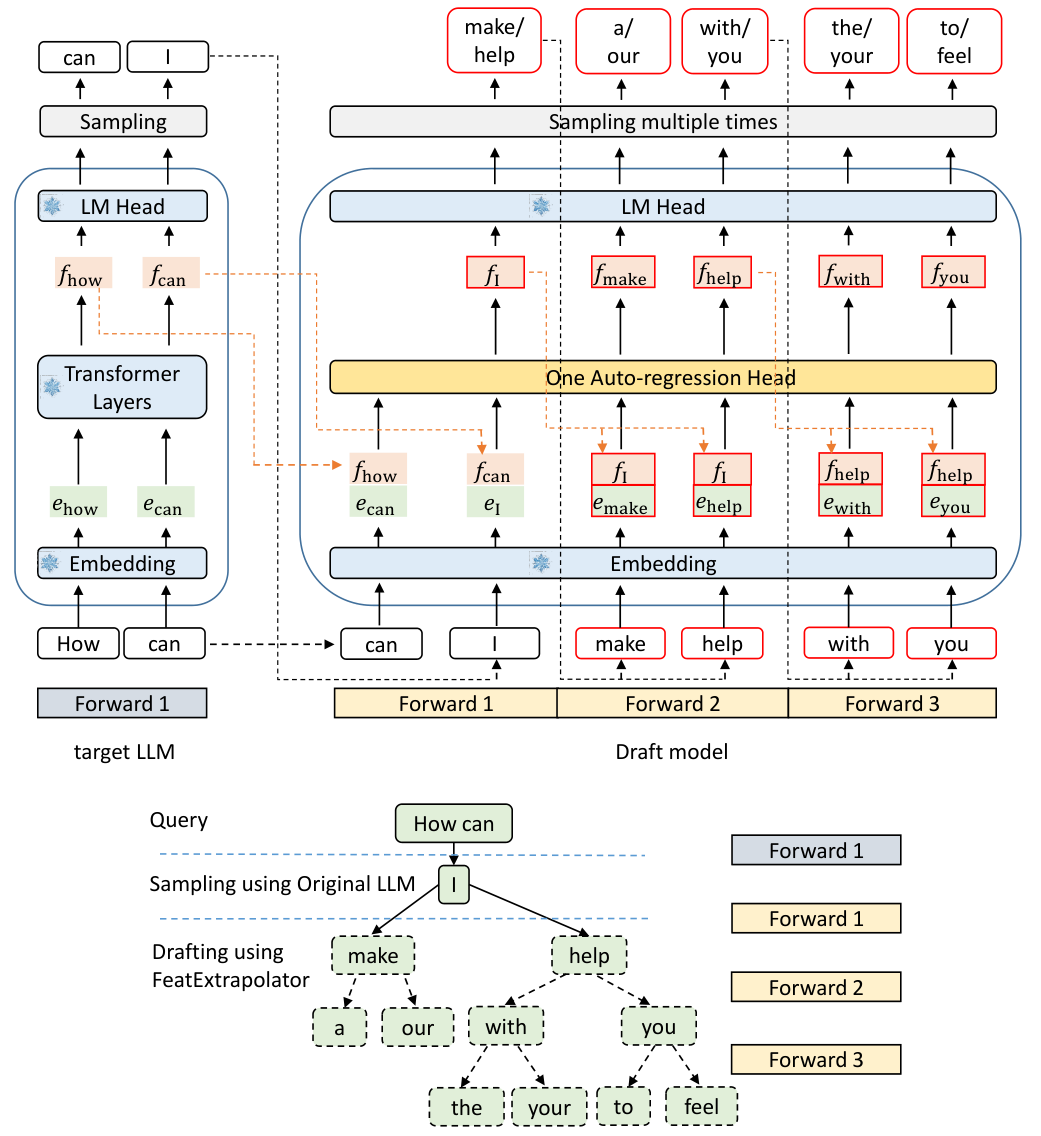 图 6:EAGLE 原始论文结构图(Li et al., 2024, Figure 6, Pipeline of EAGLE)。上半部分为计算流程:目标 LLM 前向得到特征 $f$ 与 token,草稿模型以”特征 + 移位 token embedding”为输入,经单一自回归头外推后续特征,再由共享 LM Head 采样候选 token;下半部分为对应的草稿树生成过程。
4.1 EAGLE-1:特征层自回归(ICML 2024)
架构。 草稿头由一个线性投影 $W_c$ 与一个 Transformer 解码层构成,且共享目标模型的 embedding 矩阵与 LM head,新增参数仅约占目标模型的 2%–5%(如 LLaMA-3.1-8B 约 0.24B)。单步外推的递推式为
\[\mathbf{h}_{t+1} = \mathrm{DecLayer}\big(W_c\,[\mathbf{f}_t\,;\,\mathbf{e}_{t+1}]\big), \qquad \hat{x}_{t+2} \sim \mathrm{softmax}\big(\mathrm{LMHead}(\mathbf{h}_{t+1})\big),\]其中 $\mathbf{e}_{t+1}$ 为已采样 token 的 embedding。拼接离散 token 信息以锚定预测,结合连续特征的平滑性以降低不确定性;滚动 $\gamma$ 步即得长度为 $\gamma$ 的草稿链。
训练。 冻结目标模型全部参数,仅训练草稿头,以目标模型的真实特征为回归目标。训练数据规模约数万条对话样本,单卡数小时即可完成。为缓解 exposure bias(训练时输入真实特征、推理时输入自身预测特征所导致的分布漂移),训练时对输入特征注入噪声。
验证。 采用标准拒绝采样,输出分布与目标模型严格一致。MT-bench 上约 $3\times$ 加速,曾居 Spec-Bench 无损方法首位。
4.2 EAGLE-2:动态草稿树(EMNLP 2024)
将静态草稿树替换为动态草稿树:节点权重取根至该节点路径上草稿置信度之积,作为整段前缀被接受概率的估计;每步仅扩展权重最高的叶节点,并对展开结果重排(expand & rerank)。相对 EAGLE-1 提速 20%–40%。
4.3 EAGLE-3:训练时测试(NeurIPS 2025)
放弃显式特征回归,改为直接预测 token,并以三层特征融合(tri-layer feature fusion)聚合目标模型多层表示;引入训练时测试(Training-Time Test, TTT):训练阶段即令草稿头自由滚动生成、以最终接受长度为优化目标,从根源上消除 exposure bias。加速比达 $3\times$–$6.5\times$,约为 EAGLE-2 的 $1.4$ 倍。该系列已集成于 vLLM、SGLang、TensorRT-LLM 等推理框架;Google Vertex AI 报告在 Llama 70B 上取得 $2$–$3\times$ 的生产环境加速。
5 DFlash
DFlash(Block Diffusion for Flash Speculative Decoding, ICML 2026, UCSD Z Lab, arXiv:2602.06036)以块扩散(block diffusion)模型替换自回归草稿器,使草稿生成由”逐 token 串行”转变为”整块并行去噪”,解除了草稿深度 $k$ 与草稿耗时 $t_d$ 之间的线性耦合。
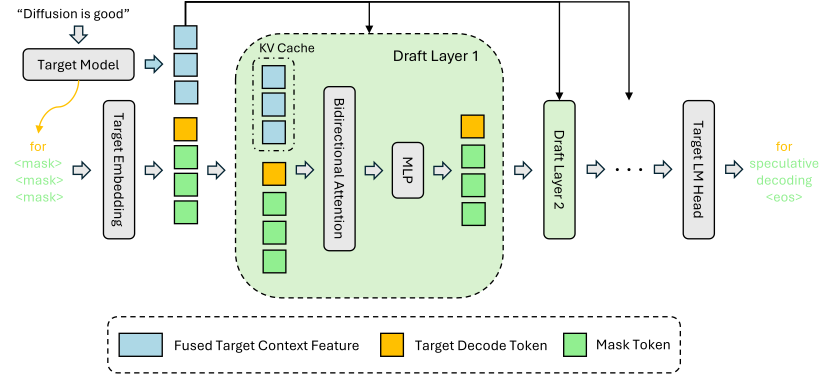 图 7:DFlash 原始论文结构图(Chen et al., 2026, Figure 2, DFlash Inference Design)。轻量块扩散草稿器以全 [MASK] 块为起点,单次前向联合去噪出整块候选 token;目标模型抽取的隐藏上下文特征经融合后注入草稿器各层的 KV cache(KV Injection),无需重新编码上下文即可维持高接受率。
5.1 动机
自回归草稿器(MTP、EAGLE)的草稿成本随 $k$ 线性增长($t_d = O(k)$),迫使草稿深度受限;完全并行的多头草稿(如 Medusa)虽使 $t_d = O(1)$,但各位置预测相互独立、缺乏块内依赖建模,接受率随位置迅速衰减(后缀衰减,suffix decay)。DFlash 的设计目标是:在保持 $t_d$ 对 $k$ 近似不敏感的同时,生成高质量的长草稿。
5.2 方法
- 块扩散草稿(Block-diffusion drafting):以长度 $k$ 的全 [MASK] 序列为起点,草稿器在单次前向中联合去噪全部 $k$ 个位置。草稿 token 数与草稿前向次数解耦,$t_d$ 随 $k$ 近似不变;
- 目标特征条件化(Target hidden-state conditioning):草稿器以目标模型抽取的上下文隐藏特征为条件,继承目标模型对上下文的表征;
- KV 注入(KV Injection):将目标模型的隐藏表示直接写入草稿模型各层的 key–value 缓存,草稿器无需重新编码上下文即可利用目标模型的特征,同时维持高接受率。
验证阶段仍由目标模型执行,输出分布严格不变(无损)。
5.3 实验结果
- 多模型多任务上取得 $5$–$6\times$ 无损加速;经 DDTree 优化后 HumanEval 上最高 $8.22\times$;较同期最优的自回归方法 EAGLE-3 最高提升 $2.5\times$;
- NVIDIA Blackwell Ultra 上 gpt-oss-120b 在同等交互性约束下吞吐最高 $15\times$;对 Llama 3.1 8B 的交互性接近 EAGLE-3 的 $2$ 倍;
- 接受长度随草稿预算 $k$ 增大而持续增长,而 MTP 类草稿在预算超过 8 后趋于饱和;
- 与权重量化正交、可叠加:目标模型 mxfp4 量化降低验证开销且不损害接受率,可再获得 10%–20% 的吞吐增益;
- 已集成于 SGLang、vLLM、TensorRT-LLM、MLX;官方发布 20 个 DFlash checkpoint(覆盖 Qwen、Kimi K2.6、Llama、Gemma、gpt-oss 等模型族)。
6 DSpark
DSpark(Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation, arXiv:2607.05147)由 DeepSeek 与北京大学联合提出(2026 年 6 月),面向高并发生产服务场景,统一优化草稿质量与验证效率。该框架已部署于 DeepSeek-V4 在线服务系统(V4-Pro / V4-Flash)。
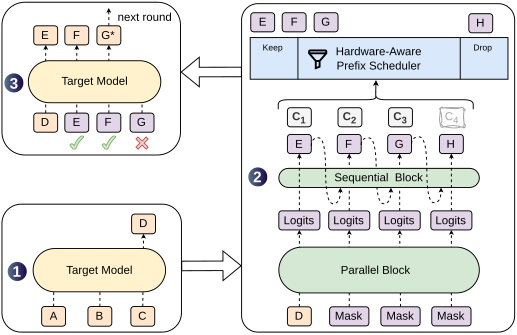 图 8:DSpark 原始论文结构图(Cheng et al., 2026, Figure 1, DSpark architecture and decoding cycle)。给定 prompt token ABC,目标模型先生成锚点 token D;半自回归草稿器(并行主干 + 轻量串行模块)并行产出候选块,置信度头估计各位置前缀生存概率并裁剪低置信后缀,最终由目标模型单次前向验证。
6.1 方法
- 半自回归草稿器(Semi-Autoregressive Generation):并行主干在单次前向中产出整块候选,再由轻量串行模块(Markov 头)按位置顺序条件化重写,以近似自回归的精度建模块内依赖。设位置 $i$ 的条件接受率为 $a_i$,该结构显著缓解后缀衰减,使平均接受长度 $\mathbb{E}[\tau]$ 全面优于纯自回归与纯并行草稿基线;
- 置信度调度验证(Confidence-Scheduled Verification):置信度头估计各位置的前缀生存概率 $s_i = \prod_{j \le i} \hat{a}_j$;低于阈值的低置信后缀在验证前即被裁剪,回退至更短的草稿。结合推理引擎的吞吐特性曲线,为每条请求动态确定验证长度 $k^*$,将验证预算集中于期望收益最高的候选位置,避免批处理容量被高拒绝风险的 token 占用;
- 硬件感知调度(Hardware-Aware Scheduling):调度器依据实时 GPU 负载自适应草稿长度——低负载时延长草稿以利用空闲带宽,高负载时缩短草稿以降低验证浪费,使系统在严格交互性约束下维持高吞吐,整体外移服务的 Pareto 前沿。
6.2 实验结果与生态
- 线上部署效果:DeepSeek-V4 真实用户流量下,同吞吐水平相比 MTP-1 生产基线,单用户生成速度提升 60%–85%(V4-Flash)与 57%–78%(V4-Pro);在 120 tok/s 的延迟地板下总吞吐最高约 $6.6\times$;
- 无损性:拒绝采样保证输出与目标模型严格一致;目标模型参数不更新,仅训练草稿头;
- 开源生态:DSpark 与配套训练评测库 DeepSpec 以 MIT 协议开源;官方发布面向 Qwen、Gemma 等模型的草稿 checkpoint,训练配方公开,可为任意目标模型训练草稿器;
- 2026 年 8 月,Liquid AI 与 Hugging Face 发布了基于 DSpark 的 LFM2.5 系列草稿 checkpoint。
7 参考文献
- Leviathan Y, Kalman M, Matias Y. Fast Inference from Transformers via Speculative Decoding. ICML 2023. arXiv:2211.17192.
- Chen C, et al. Accelerating Large Language Model Decoding with Speculative Sampling. DeepMind, 2023. arXiv:2302.01318.
- Cai T, et al. Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads. ICML 2024. arXiv:2401.10774.
- Miao X, et al. SpecInfer: Accelerating Generative Large Language Model Serving with Tree-based Speculative Inference and Verification. OSDI 2024. arXiv:2305.09781.
- Gloeckle F, et al. Better & Faster Large Language Models via Multi-token Prediction. NeurIPS 2024. arXiv:2404.19737.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024. arXiv:2412.19437.
- Li Y, Wei F, Zhang C, Zhang H. EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty. ICML 2024. arXiv:2401.15077.
- Li Y, et al. EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees. EMNLP 2024. arXiv:2406.16858.
- Li Y, et al. EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test. NeurIPS 2025. arXiv:2503.01840.
- Chen J, Liang Y, Liu Z. DFlash: Block Diffusion for Flash Speculative Decoding. ICML 2026. arXiv:2602.06036.
- Cheng X, et al. DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation. DeepSeek & Peking University, 2026. arXiv:2607.05147.