
Maia | 软件定义数据流的推理引擎
前言
“问渠那得清如许?为有源头活水来。”
推理已经成为AI计算的主战场,而推理的经济性——每瓦特产出多少有效token,每美元产出多少智能——正在决定AI能否真正普惠。在这场竞赛中,GPU长期扮演万能瑞士军刀的角色。但万能往往意味着低效:线程中心的编程模型、隐式的缓存行为、把控制与数据混为一谈的调度机制,在面对LLM推理这种数据搬移远比计算吃紧的负载时,暴露出越来越多的结构性问题。
微软选择了一条不同的路。从第一代Maia开始,就坚持一个朴素而激进的哲学:把数据搬移而非线程调度,作为架构设计的核心原点。算力如渠,数据如水:计算单元能跑出多高的利用率,取决于数据能否像活水一样源源不断地流到手边;Maia芯片从根基上重新定义加速器的编程范式。三代Maia——100、200、300——便是这一哲学的三个递进式里程碑。
概述
微软Maia是一个多代际AI加速器项目,为云规模大模型推理提供从软件到芯片、从机架到数据中心的端到端协同设计。其核心创新是软件定义局部访问数据流架构SDLA(Software Defined Locally Accessed Dataflow Architecture):把控制路径编程与数据路径执行显式分离,让软件而非硬件主导数据的放置、搬移、转换与同步。
- Maia 100于2023年11月发布,Hot Chips 2024首次公开细节,是微软第一代自研AI加速器,也是首个把”软件管理暂存内存+硬件信号量+双编程模型”工程化落地的产品。
- Maia 200于2026年1月发布,是SDLA的开山之作,第一次把前代散落的设计直觉收敛为完整的理论分类法与指令集形式化,并工程化为Tile→Cluster→SoC→6,144芯片集群的完整体系。
- Maia 300于2026年10月发布,是SDLA哲学的全面进化:单体裸片转向多芯粒,内存组织从UMA演进为NUMA,芯片互联从6,144增至12,288颗加速器,引入增强MXFP4与3比特存储格式;相比Maia 200,机架级token吞吐提升7倍,每瓦性能提升2.5倍以上。
下图展示了微软官方给出的两代规格对比与Maia 300封装剖面:
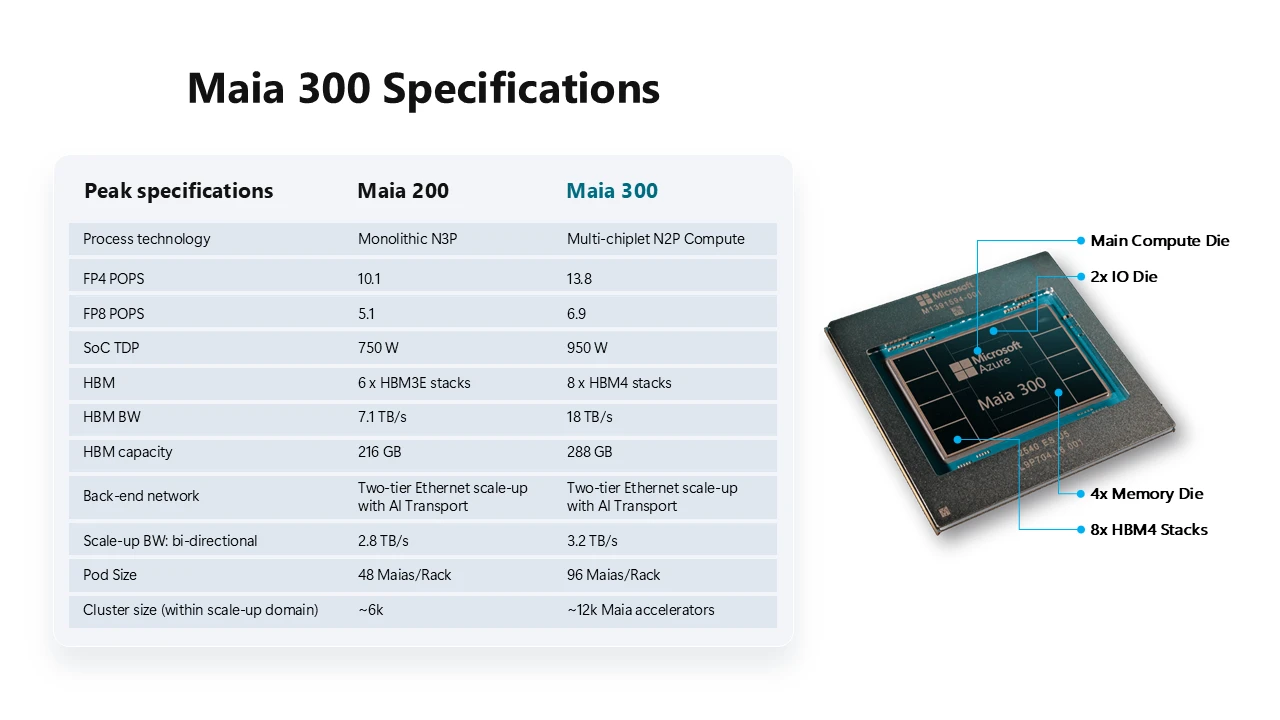
表1汇总了三代Maia的芯片级峰值规格。
- Maia 300单芯片FP4算力(13.8 POPS)相比Maia 200(10.1 POPS)仅提升约36%,HBM带宽却提升2.5倍,容量提升33%——性能重心显然不在”算得更快”,而在”喂得更足”。
表1 三代Maia芯片级峰值规格对比
| 峰值规格 | Maia 100 | Maia 200 | Maia 300 |
|---|---|---|---|
| 制程技术 | 单体裸片N5 | 单体裸片N3P | 多芯粒N2P计算 |
| 芯片面积 | ~820mm²(光罩尺寸裸片) | 近光罩尺寸单体裸片~26×33mm | 多芯粒封装 |
| 封装 | TSMC CoWoS-S | CoWoS-S(~75×75mm封装) | 多芯粒+8×HBM4堆栈 |
| FP4算力 | 未公开 | 10.1 POPS | 13.8 POPS |
| FP8算力 | 未公开 | 5.1 POPS | 6.9 POPS |
| 6比特算力 | 3 POPS | — | — |
| 9比特算力 | 1.5 POPS | — | — |
| BF16算力 | 0.8 POPS | — | — |
| SoC TDP | 700W设计/500W部署 | 750W | 950W |
| HBM | 4×HBM2E | 6×HBM3E | 8×HBM4 |
| HBM带宽 | 1.8 TB/s | 7.1 TB/s | 18 TB/s |
| HBM容量 | 64 GB | 216 GB | 288 GB |
| 片上SRAM | ~500 MB(L1/L2) | 272 MB(CSRAM 35MB/Cluster + TSRAM 3MB/Tile) | 未公开 |
| Tile/Cluster组织 | 4 Tile/Cluster×16 Cluster | 10 Tile/Cluster×4 Cluster | 12 Tile/Cluster×4 Cluster |
| 后端网络 | 以太网600GB/s(12×400GbE) | 两层以太网+AI Transport | 两层以太网+AI Transport |
| Scale-up带宽 | 4800Gbps all-gather/1200Gbps any-to-any | 2.8 TB/s(双向) | 3.2 TB/s(双向) |
| 主机接口 | PCIe Gen5 x8(32GB/s) | — | PCIe Gen6 x16(128GB/s) |
| Pod规模 | — | 48 Maia/机架 | 96 Maia/机架 |
| 集群规模(scale-up域) | — | ~6k加速器 | ~12k加速器 |
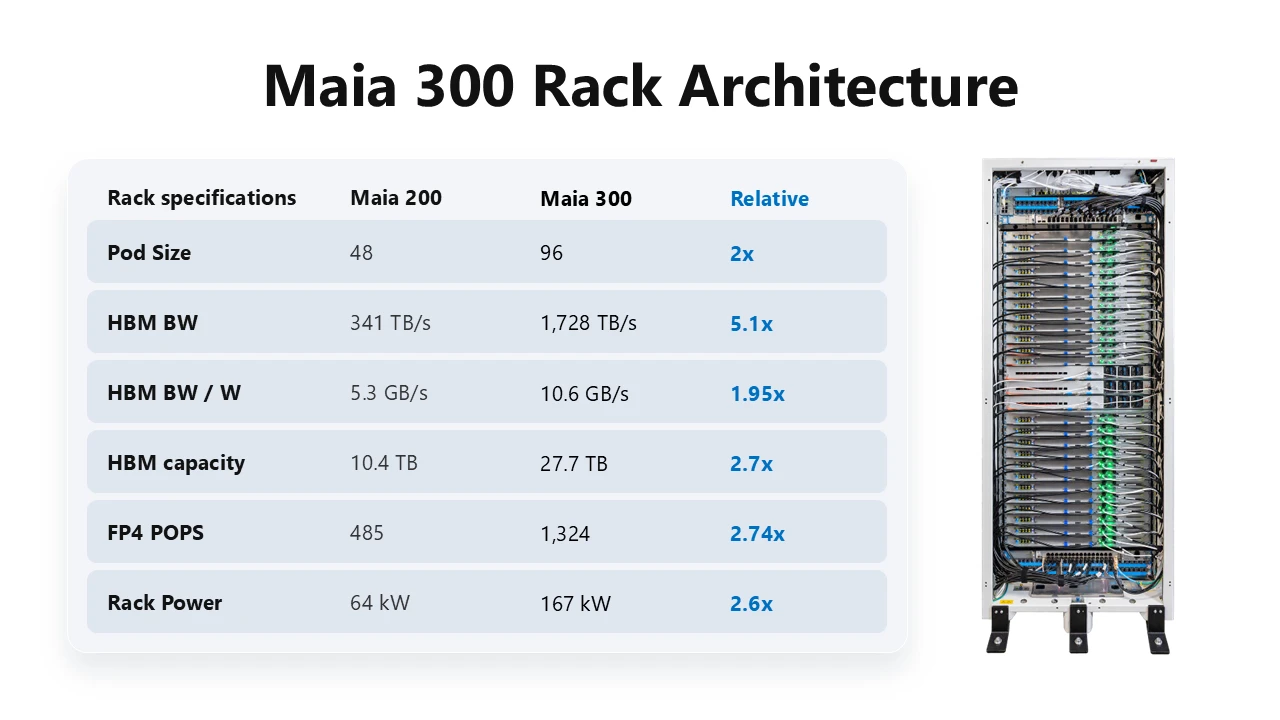
把视角从单芯片转移到机架,Maia 200到Maia 300的进步更加直观。表2是官方给出的机架级对比:HBM带宽提升5.1倍、容量提升2.7倍、FP4算力提升2.74倍,而机架功耗仅增加2.6倍——这正是”每瓦token产出”提升的物理来源。
表2 Maia 200与Maia 300机架级规格对比
| 机架规格 | Maia 200 | Maia 300 | 相对 |
|---|---|---|---|
| Pod规模 | 48 | 96 | 2× |
| HBM带宽 | 341 TB/s | 1,728 TB/s | 5.1× |
| HBM带宽/瓦 | 5.3 GB/s | 10.6 GB/s | 1.95× |
| HBM容量 | 10.4 TB | 27.7 TB | 2.7× |
| FP4算力 | 485 POPS | 1,324 POPS | 2.74× |
| 机架功耗 | 64 kW | 167 kW | 2.6× |
三代Maia的架构哲学一以贯之,实现层面却有清晰的演进脉络。
- Maia 100是思想源头,已经写下SDLA的全部关键词——把数据搬移当作推理公认瓶颈、用软件管理的大容量暂存内存取代硬件缓存、用硬件信号量驱动异步编程、用控制处理器向队列发命令、用gather-based GEMM把网络纳入数据流;但没有给这套做法命名,也没有形式化理论基础* Maia 200正式确立SDLA架构哲学,定义为可推理、可教学、可编程的体系——以数据管理为中心的分类法、DISA数据流指令集、SoC/Cluster/Tile三级控制、scratchpad取代cache的严谨论证,并用BF16峰值利用率99.69%、30% TCO节省的数字证明软件定义数据流并非纸上谈兵。
- Maia 300是SDLA的性能递增,不推翻任何基础,把每一层推到新极限——多芯粒、NUMA、HBM4、12,288加速器superpod、动态带宽分配;7倍token吞吐与2.5倍性能/瓦的提升不靠堆功耗与面积,而靠围绕数据搬移、局部性、精度与内存效率的架构创新。
回顾三代,可以梳理出一条设计哲学的脉络:
- 数据搬移优先 从”把数据搬移当作公认瓶颈”到SDLA分类法与DISA指令集,从scratchpad取代cache到NUMA跨芯粒局部访问,每一步都在减少数据搬移的距离、功耗与字节数。
- 精度压缩 Maia 100首度量产MX格式并支持4/6/9比特;Maia 200给出FP4=2×FP8=8×BF16的吞吐比;Maia 300引入增强MXFP4与亚3比特存储格式。更窄的表示持续压缩每token的字节开销。
- 网络即执行引擎 Maia 100让网络读写直接由SRAM服务;Maia 200把6,144加速器接成两层拓扑并让ATL协议进入SDLA微架构;Maia 300成为12,288加速器superpod的统一fabric。
- 系统协同设计 从芯片到机架到数据中心,功耗、散热、网络、软件协同优化。Maia 300的50V母线、液冷80%热移除、动态功耗分配算法都是这一哲学的体现,而Maia 100早已把液冷使能列为第一代的设计约束。
- 确定性编程 消除隐式缓存行为,让性能可预测、可规划、可复现。
Maia的故事,本质上是一个关于数据主权的故事:谁拥有数据的放置权、搬移权、转换权,谁就拥有加速器的效率上限。GPU把这些权力交给硬件缓存控制器,Maia把它们交给软件。当然,代价是增加了编程复杂度,但在编译器与运行时足够成熟时——正如Maia SDK的分层抽象所承诺的——软件拥有的主权越多,架构能榨取的效率越高。
Maia 100
发展背景
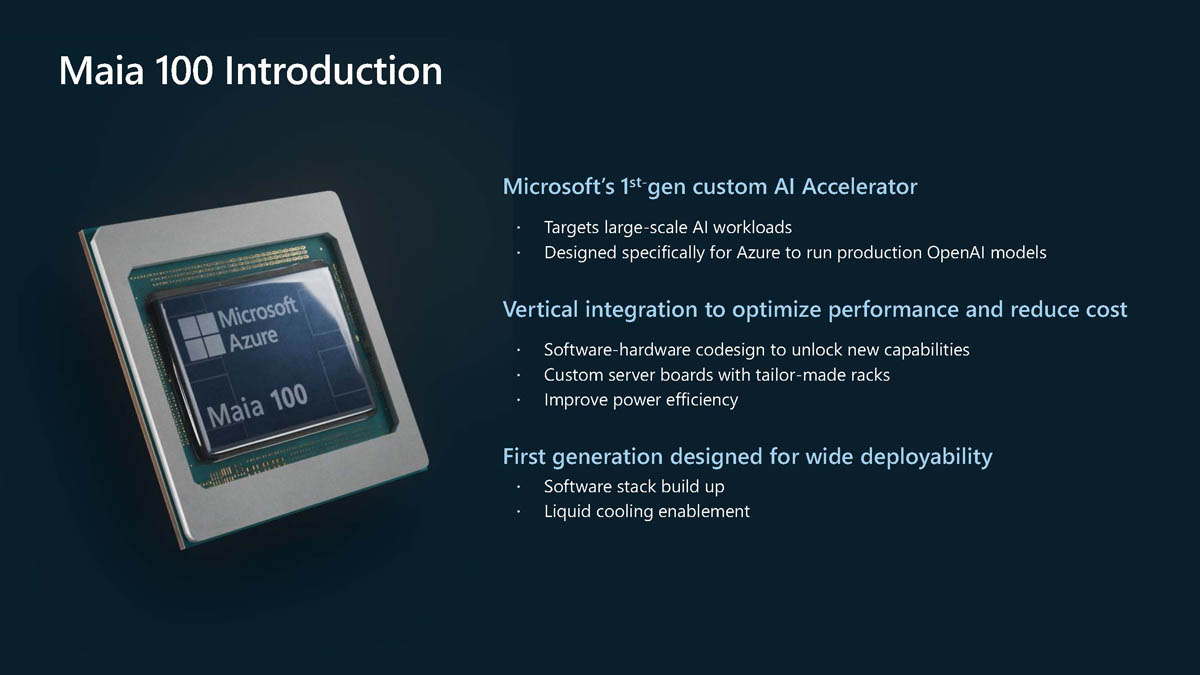
2023年11月,微软在Ignite大会上首次公开自研AI加速器Maia 100。Maia 100是面向大规模AI工作负载,专为在Azure上运行生产环境的OpenAI模型而设计。设计目标可以归为三类:
- 垂直整合以优化性能与成本,包括软硬件协同设计、定制服务器板与量身定制的机架;
- 第一代就要广泛部署,先把软件栈建起来、先把液冷支持打通;
- 把成本作为一等目标——从HBM2E的选择上看得最清楚,微软刻意避开与NVIDIA、AMD争抢最紧俏的HBM产能,转而使用供应链成熟、成本可控的方案。
Maia 100由Sherry Xu(Partner Lead SoC Architect)与Chandru Ramakrishnan(Partner SW Eng Manager)在Hot Chips 2024上首次详细披露。一位SoC架构师、一位软件工程经理,这个组合本身说明Maia从第一代起就是芯片与软件并重的项目。
芯片规格
Maia 100采用台积电N5工艺,面积约820mm²,采用CoWoS-S 2.5D硅中介层封装;4个HBM2E共64GB容量、1.8TB/s带宽;L1/L2合计约500MB片上SRAM;峰值密集张量算力6bit 3 POPS、9bit 1.5 POPS、BF16 0.8 POPS;后端网络带宽600GB/s,由12条400GbE链路构成;主机接口PCIe Gen5 x8、32GB/s;设计TDP 700W,生产部署500W。
下图展示了Maia 100官方规格与承载它的液冷机架:
SoC架构
Maia 100采用Tile→Cluster→SoC三级组织,共16个Cluster、每Cluster 4个Tile,合计64个Tile。
下图展示了Maia 100 SoC架构,左侧为SoC全景,右侧为单个Tile的内部组成:
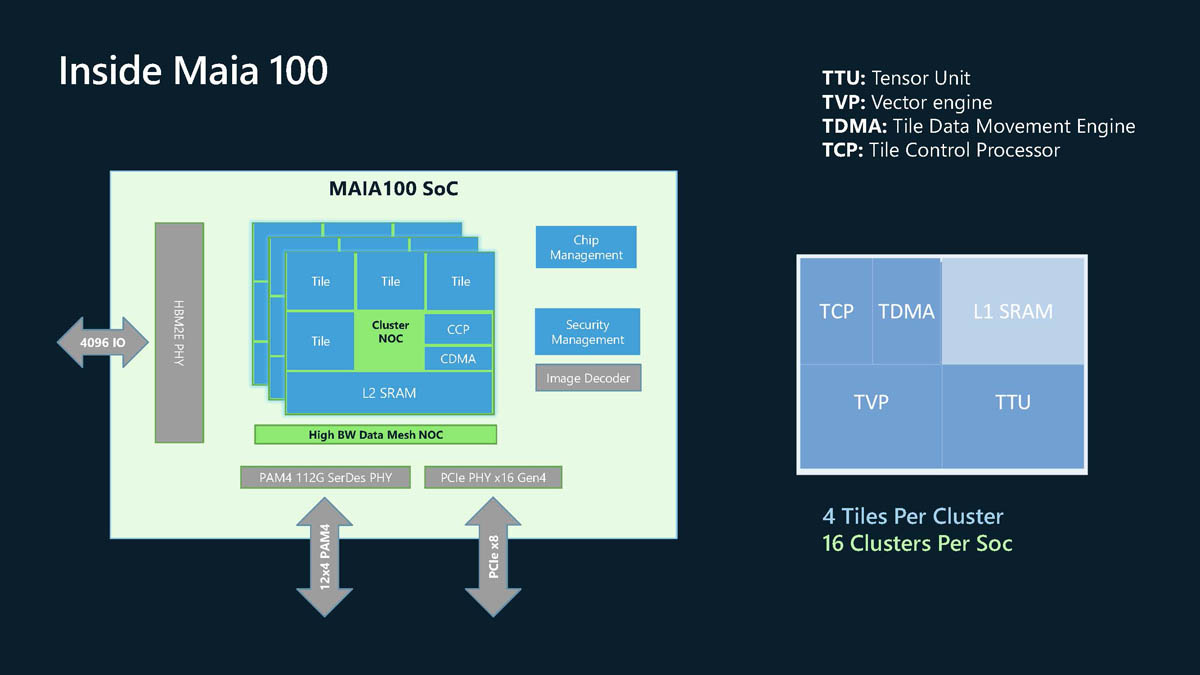
- Tile 是最小自主计算单元,集成TTU张量单元(Tensor Unit)、TVP向量引擎(Vector engine)、TDMA数据搬移引擎(Tile Data Movement Engine)、TCP控制处理器(Tile Control Processor)、L1 SRAM与读写拷贝引擎。
- Cluster 包含4个Tile,提供CCP集群控制处理器、CDMA集群数据搬移引擎、CSRAM(L2 SRAM)与Cluster NoC。
- SoC 顶层包含High BW Data Mesh NOC连接全部Cluster、HBM2E PHY(4096 IO)、PAM4 112G SerDes PHY(对外12×400 PAM4)、PCIe PHY x16 Gen4(对外PCIe x8)、Chip Management与Security Management两个管理域,以及一个Image Decoder图像解码模块。
Fabric被显式拆成Data/MSG/CFG三类通道——”控制路径与数据路径分离”。
计算引擎
张量单元TTU支持宽数据类型,重点是MX格式,支持6比特与9比特计算。”9比特”对应MX家族中MXINT8加缩放因子等变体,”6比特”则是更激进的窄格式,两者的组合让Maia 100在精度—吞吐曲线上有了比同时代FP16/FP8更细的刻度。TTU构造为16×R×16单元:外层16×16是固定的输入输出粒度,中间的收缩维度R是可配置参数。中间维度R可配置是粒度损失与峰值性能之间的权衡:R越大,矩阵乘的算术强度越高、越接近峰值,但对小矩阵形状的适配性越差;R越小则相反。
向量处理器TVP是松耦合超标量引擎,自定义ISA,原生支持FP32与BF16;松耦合意味着它可以相对独立地推进自己的指令流,与TTU并行工作——TTU出结果的同时,TVP已经在做归一化或激活。
下图展示了Maia 100的ML专用架构要点:
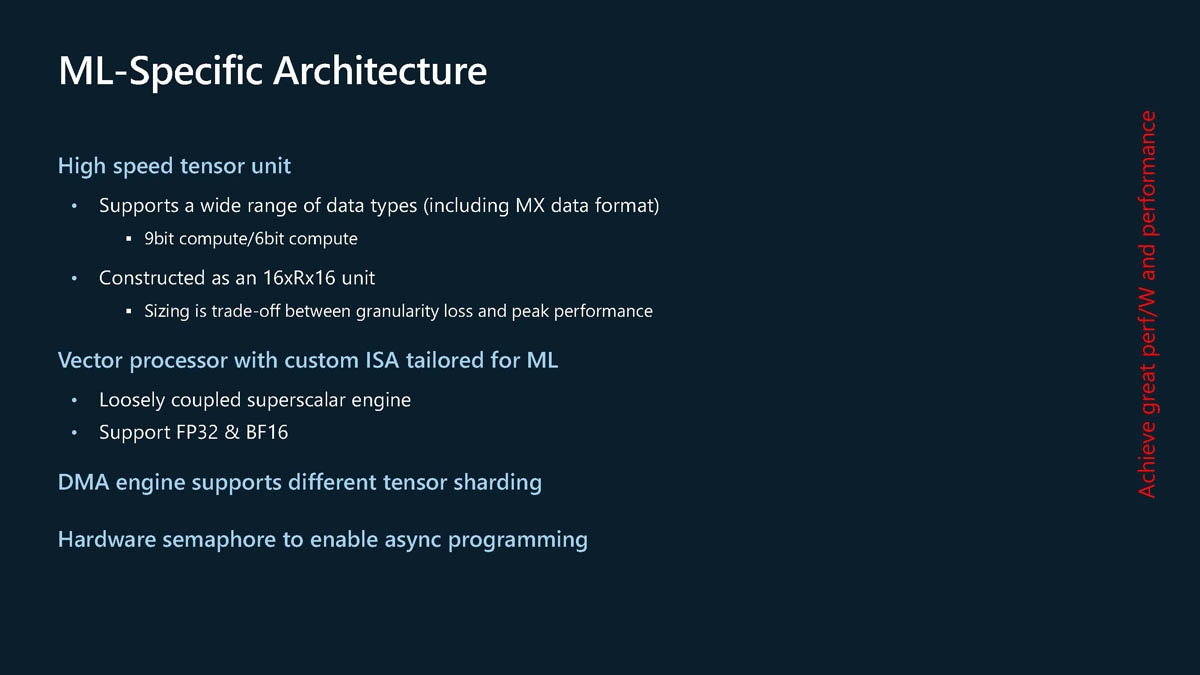
TDMA支持不同的张量分片方案,分片策略由软件而非硬件决定;硬件信号量使能异步编程,后者是整个编程模型的基石,编程模型一节再展开。
存储结构
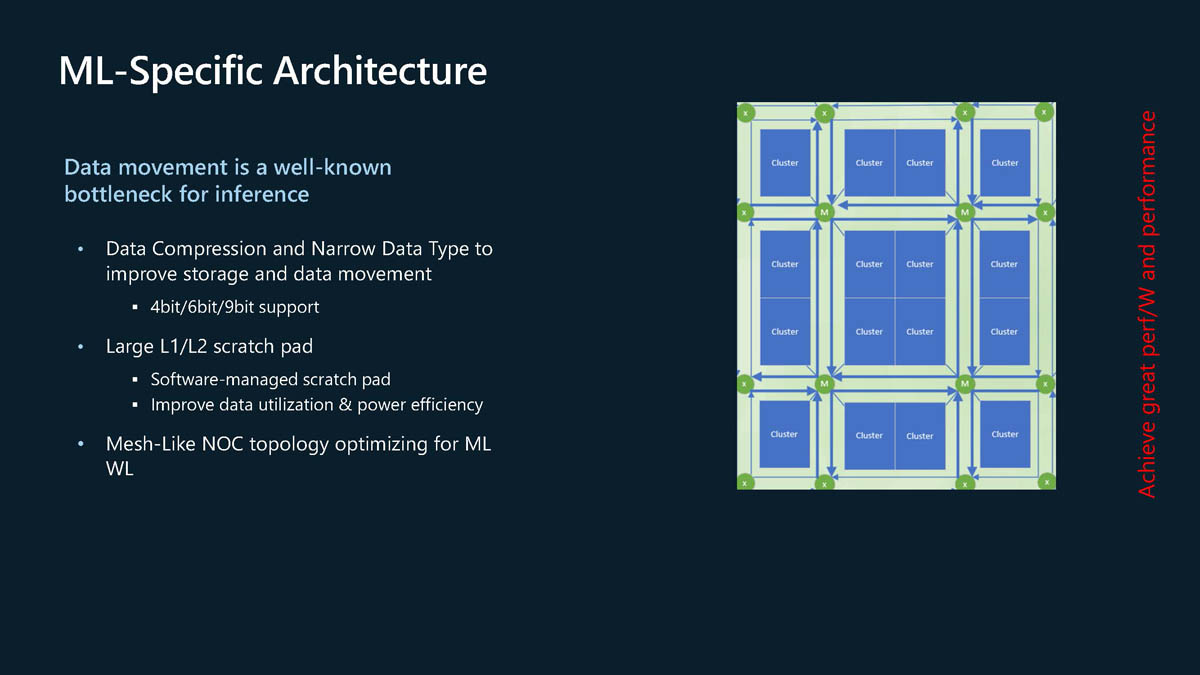
数据搬移是推理公认的瓶颈。围绕这个判断,Maia 100采取三项对策。
- 一是数据压缩引擎加窄数据类型,支持4/6/9比特存储,用更少的比特承载同样的信息量,直接减少需要搬移的字节数。
- 二是大容量L1/L2暂存内存且由软件管理,”Software-managed scratch pad, improve data utilization & power efficiency”。
- 三是Mesh NoC拓扑为ML负载优化,16个Cluster以网格方式互联,路由节点分布在网格交叉点上,为规整的矩阵乘数据流提供高带宽、可预测的片上通路。
下图展示了Maia 100的数据搬移策略与Mesh NoC拓扑:
网络互连
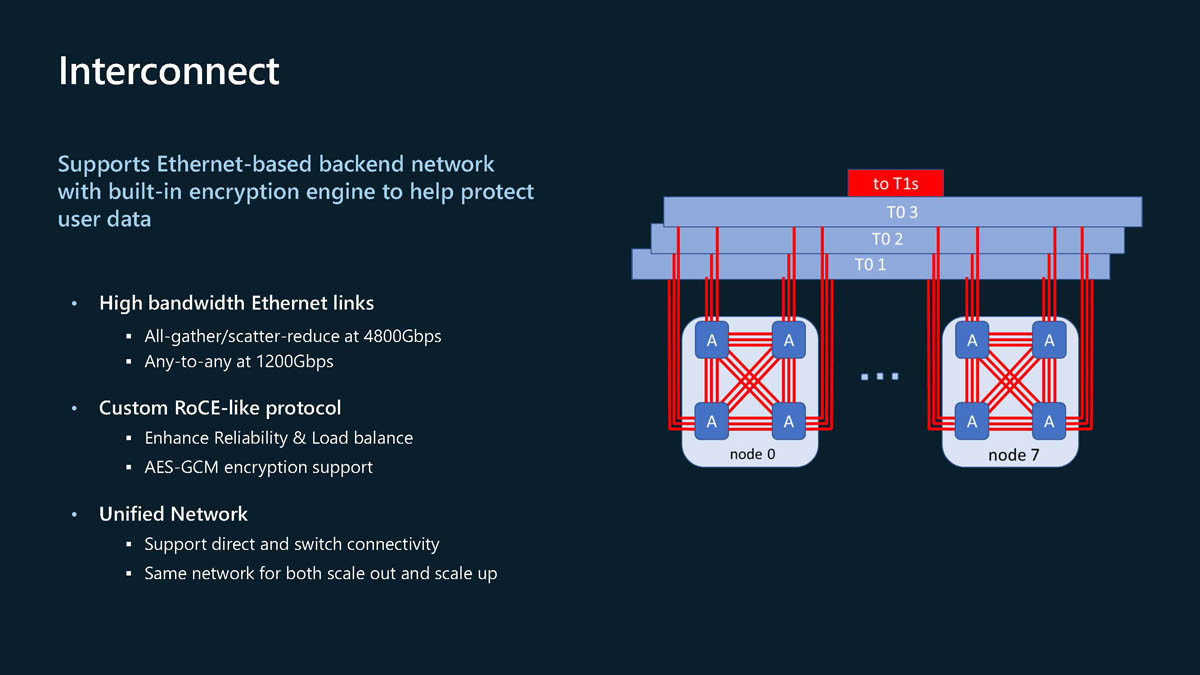
Maia 100的互联网络选择以太网,不用InfiniBand,也不用自研私有fabric。高带宽以太网链路,提供4800Gbps all-gather/scatter-reduce性能,any-to-any达1200Gbps;定制RoCE-like协议,增强可靠性与负载均衡,支持AES-GCM加密——后端网络上的数据在传输层就是加密的,整机因此适合机密计算场景;统一网络同时承担scale-out与scale-up,并同时支持直连与交换两种连接方式;内置加密引擎保护用户数据。
下图展示了Maia 100的互连架构,右侧每个node内4颗加速器以直连链路两两全连接,node间经三层交换机互联:
这一步与微软2023年主导发起Ultra Ethernet Consortium(UEC)是同一套动作的两面:一边在标准组织里定义”AI时代的以太网”,一边在自家芯片上先把AI以太网做出来。
编程模型
Maia 100的软件栈定义了三代Maia共用的全部编程语义——后来的NEPAL、DISA、AI辅助内核优化,都是在这个框架上做加法。这一节也因此是理解Maia系列的关键。
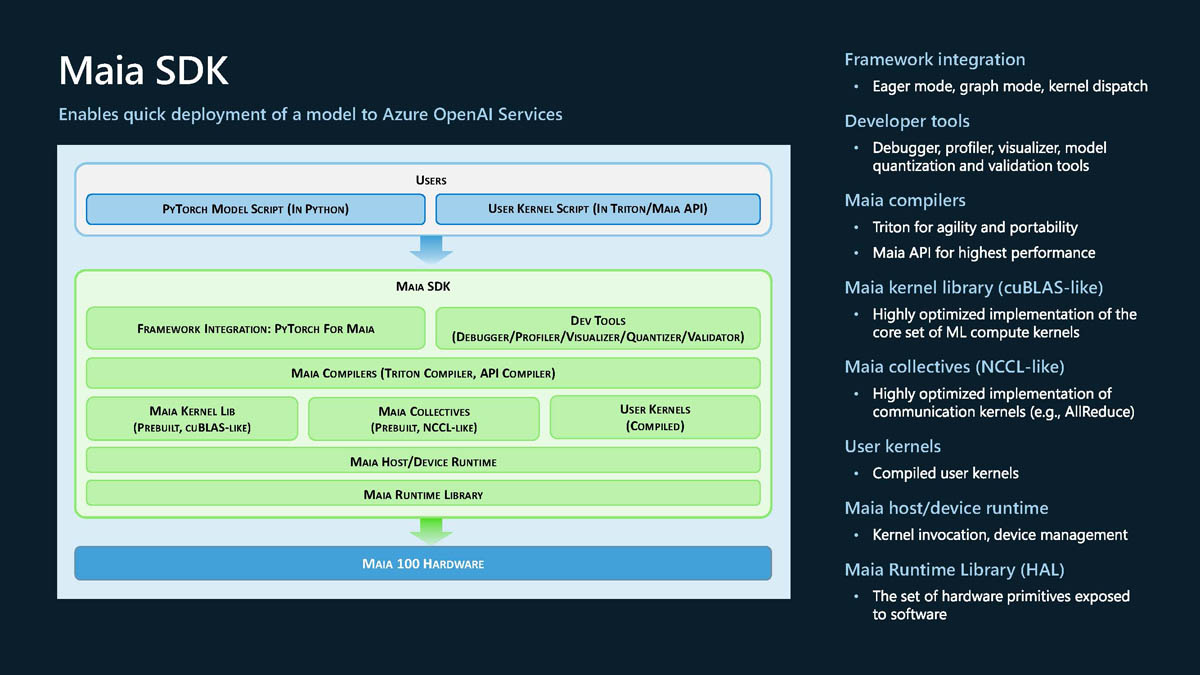
SDK分层。Maia SDK的目标是让模型快速部署到Azure OpenAI Services。自上而下分为:
- 框架集成 PyTorch for Maia,支持eager模式、graph模式与内核派发。
- 开发者工具 Debugger、Profiler、Visualizer、模型量化与验证工具。
- 编译器 Triton Compiler与API Compiler,两套编程模型各配一个。
- Maia Kernel Lib cuBLAS类,核心ML计算内核的高度优化实现。
- Maia Collectives NCCL类,通信内核(如AllReduce)的高度优化实现。
- User Kernels 编译后的用户自研内核。
- Maia Host/Device Runtime 负责内核调用与设备管理。
- Maia Runtime Library 即HAL,暴露给软件的硬件原语集合。
下图展示了Maia SDK的分层架构:
“cuBLAS类+NCCL类”的并列说明微软对标的不是一个编译器,而是CUDA生态的库深度。
异步编程。Maia编程模型最核心的机制可以概括为一句话:控制处理器把异步命令发到队列,硬件线程在数据路径上执行这些命令,命令之间的依赖由硬件信号量强制保证。一条命令的结构是Command({in semaphores}, arguments, {out semaphores}),语义有四条:命令执行前等待in信号量,等输入数据就绪、输出缓冲可用;执行后发出out信号量,通知输出数据就绪、输入缓冲可复用;控制处理器在控制路径上发出命令;执行命令的线程在数据路径上直接同步。系统因此有两条执行流——控制处理器与硬件线程——二者通过信号量同步,效果是计算可以与内存搬移、网络传输重叠进行。
下图展示了Maia 100的异步编程模型,上为Cluster级控制流,下为Tile级控制流:
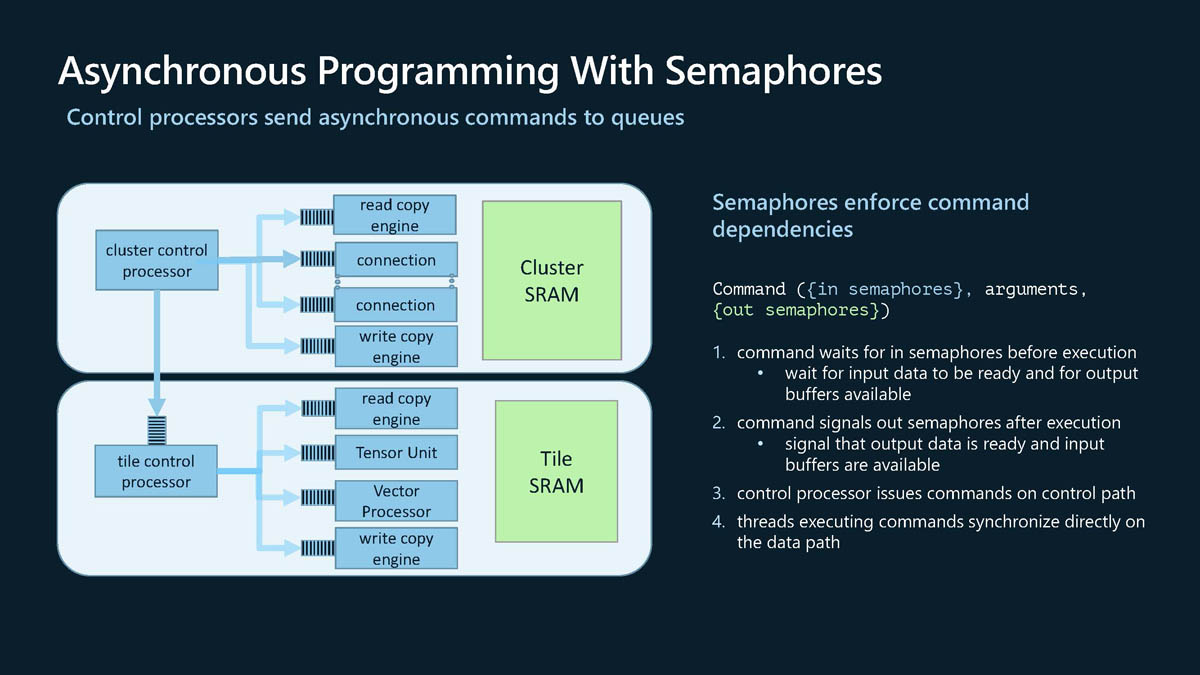
第三条与第四条的分离是设计精髓:控制处理器跑在控制路径上只管编排,真正干活的是数据路径上的硬件引擎(拷贝引擎、张量单元、向量处理器),它们各自盯住自己的in/out信号量,彼此之间不需要软件协调——依赖关系由硬件信号量直接握手,而不是靠CPU反复轮询。层级上,Cluster级控制处理器编排跨Tile的数据搬移,Tile级控制处理器编排Tile内部的计算与局部搬移;每一级都有自己的引擎、自己的SRAM、自己的控制处理器。这个结构与Maia 200的”SoC/Cluster/Tile三级控制”完全同构。
两种编程模型。Maia 100提供两层编程抽象,取舍极其清晰。Triton是开源DSL,硬件无关、可移植,编程粒度是”编程Maia Cluster、其余全自动”,信号量、内存、双缓冲都由编译器处理;Maia API是Maia专有的低层接口,需要为Cluster、Tile、Vector Processor分别写程序,一切显式。不同的编程方式实现Flash-Attention的代价:Triton约50行,Maia API约1000行——20倍的代码量差,换来的是显式信号量管理、显式内存放置、显式双缓冲,也就是对数据搬移的完全控制权。
下图展示了两种内核编程模型的对比:
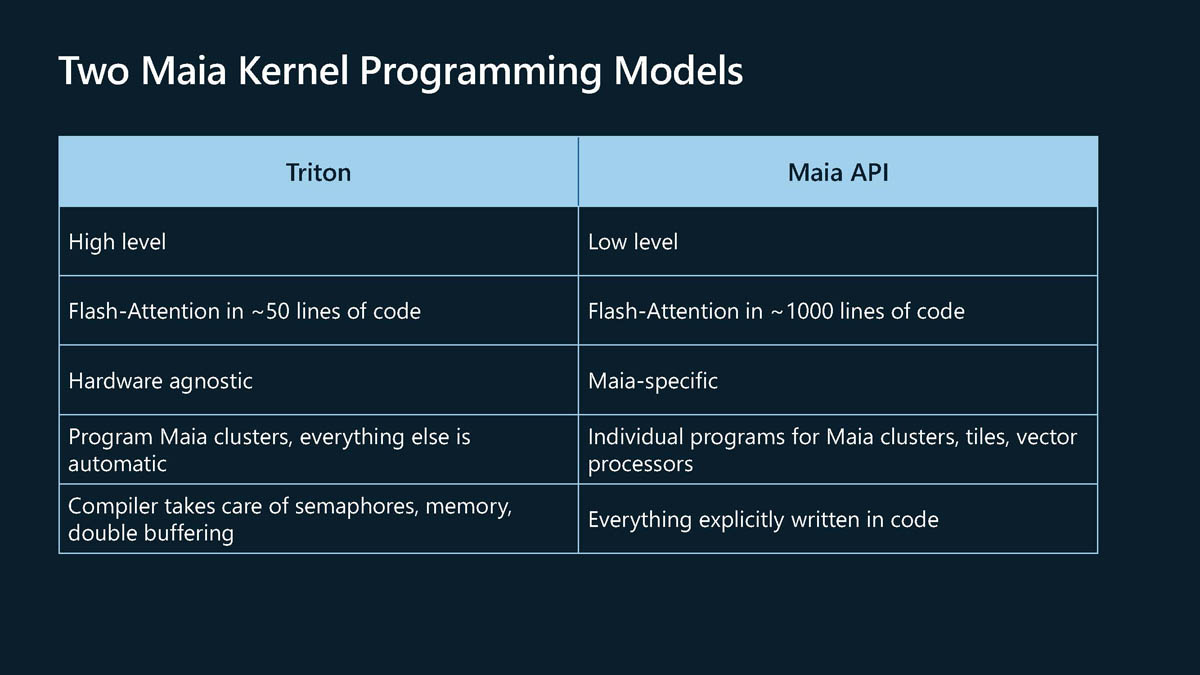
这正是SDLA哲学在编程接口上的直接投影:架构把数据管理的权力交给软件,软件就必须付出显式管理的代价。
Gather-based GEMM。处理大规模分布式矩阵乘时,Maia 100选择用gather-based方法,而不是all-reduce based方法。收益有三:把post-GEMM的逐元素激活函数(如GELU)直接融合在SRAM里执行,提升处理速度与效率;计算与网络通信重叠,减少空闲;网络上传输量化数据(MX格式),减少传输量、降低延迟。支撑这一切的是具体的片上数据流设计:计算在Cluster内部完成,激活在片内累加而不把部分和写回HBM;权重从本地HBM加载;片上激活经NOC内环(Inner-Ring)gather,跨节点激活经9条节点内链路gather;L2 SRAM(CSRAM)缓冲高精度激活与中间结果,同时减少网络流量对HBM的访问;网络控制器ANC直接对CSRAM读写。
以下两图展示了gather-based矩阵乘的分区调度与片上数据流:
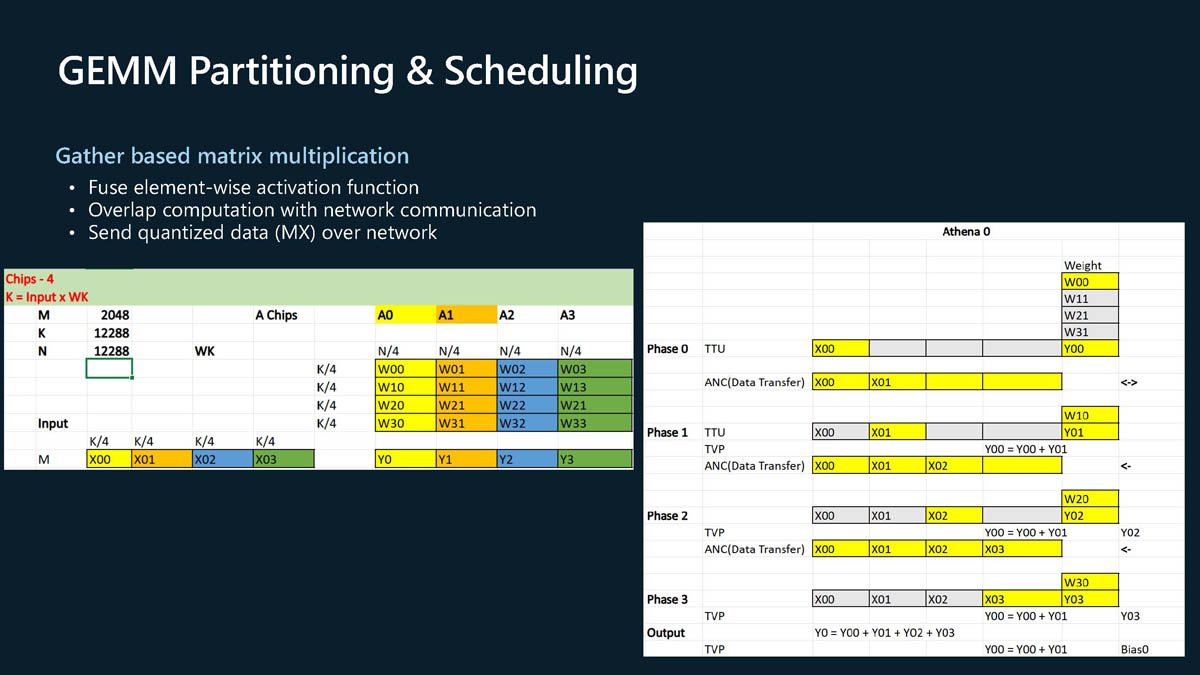
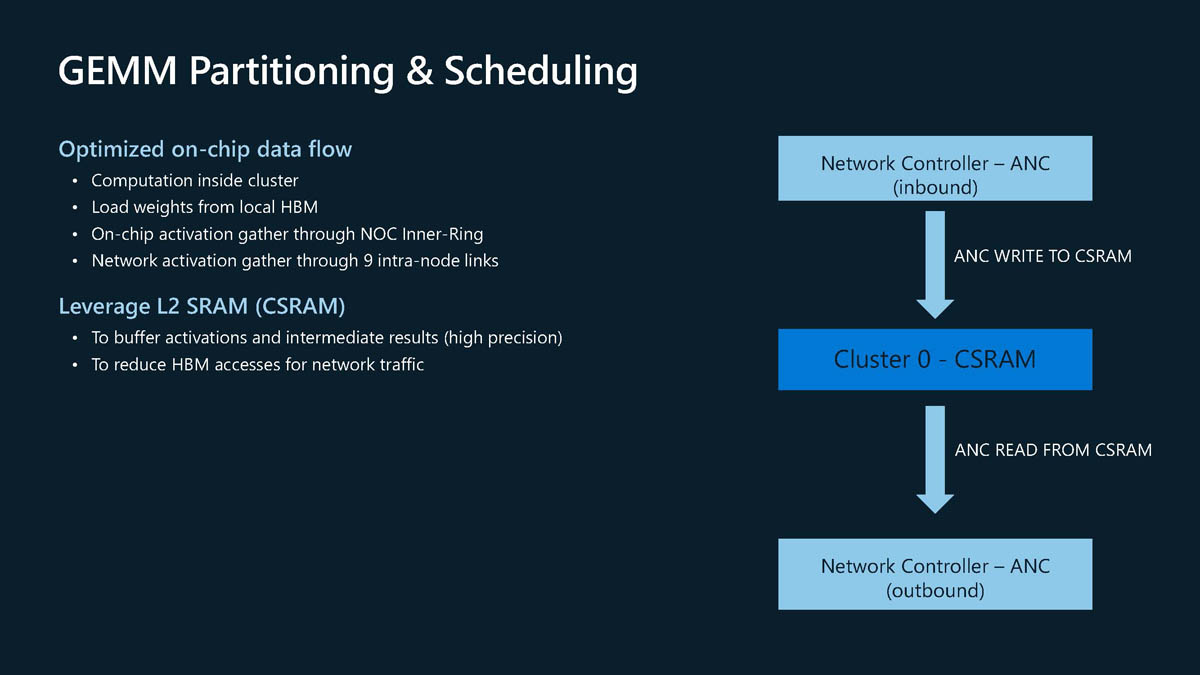
ANC直接读写CSRAM是Maia全系列网络设计的原点:网络收发的落地目标不是HBM,也不是软件缓冲区,而是集群级的CSRAM,于是”网络传输”与”片内计算”共享同一个存储层级,可以自然重叠、可以省掉一次HBM往返、可以让激活函数在数据落地的同一块SRAM上被融合执行。图9右侧的甘特图表述的就是TTU计算、TVP后处理、ANC数据搬移在时间轴上交错排布、彼此填充空隙,这正是双执行流加信号量同步想要达成的效果。
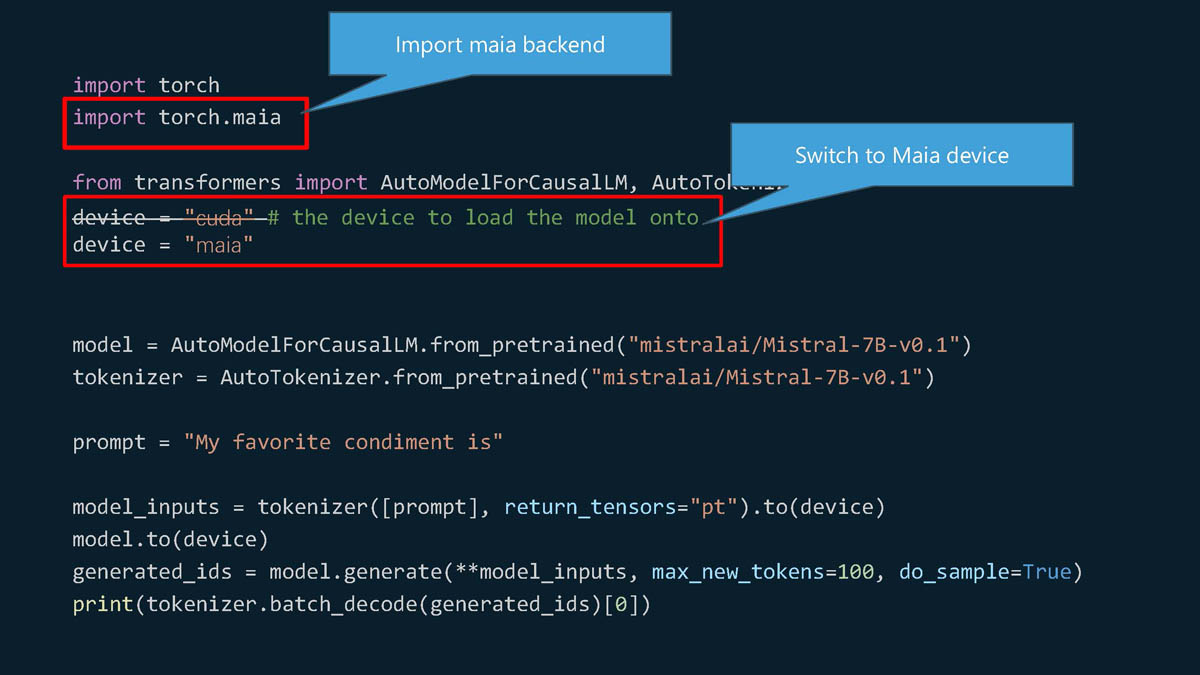
PyTorch与集合通信。微软对Maia 100”可替代性”的定义极其具体:用一行代码的改动,就能把PyTorch模型跑在Maia上——import torch.maia,再把device = "cuda"改成device = "maia"。PyTorch for Maia后端负责资源管理(HBM/SRAM/Stream/Event);eager模式用高性能内核库覆盖主流LLM/SLM使用的算子集合,提供最佳开发者体验;graph模式对接torch.compile生态,提供最佳性能。
下图展示了PyTorch集成示例:
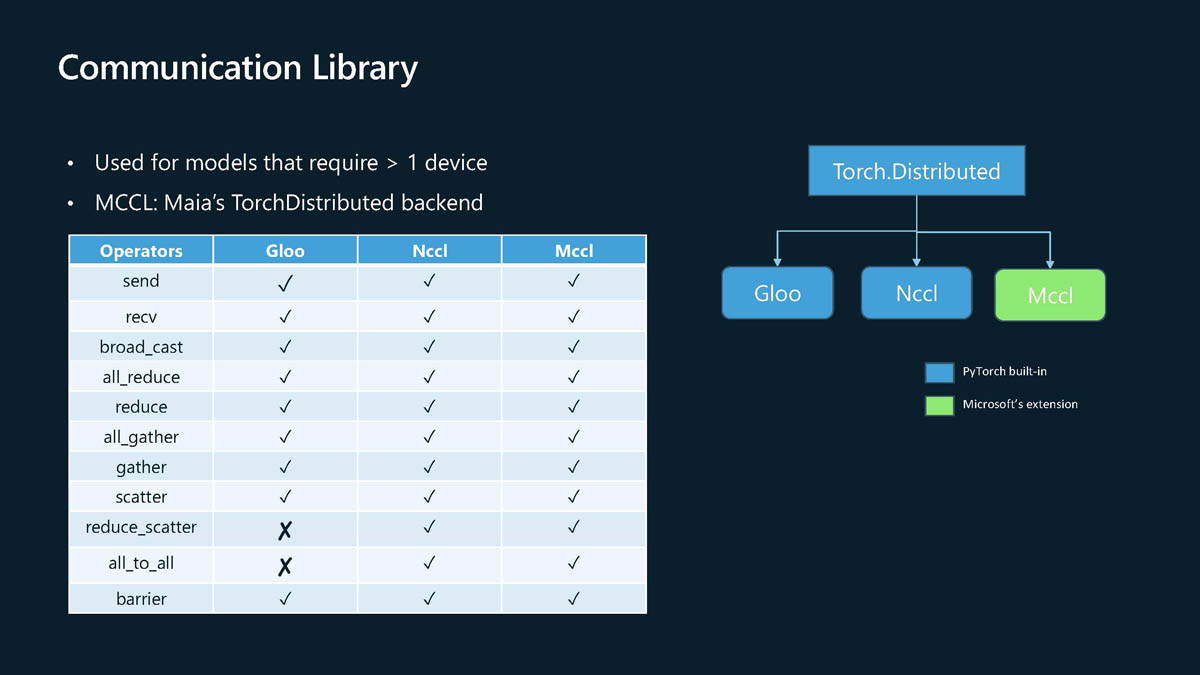
集合通信方面,MCCL(Microsoft Collective Communication Library)作为Maia的TorchDistributed后端对标NCCL,覆盖send/recv/broadcast/all_reduce/reduce/all_gather/gather/scatter/reduce_scatter/all_to_all/barrier全部算子——包括Gloo缺失、对张量并行与专家并行至关重要的reduce_scatter与all_to_all。单卡性能决定模型能不能跑,集合通信库的完备性决定能不能上大集群。
下图展示了MCCL与Gloo、NCCL的算子覆盖对比:
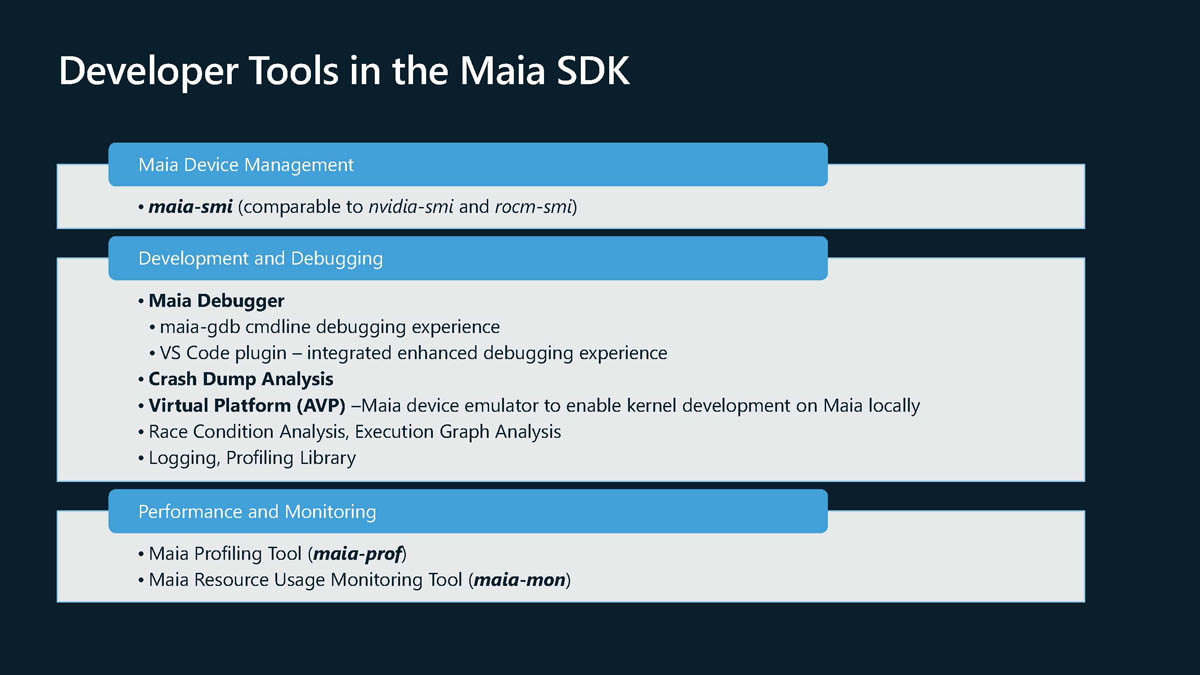
开发者工具。工具链刻意与主流生态同构:maia-smi对应nvidia-smi负责设备管理;maia-gdb提供命令行调试,另有VS Code插件与Crash Dump分析;maia-prof做性能分析,maia-mon做资源使用监控;另有竞态条件分析、执行图分析、日志与性能分析库。最值得说的是虚拟平台maia-sim——Maia设备仿真器,让开发者在没有物理硬件的情况下本地开发内核。
下图展示了Maia SDK的开发者工具:
系统扩展
Maia 100的系统侧同样是垂直整合的产物:
- 定制服务器板加量身定制的机架,而不是把PCIe卡插进标准服务器;
- 液冷作为第一代的设计约束——500W部署功耗下就已经选择了液冷路线,为Maia 300的167kW液冷机架铺好了技术路径;
- 内置加密引擎、Security Management域与AES-GCM加密的后端网络,使整机适合机密计算场景。
“设计700W、部署500W”的组合透出第一代产品的谨慎:硬件留出余量,生产功耗指标压低,换取更稳的能效与散热。
Maia 200
发展背景
如果说Maia 100是”先做出一块能用的自研芯片”,那么Maia 200就是”把这块芯片背后的方法论讲清楚,并把它推到规模化”。Maia的设计哲学可以浓缩为一句话:模型、应用框架、强化学习环境、内核、通信库、系统软件与定制芯片的协同优化,以实现per token、per watt、per dollar的最优解。Maia 200是这一哲学的第一个完整系统实现,由Saurabh Dighe(CVP, System & Architecture)和Artour Levin(VP, AI Silicon Engineering)主导设计。
SDLA架构哲学
数据管理分类法。Maia论文最具理论贡献的部分,是以1972年Flynn的指令-数据分类法为蓝本,提出一个以数据管理为核心的新分类体系。Flynn的原始分类以指令为中心,区分SISD/SIMD/MISD/MIMD;Maia的分类法关注的是数据如何被访问、如何被搬移,形成两个正交维度:数据访问范围(Local局部 vs Global全局)与数据搬移方式(隐式Load/Store vs 软件定义数据流)。两个维度交叉形成四个象限:
- LSGA 加载/存储+全局访问,代表是标准多核CPU的共享内存抽象。
- LSLA 加载/存储+局部访问,代表是GPU与Cerebras WSE的分布式暂存内存。
- SDGA 软件定义+全局访问,代表是Intel I/OAT、AMD DirectPath I/O、ARM AMBA DMA。
- SDLA 软件定义+局部访问,代表是Maia 200、AMD Xilinx XDNA、SambaNova RDU。
下图展示了这套分类法与Flynn分类法的对应关系:
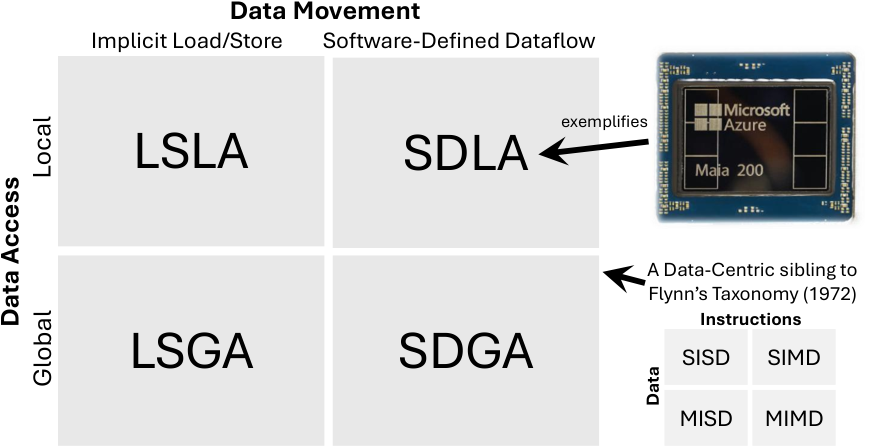
GPU处于LSLA象限:它使用局部暂存内存(如共享内存),但数据搬移仍由Load/Store指令在计算流中隐式完成。Maia 200选择第四象限:数据搬移由独立的控制指令流显式编排,计算单元只能访问本地专用内存。这一选择意味着架构师不再需要为隐式缓存行为、替换策略和预取猜测买单,而是把数据管理的全部主权交给软件。
SDLA的三大编程原则。
- 其一,暴露并行低层控制:向程序员、编译器和软件栈暴露数据搬移、转换、同步引擎的控制,实现最高性能与能效;这并非要求所有程序员都成为”ninja programmers”,而是提供选择权——编译器可生成高层抽象代码,追求极致性能的开发者可直接编排数据流。
- 其二,管理分布式专用内存系统:允许程序员管理片上及pod内的分布式专用内存,架构师可据此优化内存并用专用引擎加速数据搬移,而非用通用缓存逻辑统一管理。
- 其三,提供基本确定性的性能:消除隐式缓存带来的不确定性,使多次运行之间性能一致,优化调度可预先规划;这对Transformer注意力等内核尤为重要,数据流在编译期可完全规划。
与GPU编程模型的差异。经典GPU只提供单一编程层级(如CUDA),调度与细粒度DMA控制由硬件/固件实现,普通程序员无法触及。NVIDIA Hopper引入的Tensor Memory Accelerator(TMA)可被视为一种走向SDLA的尝试——提供专用内存与数据搬移引擎供程序员编排——但TMA与GPU的SIMT/warp系统交互复杂,导致Hopper的WGMMA在Blackwell中被推翻重设计为UMMA,破坏了向后兼容性。SDLA从第一天起就把显式、局部化内存编程作为基础原则,而非后补的补丁。Maia提供两层编程抽象:底层汇编(类似SASS)与高层类CUDA代码(通过LLVM类PTX抽象),控制路径用C/C++编程,可编程数据路径用数据流指令集架构DISA(Dataflow ISA)执行。
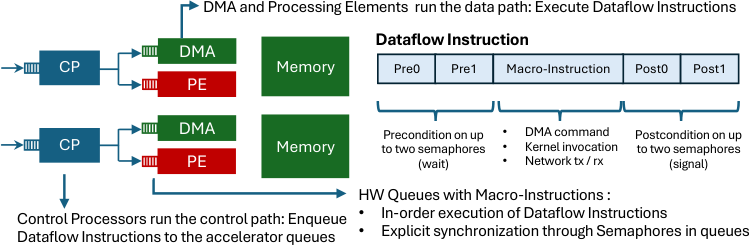
DISA。DISA定义了一条数据流指令的标准结构:同步前置条件(pre-conditions)→宏指令(macro-instruction)→同步后置条件(post-conditions),前置与后置条件通过硬件信号量实现。每条数据流指令可配置等待最多2个信号量,执行完成后可信号最多2个信号量;所有等待/信号条件有可编程的递减/递增值,命令可链式连接实现复杂同步。这一设计使数据搬移与计算之间的细粒度同步完全由硬件信号量驱动,无需软件轮询。这套ISA的语义与Maia 100的命令结构同源,Maia 200的贡献在于把信号量数量、递减/递增幅度、链式连接等细节明确下来,并把控制层级从两级扩展到三级。
下图展示了DISA的抽象机器模型:
SoC架构
Maia 200的SoC采用三级层级结构,每一级都有独立的控制处理器、内存和DMA引擎,体现了SDLA中”控制与数据路径分离并并发运行”的原则。
下图展示了Maia 200 SoC架构:
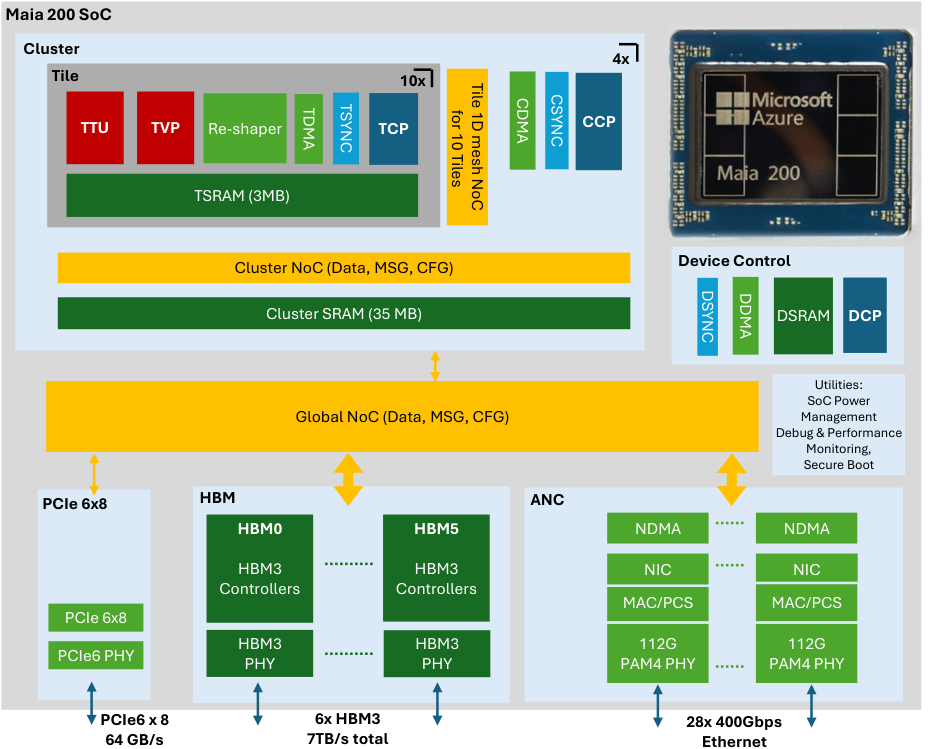
Tile 是最小自主计算单元,集成TTU张量引擎负责高吞吐矩阵乘与卷积、TVP向量处理器负责可编程SIMD运算、TSRAM作为Tile级暂存内存直接附加于两者、Tile DMA子系统在不阻塞计算流水线的情况下搬运数据(内置Reshaper引擎支持线速格式转换)、TCP控制处理器运行底层控制代码编排TTU与DMA工作,以及硬件信号量引擎实现数据搬移与计算之间的细粒度同步。这个组成与Maia 100的Tile在结构上一一对应,区别在于规模、频率与精度支持的扩展。
Cluster 每颗SoC由4个构成,每个含10个Tile。Cluster级提供CSRAM集群级共享存储跨Cluster内所有Tile可访问、Cluster DMA在CSRAM与共封装HBM之间搬运数据、CCP集群控制处理器协调Cluster内多Tile执行的控制与同步。对比Maia 100的16 Cluster×4 Tile,Maia 200改为4 Cluster×10 Tile:Cluster数量减少、单Cluster内Tile数量增加,意味着Cluster内的局部性被放大——CSRAM要服务的Tile更多了,Cluster间的NoC跳数压力下降了。这是”把数据留在更近的地方”这一原则在拓扑层面的体现。
SoC 顶层包含Device Control块(含DCP设备控制处理器、SRAM、专用DMA与Sync引擎),以及三层互连:Tile 1D mesh NoC连接Cluster内的Tile;GNoC全局NoC连接所有Cluster、HBM控制器、PCIe主机系统与ANC;Utility fabric全连接所有同步块以实现最低延迟的相互通知。NoC在物理上分割为逻辑高带宽数据平面与专用控制平面,数据流量与控制/遥测流量物理隔离——这正是Maia 100的Fabric (Data, MSG, CFG)三分通道的延续与细化。数据NoC支持QoS,可优先处理不同流量;NoC还支持多播,例如从HBM取一次张量后扇出到多个CSRAM。Maia 200对Tile和SRAM均采用冗余设计以提高良率。
计算引擎
TTU张量引擎是Maia 200的核心计算单元,针对矩阵乘与卷积优化,原生支持BF16、FP8、FP6、FP4四种精度,并支持混合精度模式(如FP8激活×FP4权重)。其关键吞吐比十分醒目:FP4吞吐为FP8的2倍、BF16的8倍;FP6与FP8吞吐相同,但通过gating实现显著能耗节省。TTU以blocked格式读取32×K×32矩阵,输出FP32或BF16累加结果,并支持组合为符合OCP标准的MXFP数据类型(E8M0缩放因子、组大小32)。把TTU的粒度从Maia 100的16×R×16提升到32×K×32,外层粒度翻倍意味着单次矩阵乘的数据块更大、算术强度更高、对大规模GEMM更友好;Maia 100当年选16×R×16的理由正是”粒度损失与峰值性能之间的权衡”——第一代保守地保留了更多灵活性,第二代则明确押注大规模GEMM。
TVP向量处理器处理TSMEM数据,可对TTU的矩阵输出做后处理;TTU也可从TSMEM读一个输入操作数以支持高效操作链,形成TTU→TVP的直接数据通路。TVP支持从INT8到FP32的丰富数据类型,处理softmax、低精度数据转换及其他非矩阵运算。
Maia 200还区分存储数据类型与计算数据类型:窄精度格式(如FP4)作为存储格式以减少传输与存储位数,通过Reshaper单元在加载时线速上采样为计算格式。Reshaper支持随机舍入或最近舍入,并可全带宽加载8:16或4:16稀疏张量到/从密集张量。”存储格式窄、计算格式宽”的分离,正是Maia 100时代”数据压缩引擎+窄数据类型”的正式化版本——只是把压缩的粒度从”引擎”细化到了”格式”,并与线速转换绑定在一起。
存储结构
SDLA架构最反直觉的决策之一,是用软件管理的暂存内存取代硬件管理的缓存。这并非草率之举,论文给出了严谨的理论论证。对于数据无关算法(data oblivious algorithms)——所有内存访问与数据流可基于编译期可得的少量参数计算——AI负载几乎天然满足这一条件:多数AI计算图是固定内核(矩阵乘、SoftMax、非线性等)的静态组合,整体数据流可预先规划;少数例外(连续动态批处理、MoE路由、提前终止)可用参数化方式在粗粒度控制层处理。
理论上,LRU缓存对于单位缓存行、大小为scratchpad两倍的缓存,其缺失率最多为最优离线管理方案的2倍。实践数据显示,手动从cache移植到scratchpad的HPC负载平均几何加速为13%。更关键的是硬件开销:cache需要tag内存阵列与地址重映射逻辑,额外面积与能耗开销约30-35%,访问延迟增加10-15%,实际的面积-时间与动态能耗总开销高达43%。
Maia 200通过显式编程的SDLA内存架构,使内存占用芯片空间低于20%——远低于许多CPU的缓存面积占比。所有SRAM与HBM均有ECC保护,可按需擦除防位翻转;编排数据移动的专用DMA引擎仅占可忽略的裸片面积;分层内存由TSRAM(Tile级暂存)、CSRAM(Cluster级共享)与共封装HBM构成。官方给出的总量是272MB片上SRAM,按多层级划分为Cluster级CSRAM与Tile级TSRAM;从SoC架构图可读出具体容量——CSRAM 35MB/Cluster、TSRAM 3MB/Tile,折算全芯片为4×35MB加4×10×3MB,即140MB CSRAM加120MB TSRAM,合计260MB,与272MB的差额在设备控制块存储与冗余阵列上。Maia 100的约500MB L1/L2 SRAM到Maia 200的272MB片上SRAM,总量是下降的,而HBM带宽从1.8TB/s提升到7.1TB/s近4倍。这组数据清楚表达了SDLA的内存选择,片上存储不必追求容量最大化,够用即可;关键是用更快的HBM与更聪明的软件放置策略,把”必须搬移的数据”减到最少。
数据搬移与控制
数据搬移架构围绕分层DMA引擎与分层NoC构建。系统包含数十个不同DMA引擎,各司其职:
- Tile DMA负责TSRAM↔CSRAM细粒度传输,内置Reshaper引擎支持1D/2D/3D/4D张量strided搬移、scatter/gather、线速数据类型转换与稀疏支持;
- Cluster DMA负责CSRAM↔HBM或跨Cluster搬运;
- Network DMA管理片外链路的收发路径,与ANC紧密耦合。
NoC的创新功能包括HBM→Cluster高效广播(张量从HBM取一次后经multicast扇出到多个CSRAM)、局部高带宽Cluster流量(簇内完成层内归约、暂存交换、小集合通信)、Tile-to-Tile SRAM访问(Tile DMA与向量单元可直接读写对等Tile的SRAM)、QoS(优先处理同步信号等低延迟关键消息)与fail-safe管理平面(隔离控制/遥测流量与数据路径)。内存大小按Little定律确定,以最大化数据复用、最小化数据移动与寻址开销。
控制路径是完整SDLA微架构的最后一块拼图。Maia 200结合SoC、Cluster、Tile三级控制,各级含多个控制处理器,运行用户C/C++程序,通过DISA编排数据路径。控制处理器通常略超前于数据流运行,提前配置引擎——较大的暂存内存支持这种异步性,允许控制处理器预存足够工作使单元永不等待。层次化架构优势的典型示例是MoE路由:路由函数决定激活发送目的地时,TVP在TSRAM中评估TTU路由矩阵乘法的输出,在少数周期内将结果交给TCP,启动向各目的地的预配置数据移动操作;此数据依赖流可通过信号量与DMA操作提前建立,DMA从TVP获取scatter-gather操作——全程无需软件轮询介入。这个”控制处理器略超前、靠大暂存内存吸收异步性”的模式,在Maia 100里被描述为”控制处理器发出异步命令、硬件线程在数据路径上直接同步”;从两级控制到三级控制,从”控制处理器+队列”到”DISA+链式信号量”,Maia 200把Maia 100的工程机制变成了一套可推理的编程契约。
网络互连
当模型跨越多个加速器时,网络成为执行引擎的一部分。Maia 200采用全以太网方案,将片上SDLA的数据流编排理念延伸到跨芯片通信。它集成28个400G以太网AI网络控制器ANC,提供1.4TB/s全双工带宽,完全集成进SDLA微架构——消除外部NIC的功耗与成本开销,网络占系统成本低于20%。对比Maia 100的12×400GbE,端口数翻倍有余。
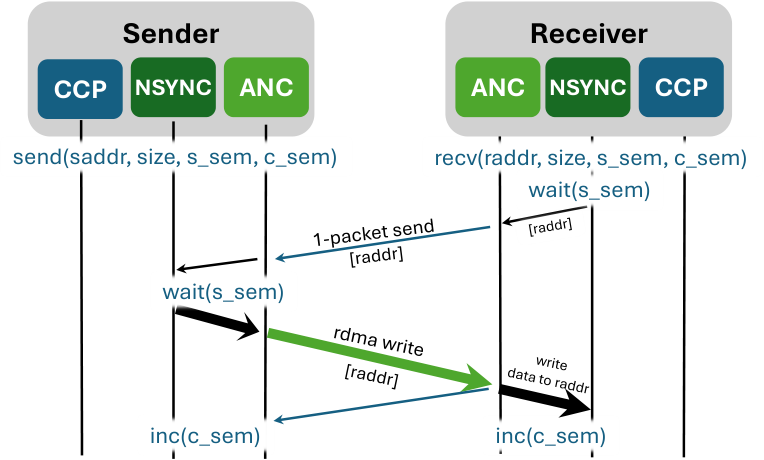
ATL协议。ANC运行于无损以太网(PFC)L2网络上的微软自研ATLv2协议,其设计后来影响了UEC的AI Base Transport Profile标准化。关键特性包括标准L2以太网帧与L3 IP路由头、全端到端AES-GCM-256加密(延续Maia 100的加密后端网络)、基于窗口的拥塞控制、ECMP+逐包负载均衡(packet spraying)、选择性重传(克服Go-Back-N的已知限制),以及网络中及GNoC到HBM的QoS。
下图展示了ATL的接收端驱动消息方案:
两层拓扑。Maia 200的网络拓扑结合固定直连链路与交换连接,是2×2 1D Hamming Mesh的特例:FCQ(Fully Connected Quad)由4个加速器通过无交换机直连链路组成最小全连接组——这正是Maia 100拓扑图中每个node内4颗加速器两两全连接的结构,Maia 200将其保留并正式命名;交换层则将连接扩展至最多6,144个加速器。28个ANC中,20个用于固定链路,8个连接交换网络;交换网络由4个相同平面组成。
下图展示了Maia 200的两层网络拓扑:
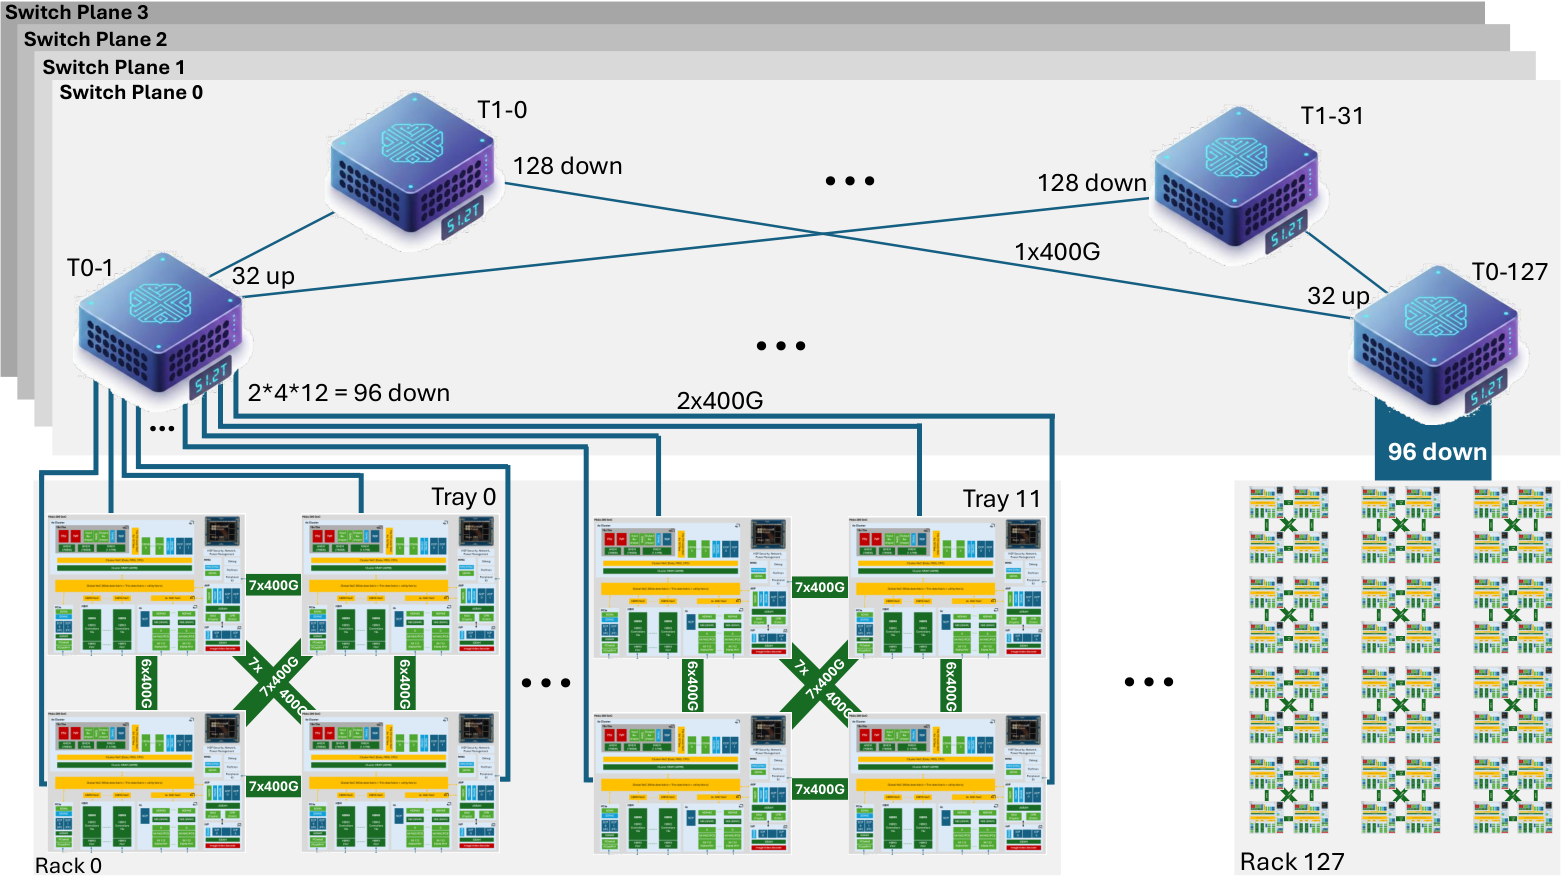
MCCL实现了两种算法:Direct connect直接将数据分片发给目标端点,消息深度为1,延迟最低,适合小传输;Ring建立逻辑1D环流水线发送,适合大传输。8芯片Allgather实测达到延迟界限的78%、带宽界限的94%。带宽平衡能力也值得注意:托盘设计看似非对称(南北向300GB/s,东西向与对角350GB/s),但交换部分可灵活用50GB/s加强南北向,实现四方向全平衡350GB/s,总平衡网络带宽1.4TB/s。
编程模型
Maia 200没有推翻Maia 100的编程模型,而是把它明确化、命名化并推向规模,新增内容主要有两点。
- 一,低层路径获得正式名称:Maia 100时代的”Maia API”在Maia 200里被称为NEPAL(Nested Parallel Language),一个基于C++的低层语言,用于显式控制数据搬移、SRAM放置与并行执行以逼近峰值利用率;语义未变,但有了可被文档化的名字。
- 二,单芯片Tile规模从64颗收敛到40颗,控制层级从两级变为三级,每级均有多个控制处理器运行用户C/C++程序。
从Command到DISA。把Maia 100的命令结构与Maia 200的DISA并排看,语义完全同源:in semaphores对应同步前置条件,arguments对应宏指令,out semaphores对应同步后置条件,同步原语都是硬件信号量。Maia 200新增的是细节与规模:前置条件最多等2个信号量、后置最多发2个,递减与递增幅度可配置,命令可链式连接实现复杂同步;控制粒度从Cluster/Tile两级扩展到SoC/Cluster/Tile三级。可以说Maia 100是数据流执行的工程验证,Maia 200是它的理论形式化与规模化——前者证明这套机制能跑通生产负载,后者把它写成ISA,让编译器与程序员都有了明确的目标。
性能验证
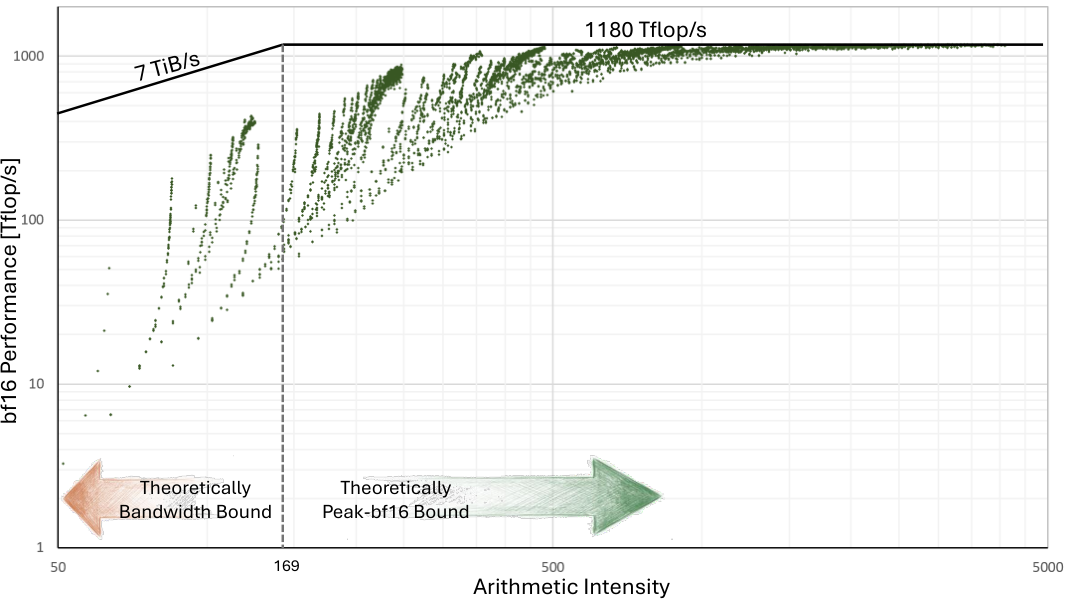
Roofline矩阵乘法。测试6,143个代表生产推理负载的矩阵乘法shape,基准系统每Cluster启用9个Tile,运行于2GHz。结果令人印象深刻:BF16计算受限区效率最高达峰值99.69%、内存受限区达峰值带宽51.4%;FP8计算受限区达峰值96%、内存受限区达56%。
以下两图展示了6,143个矩阵尺寸的BF16与FP8矩阵乘法性能:
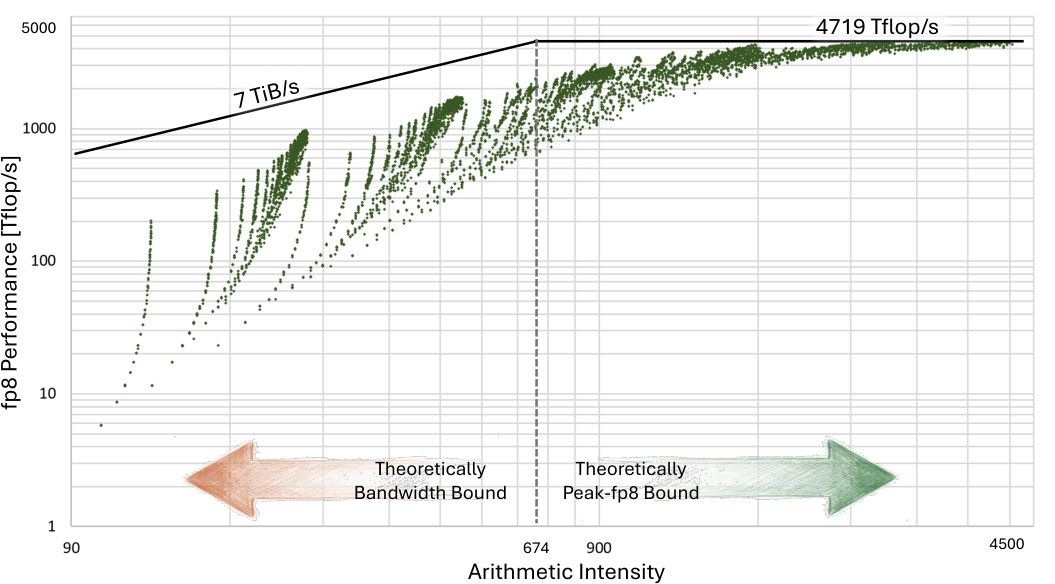
端到端生成式推理。以公开模型Qwen 2.5 7B(28层,内维3,584,FFN中间维18,944,GQA 4个KV头)为测试对象,聚焦内存受限的token生成阶段:16,384个前序token自回归生成第16,385个token,KV cache大小939.52MiB。由PyTorch调用标准内核(无额外融合)的直接实现达2,434 tokens/s,超过估计最大性能的70%。这表明SDLA不仅在单矩阵乘法或集合操作接近峰值,对复杂端到端实际推理负载也表现优异。
下图展示了8颗Maia 200(两个托盘)的Allgather基准结果:
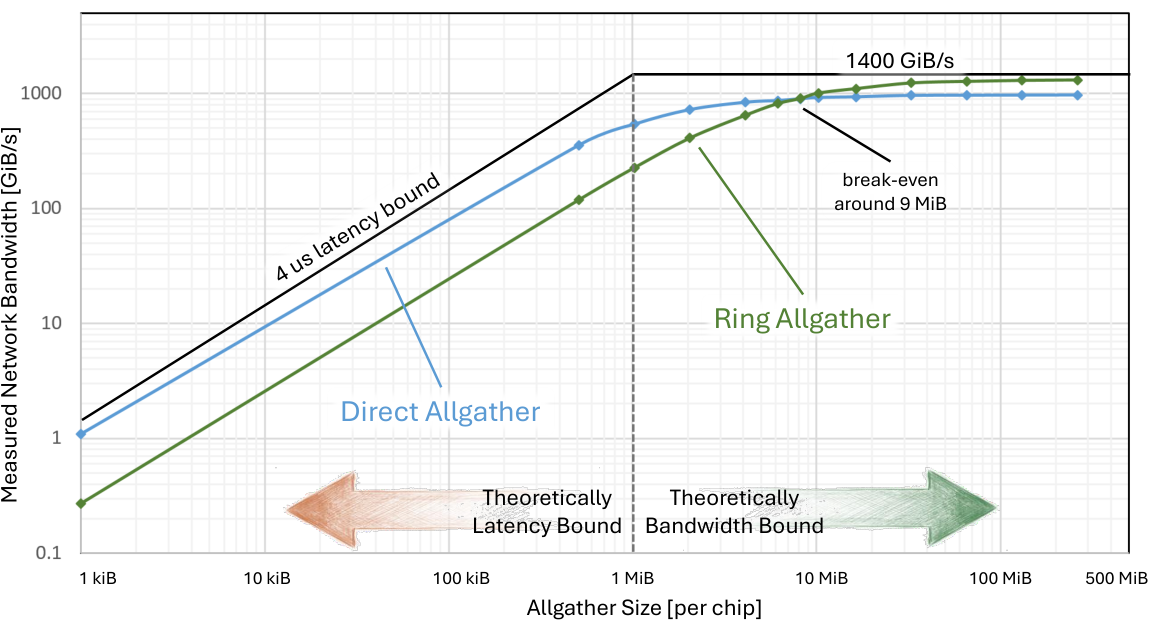
在系统级,相同机架功耗预算下运行MAI-Thinking-1模型,Maia 200相比微软机群中最新一代GPU实现超过40%更高的token生成吞吐,以及约30%更好的性能/美元;相比机队其他AI加速器节省30% TCO与15%能耗。
系统扩展
Maia 200采用共封装HBM,硬件层与Azure第三方GPU系统协同设计,遵循标准化机架、供电、机械架构,可与异构加速器在同一数据中心空间共存。散热设计模块化:支持风冷与液冷部署,包括第二代液冷sidecar。每个托盘含4颗SoC,深度集成Azure原生控制平面,继承生命周期、可用性、可靠性保证,支持自动化节点上线、安全原地升级、多机架协调维护。
下图展示了Maia 200托盘与风冷部署机架:
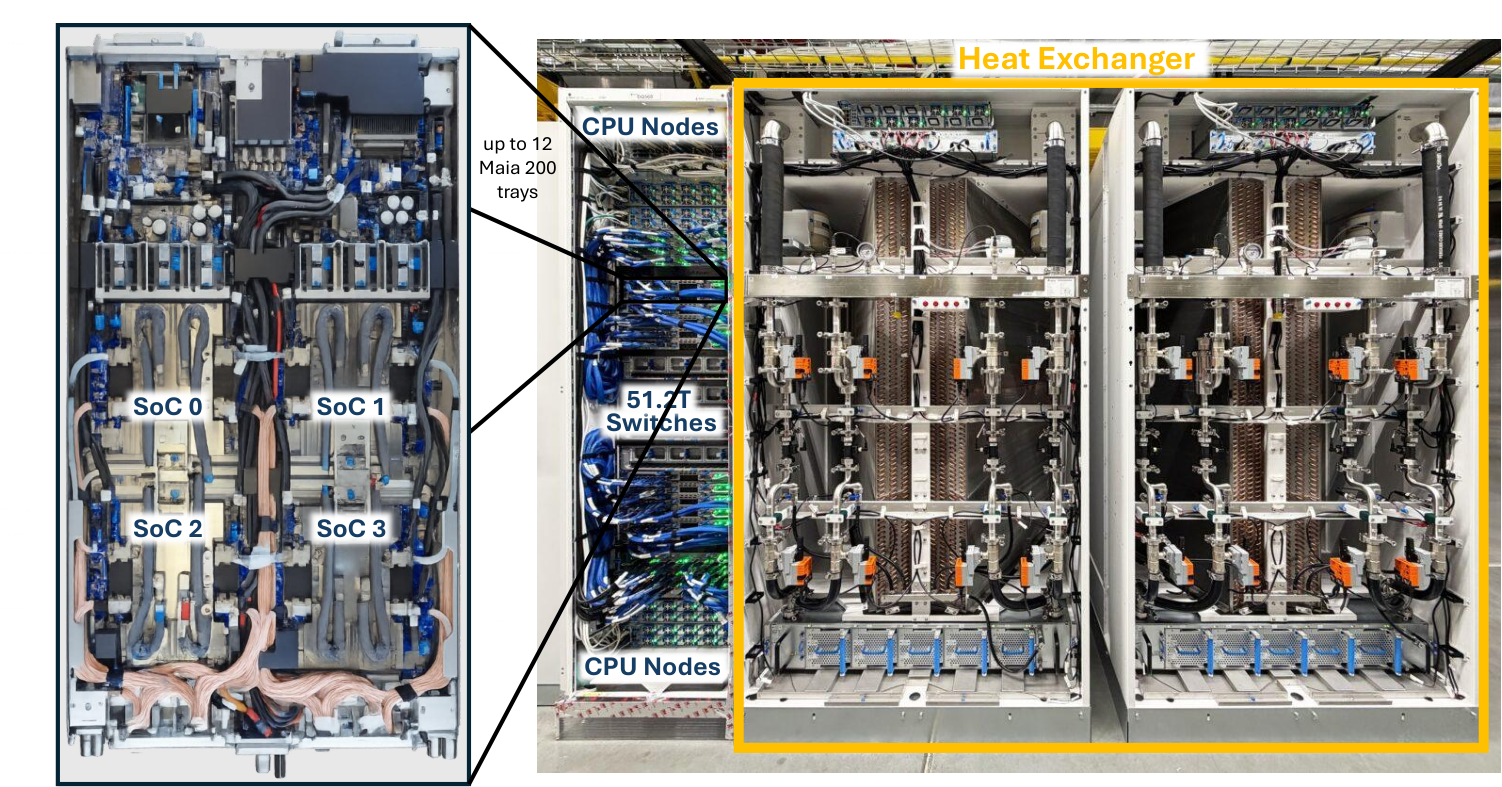
与Maia 100相比,Maia 200在系统侧最重要的变化是从”定制整机架”走向”标准化机架”:第一代要求量身定制的机架与服务器板,第二代则回到标准机架与供电架构、允许与异构加速器共存。这是规模化部署的必然选择——自研硅要跑量,就不能要求数据中心为它单独改造。
Maia 300
发展背景
如果说Maia 200证明了SDLA架构的可行性与效率优势,那么Maia 300则将这一架构推向云规模智能体推理(cloud-scale agentic inference)的极限。智能体负载——多步执行、长上下文解码、工具调用——正在改变推理的计算特征与算术强度,对局部性、内存容量/带宽、通信扩展性提出了全新要求。Maia 300由Rani Borkar和Saurabh Dighe主导设计,于2026年10月发布,是Maia项目的第三代产品。它的核心理念可以用一个词概括:系统级优化——软件、芯片、物理机架基础设施、网络与数据中心协同设计为一个统一平台。
综合来看,三代Maia的软件栈是一条不断把”显式控制”制度化的线索:Maia 100让软件能管理暂存内存与信号量;Maia 200用ISA与分类法把它变成契约;Maia 300引入AI辅助优化,试图降低遵守这份契约的人力成本。
多芯粒架构
Maia 300最大的架构跃迁是从Maia 200的单体裸片转向多芯粒设计。这一决策的逻辑清晰而务实:计算芯粒放在TSMC N2P上,先进工艺对计算的性能/瓦收益最大;内存控制器与I/O芯粒分离到针对带宽、连通性与成本优化的专用工艺上。一颗Maia 300封装内包含一颗主计算芯粒、两颗I/O芯粒、四颗内存芯粒与八个HBM4堆栈。
下图展示了Maia 300芯片封装实物:
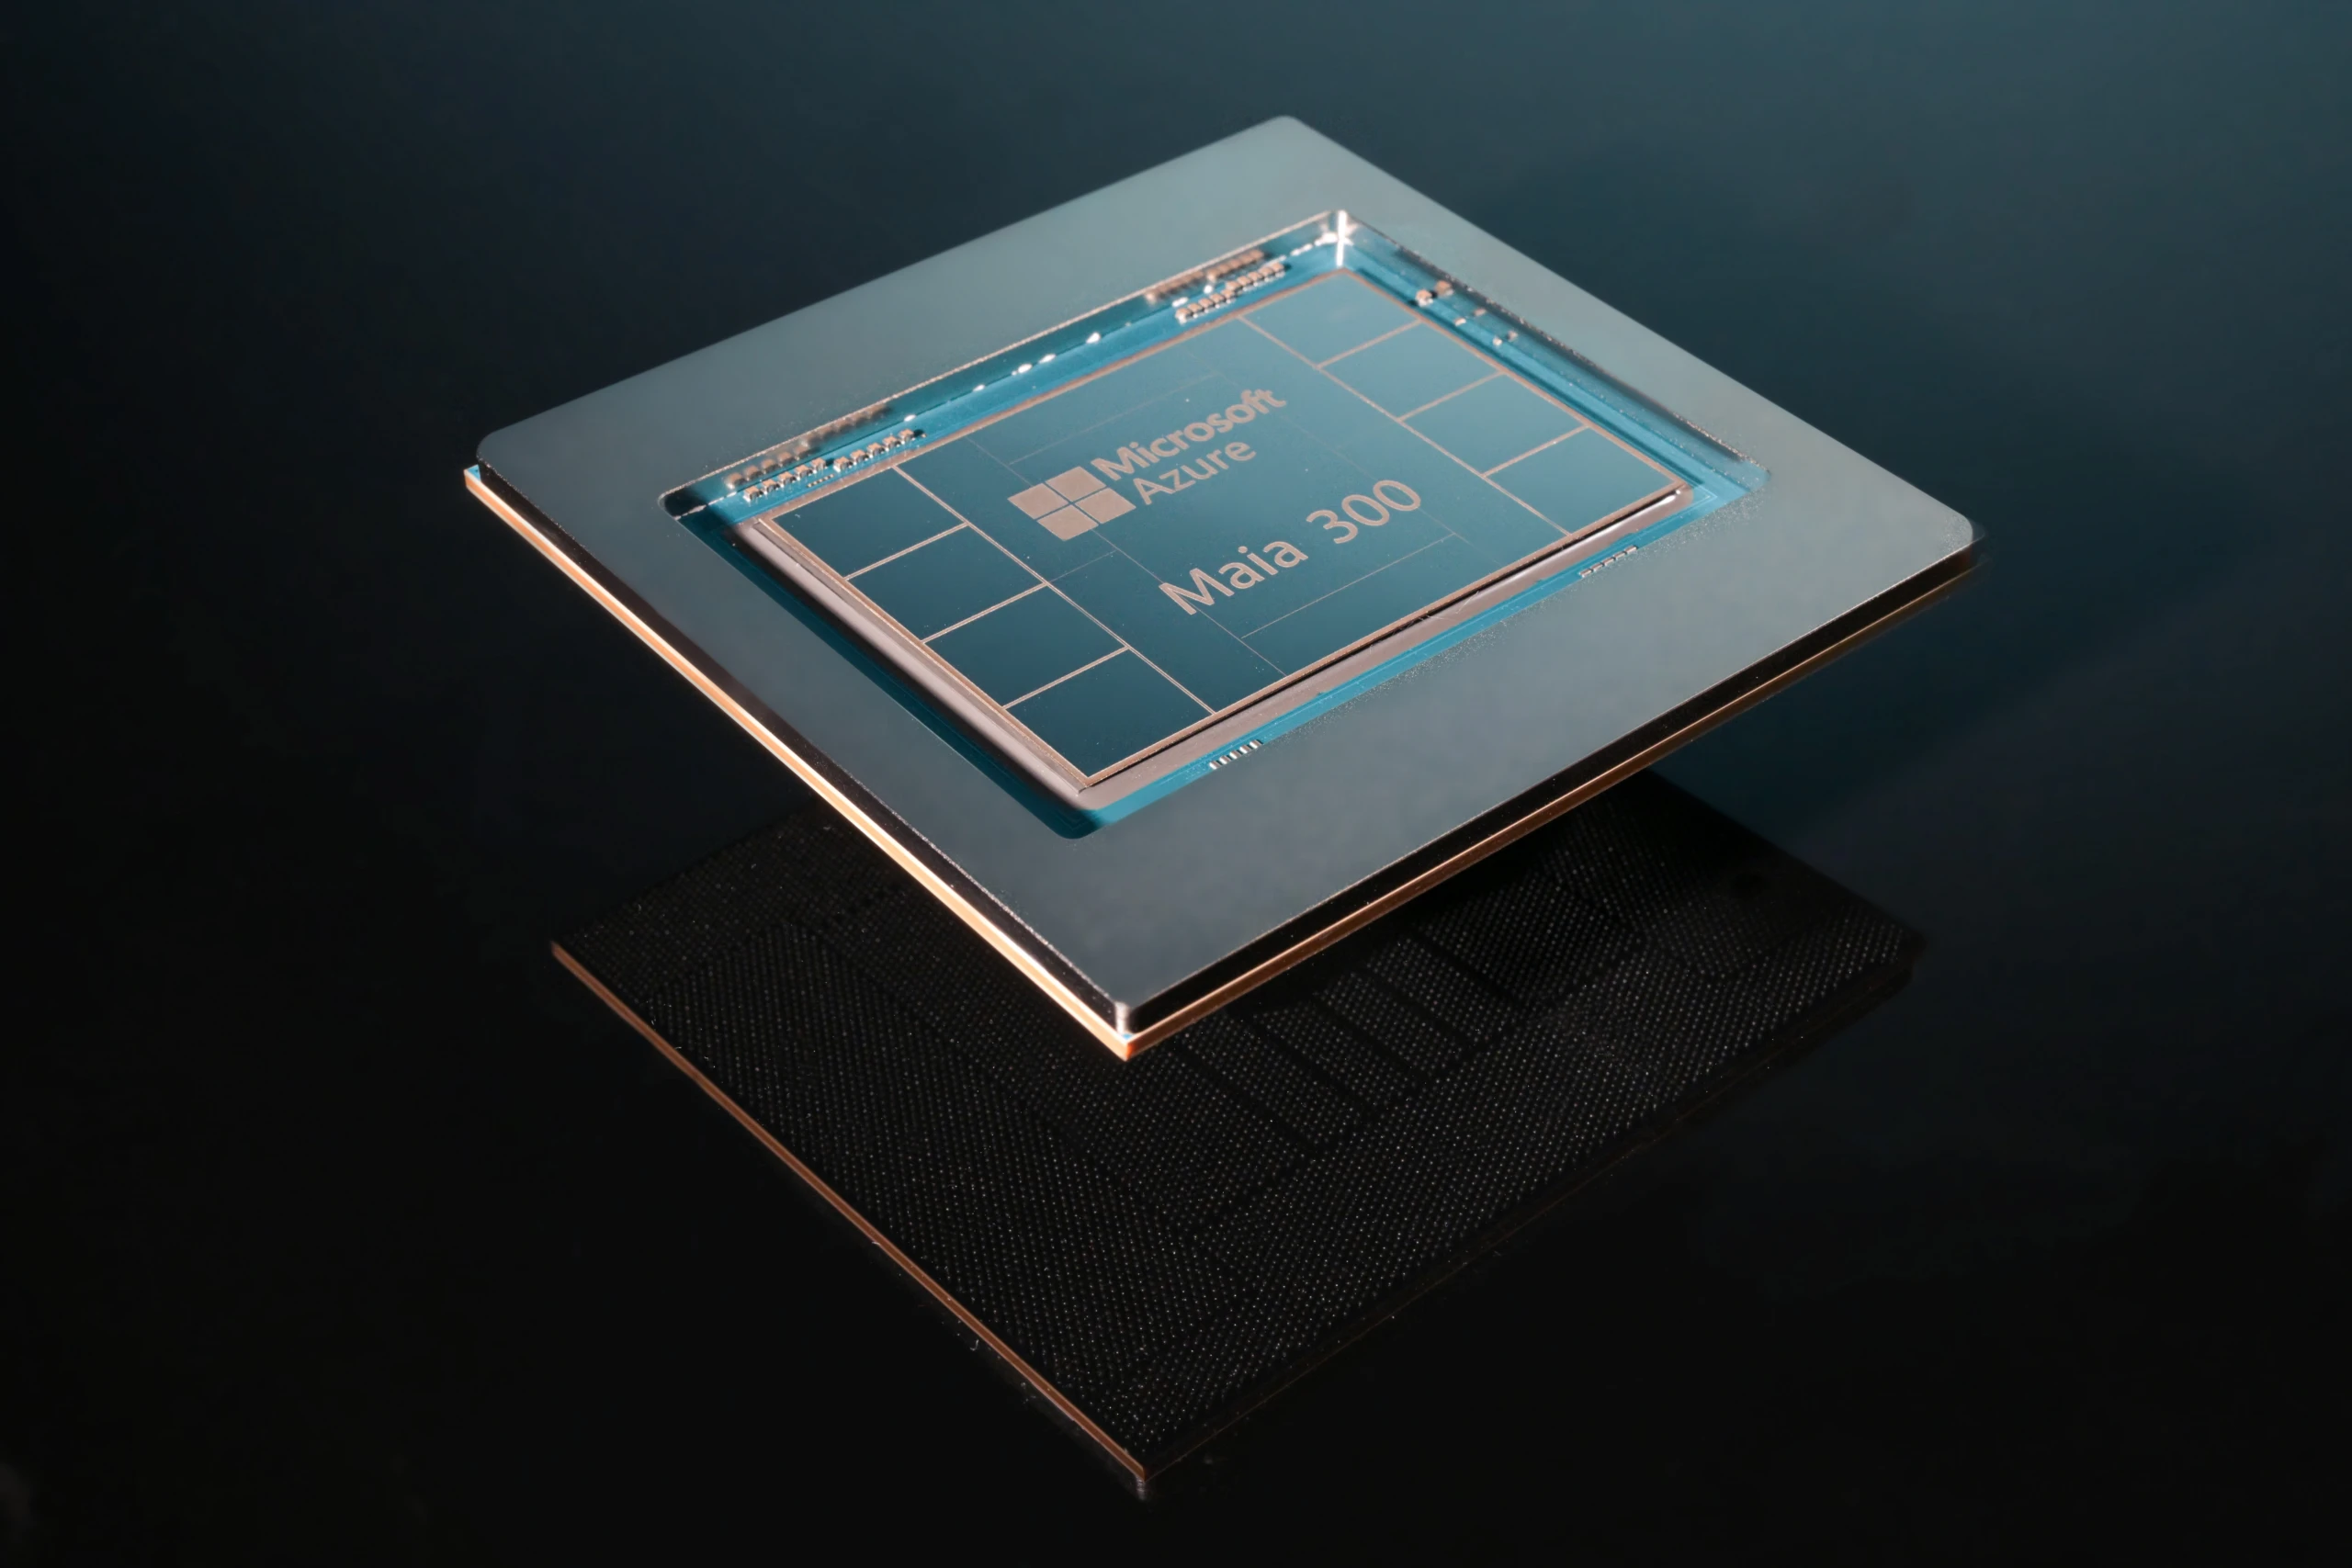
这一策略的效果是三重的:增加计算面积占比,把更多硅片面积用于计算而非被I/O和内存控制器占据;各功能使用最优技术,计算用最先进工艺、I/O用成熟高良率工艺;SDLA管理跨封装局部性,软件定义的数据流编排无缝跨越芯粒边界。相比Maia 200,Maia 300的系统计算FLOPs提升36%、HBM带宽提升2.5倍、scale-up带宽提升14%。
从Maia 100(N5单体820mm²)到Maia 200(N3P单体近光罩尺寸)再到Maia 300(N2P计算芯粒+专用I/O/内存芯粒),三代芯片的形态演进给出一个清晰的规律,当计算、I/O、内存控制器各自的最优工艺开始分化,多芯粒就成了必然。
下图展示了Maia 300 SoC架构:
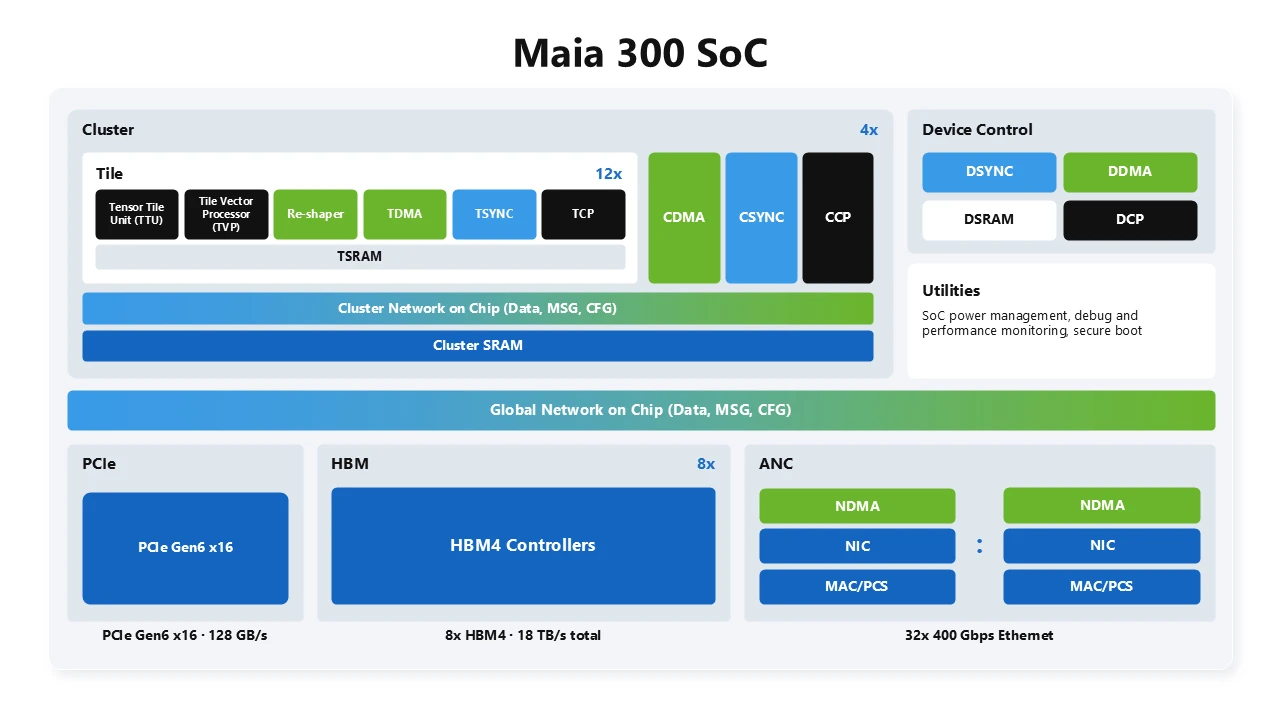
Maia 300单芯片的tile组织更加规整——每Cluster 12个Tile、共4个Cluster,且封装内直接集成32条400Gbps以太网链路(Maia 100为12条、Maia 200为28条),网络进一步深度嵌入SDLA微架构。
存储结构
Maia 200的SoC采用统一内存访问UMA组织,所有Cluster共享相同的HBM访问延迟与带宽。Maia 300将其演进为非统一内存访问NUMA组织,跨芯粒分布:每个计算芯粒区域有就近的HBM,SDLA的显式控制将数据放在使用它的计算旁,数据旅行距离更短,从而减少搬移能耗;软件可感知NUMA拓扑,将热数据放在本地HBM、冷数据放在远端。
内存层级也从Maia 200的6个HBM3E堆栈升级为8个HBM4堆栈,单芯片带宽从7.1TB/s提升至18TB/s、容量从216GB提升至288GB。TSRAM与CSRAM的两级结构延续下来,。更关键的是低精度格式的进化:Maia 300引入增强MXFP4与亚3比特存储格式,更窄的表示减少内存占用与数据搬移量,使系统能在相同功耗包络内支持更大模型、更长上下文、更多并发会话。此外,Maia 300的ISA向量引擎还针对softmax、低精度数据转换等关键推理内核增加了优化。
网络互连
Maia 300将网络作为SDLA架构的原生扩展。AI网络控制器实现了基于以太网的定制AI传输,两层网络构建高性能superpod,支持最多12,288颗加速器;软件看到的是统一通信模型——向superpod内任意加速器直接搬移数据的语义完全一致。
下图展示了Maia 300的两层scale-up网络:
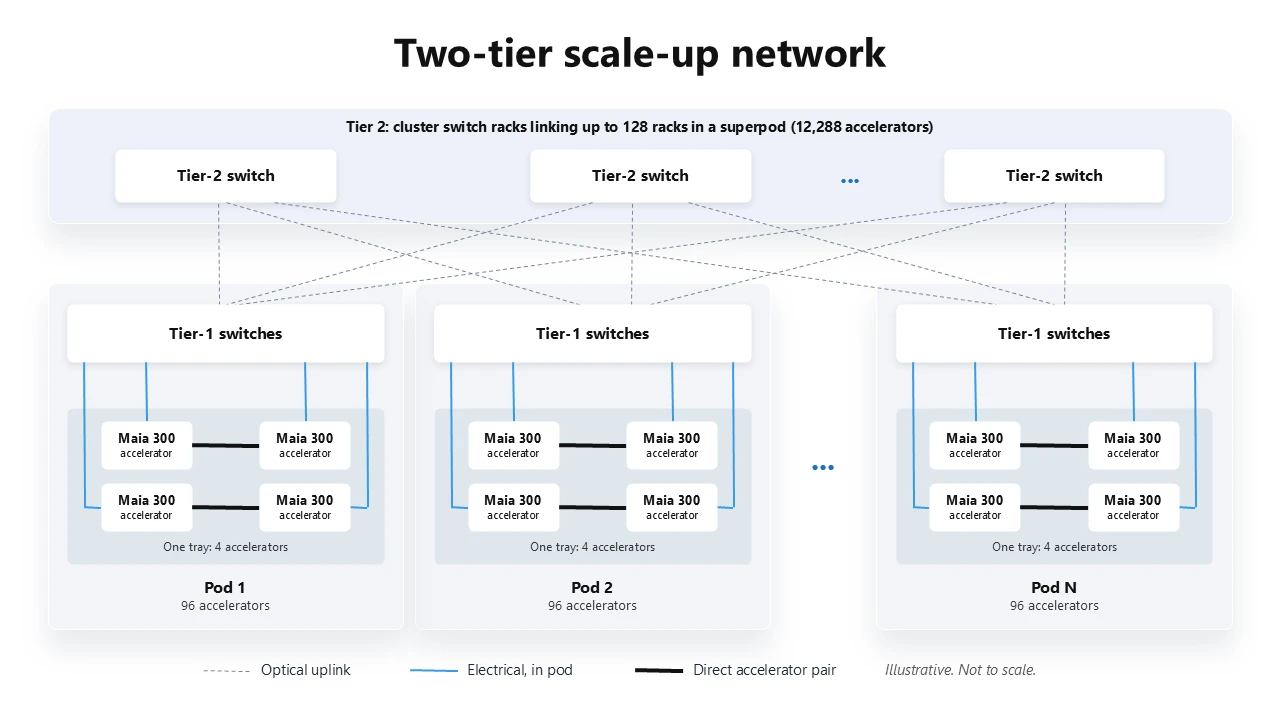
半交换机内机架拓扑与光学跨机架。每颗加速器将scale-up连接在直连链路(连接同一托盘内的两颗加速器)和交换路径之间分配。机架内全部96颗加速器经交换fabric形成一个pod,全部使用电气链路以降低功耗与成本;第二层则用光学链路连接最多128个机架组成superpod,光学提供跨pod扩展scale-up网络所需的距离。这个”托盘内4颗直连”的结构从Maia 100起就存在,Maia 200命名为FCQ并保留,Maia 300沿用并扩到96颗pod。
统一fabric与动态带宽。Maia 300最具架构意义的设计是单一fabric而非分离的scale-up与scale-out域:集成网络控制器与专用AI传输在pod内与跨superpod使用相同通信语义,加速器可直接向superpod内任意加速器发起通信,无需主机或独立scale-out NIC介入。三个延迟域清晰分层:直连加速器对(最低延迟)→pod内加速器(一跳)→跨pod加速器(三跳)。机架内与跨机架带宽分配不再是固定设计参数,而是基于作业打包的运行时可调参数;当只有部分加速器跨机架时,单颗加速器可向superpod内任意对端驱动最高750GB/s。”同一张网同时承担scale-up与scale-out”这个想法最早出现在Maia 100的”Unified Network”里,三代之后,它从一句设计宣言变成了12,288颗芯片的统一fabric。
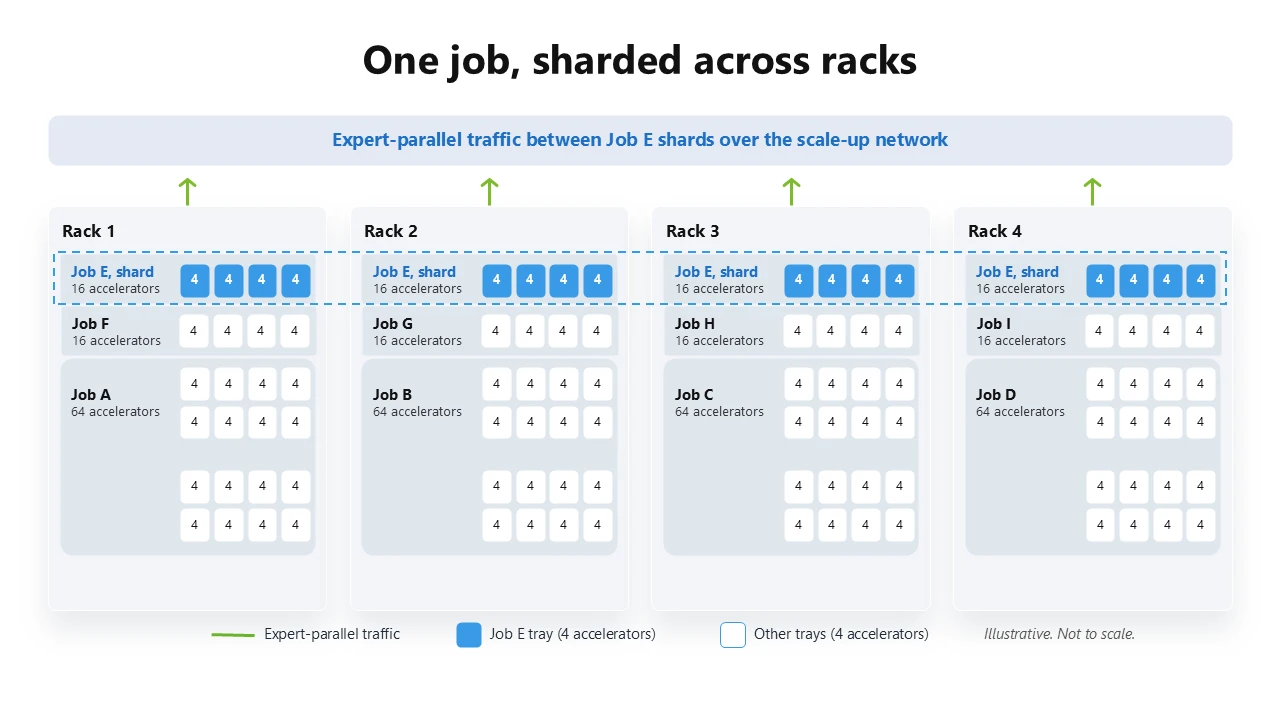
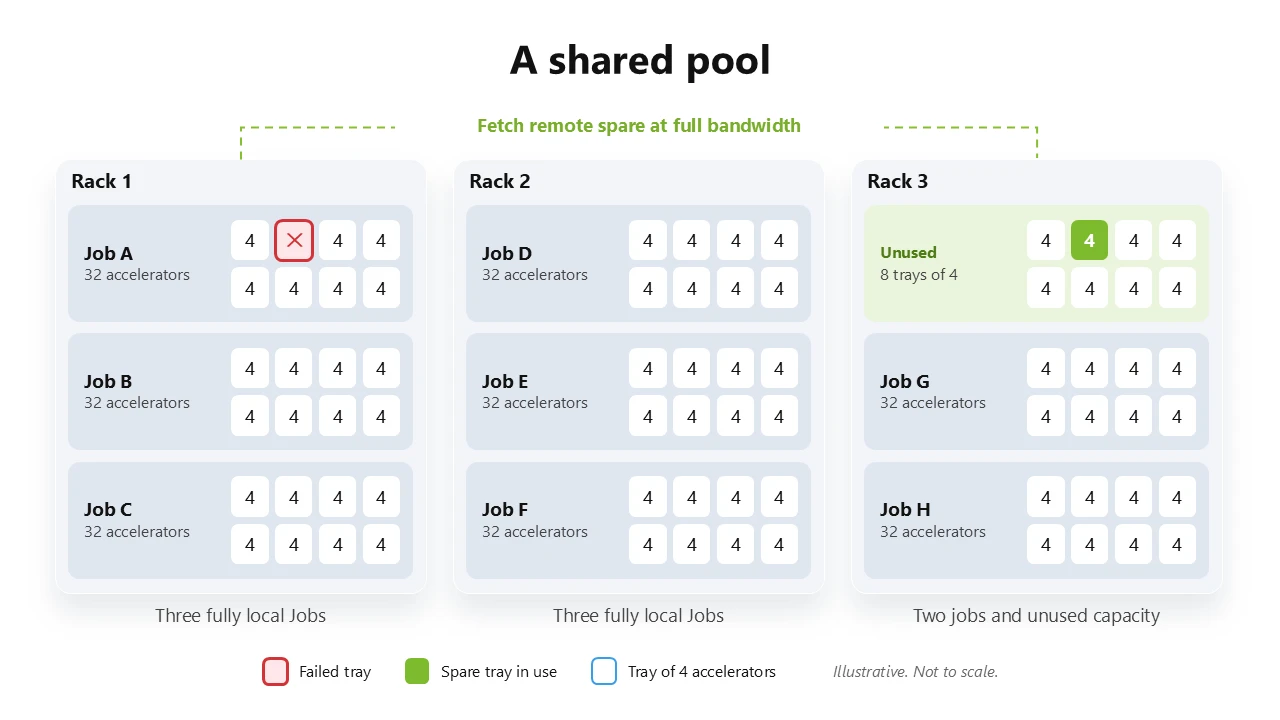
灵活作业放置、分离式推理与跨机架弹性。张量并行保持在96加速器机架内,更宽的专家并行与流水线并行跨机架;作业可跨机架边界使用容量,减少负载尺寸与物理机架配置不匹配时的闲置加速器。prefill与decode worker可独立尺寸化与放置,prefill计算完成后,KV状态直接通过同一scale-up fabric搬移到选定的decode worker,而非通过主机中介的scale-out路径离开域。加速器不可用时,调度器可透明使用另一机架的热备容量,负载留在scale-up fabric上,以额外路径延迟换取可用性与资源利用率。
以下两图展示了跨机架作业放置与跨机架热备:
系统扩展
在数据中心规模,效率取决于在固定功耗与散热包络内能部署和运营多少有用基础设施。Maia 300的机架协同设计服务器布局与密度、网络拓扑与交换、供电与散热、以及高级遥测,实现相比Maia 200 2.5倍以上的性能/瓦。其系统层级从硅片到集成托盘再到机架与散热,逐级协同。
下图展示了Maia 300的系统三层级:
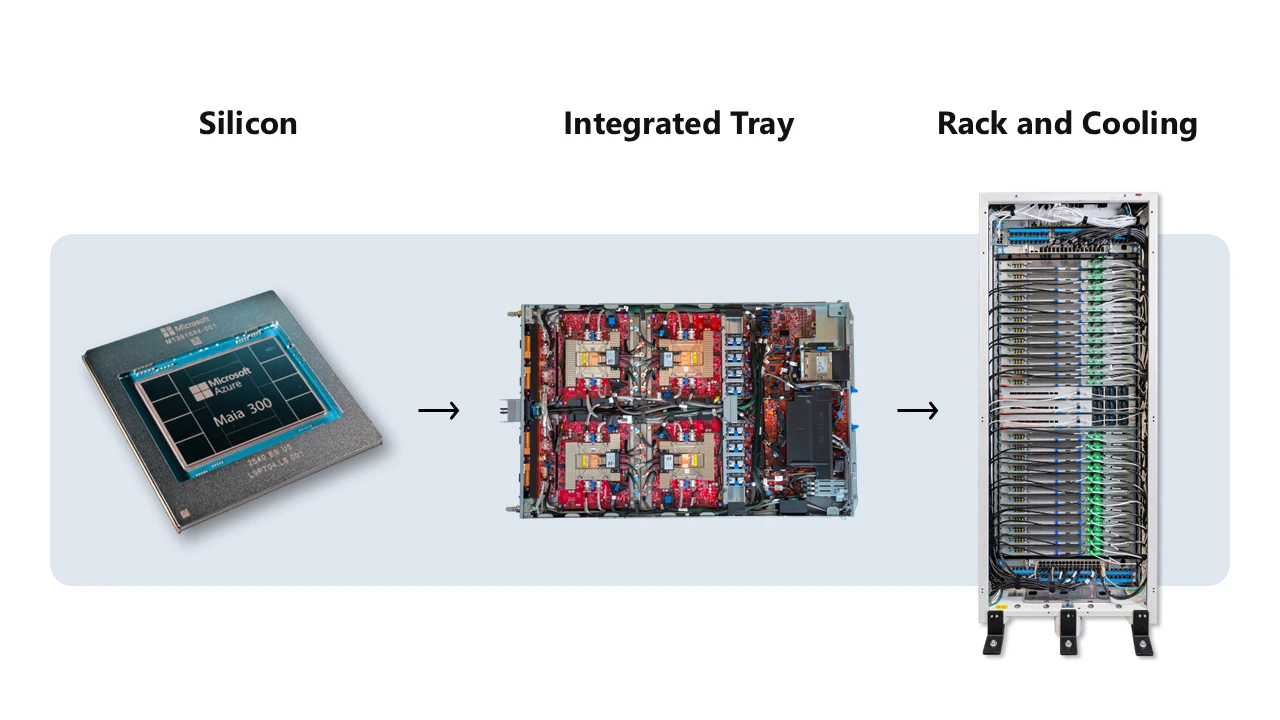
Maia 300在167kW机架内集成96颗加速器,分布在24个四加速器托盘中,加速器密度翻倍。每个托盘包含四颗加速器及主机处理器、内存、存储与散热,取消独立主机托盘释放了机架空间,允许功耗与热资源作为统一系统管理。6个高基数交换ASIC集成到3个液冷交换托盘中,提供全部机架本地连接;50V母线架构与双路供电、集成机架自动转换开关(ATS)保证高可用;液冷移除超过80%的机架热负载(加速器、稳压器、交换ASIC),风冷支持内存、存储等辅助组件,可直接连接设施水或通过热交换器在风冷环境中散热。
下图展示了Maia 300机架架构与两代机架级规格对比:
机架与行级功耗遥测与数据中心运营连接,使工作点可根据可用功耗与散热容量管理;数据驱动算法动态分配功耗并优化负载放置与部署密度,提升利用率与每瓦token产出。可靠性、可用性、可服务性(RAS)、可观测性、可调试性、故障处理与冗余均基于部署经验强化。对比Maia 100的”设计700W/部署500W”与”液冷使能”,Maia 300的167kW液冷机架在三年内完成了从”预留能力”到”依赖液冷”的跨越——第一代的技术选项,第三代成了刚性前提。
性能总结
Maia 300相比Maia 200实现最多7倍的机架级token吞吐提升,以及2.5倍以上的性能/瓦。它带来更高的每瓦内存带宽与每机架翻倍的加速器数,同时基于SDLA软件定义数据流架构与两层scale-up网络,支持从内核到数据中心规模的单一编程模型。
需要强调的是,Maia 300并未通过简单堆砌功耗与面积换取性能——单芯片FP4算力仅提升36%、TDP从750W增至950W,而HBM带宽、容量、每瓦效率与网络规模的提升更为显著。性能提升的真正来源,是围绕数据搬移、局部性、精度与内存效率的架构创新。
参考文献
- S. Xu, C. Ramakrishnan, “Inside Maia 100,” Hot Chips 36 Symposium (HCS), 2024. 幻灯片
- S. Xu, C. Ramakrishnan, “Inside Maia 100: Revolutionizing AI Workloads with Microsoft’s Custom AI Accelerator,” Microsoft Azure Infrastructure Blog, Aug. 2024. Link
- Microsoft, “Azure Maia for the era of AI,” Microsoft Azure Blog, 2024. Link
- S. Xu, M. Heddes, J. Peng, et al., “Maia 200: A Software Defined Dataflow System for Large-scale AI Acceleration,” arXiv:2608.24664, Aug. 2026. arXiv
- S. Dighe, A. Levin, “Deep dive into the Maia 200 architecture,” Microsoft Azure Infrastructure Blog, Jan. 2026. Link
- S. Xu, P. Ranjan, T. Hoefler, “Maia 200: Software-defined dataflow and all-Ethernet networking for efficient inference on Azure,” Microsoft Azure Infrastructure Blog, Aug. 2026. Link
- Microsoft, “Maia 200: The AI accelerator built for inference,” Microsoft Blog, Jan. 2026. Link
- R. Borkar, S. Dighe, “Deep dive into Azure Maia 300 architecture,” Microsoft Azure Blog, Oct. 2026. Link
- Microsoft, “Azure Maia 300 product announcement,” Oct. 2026. Link
- Ultra Ethernet Consortium, “Ultra Ethernet Specification.” Link
- M. J. Flynn, “Some Computer Organizations and Their Effectiveness,” IEEE Transactions on Computers, vol. C-21, no. 9, pp. 948-960, Sep. 1972.